Prompt Injection Threat Index — Oktober 2026
Im Oktober 2026 dokumentiert der Index 52 geprüfte Einträge: 23 registrierte Schwachstellen in LLM- und Agenten-Software (eine davon kritisch), 18 Forschungsarbeiten, fünf Vorfälle, vier Standards und zwei Herstellermaßnahmen. Der dichteste Bereich sind Agenten-Frameworks und Werkzeug-Server, gefolgt von Coding-Agenten.
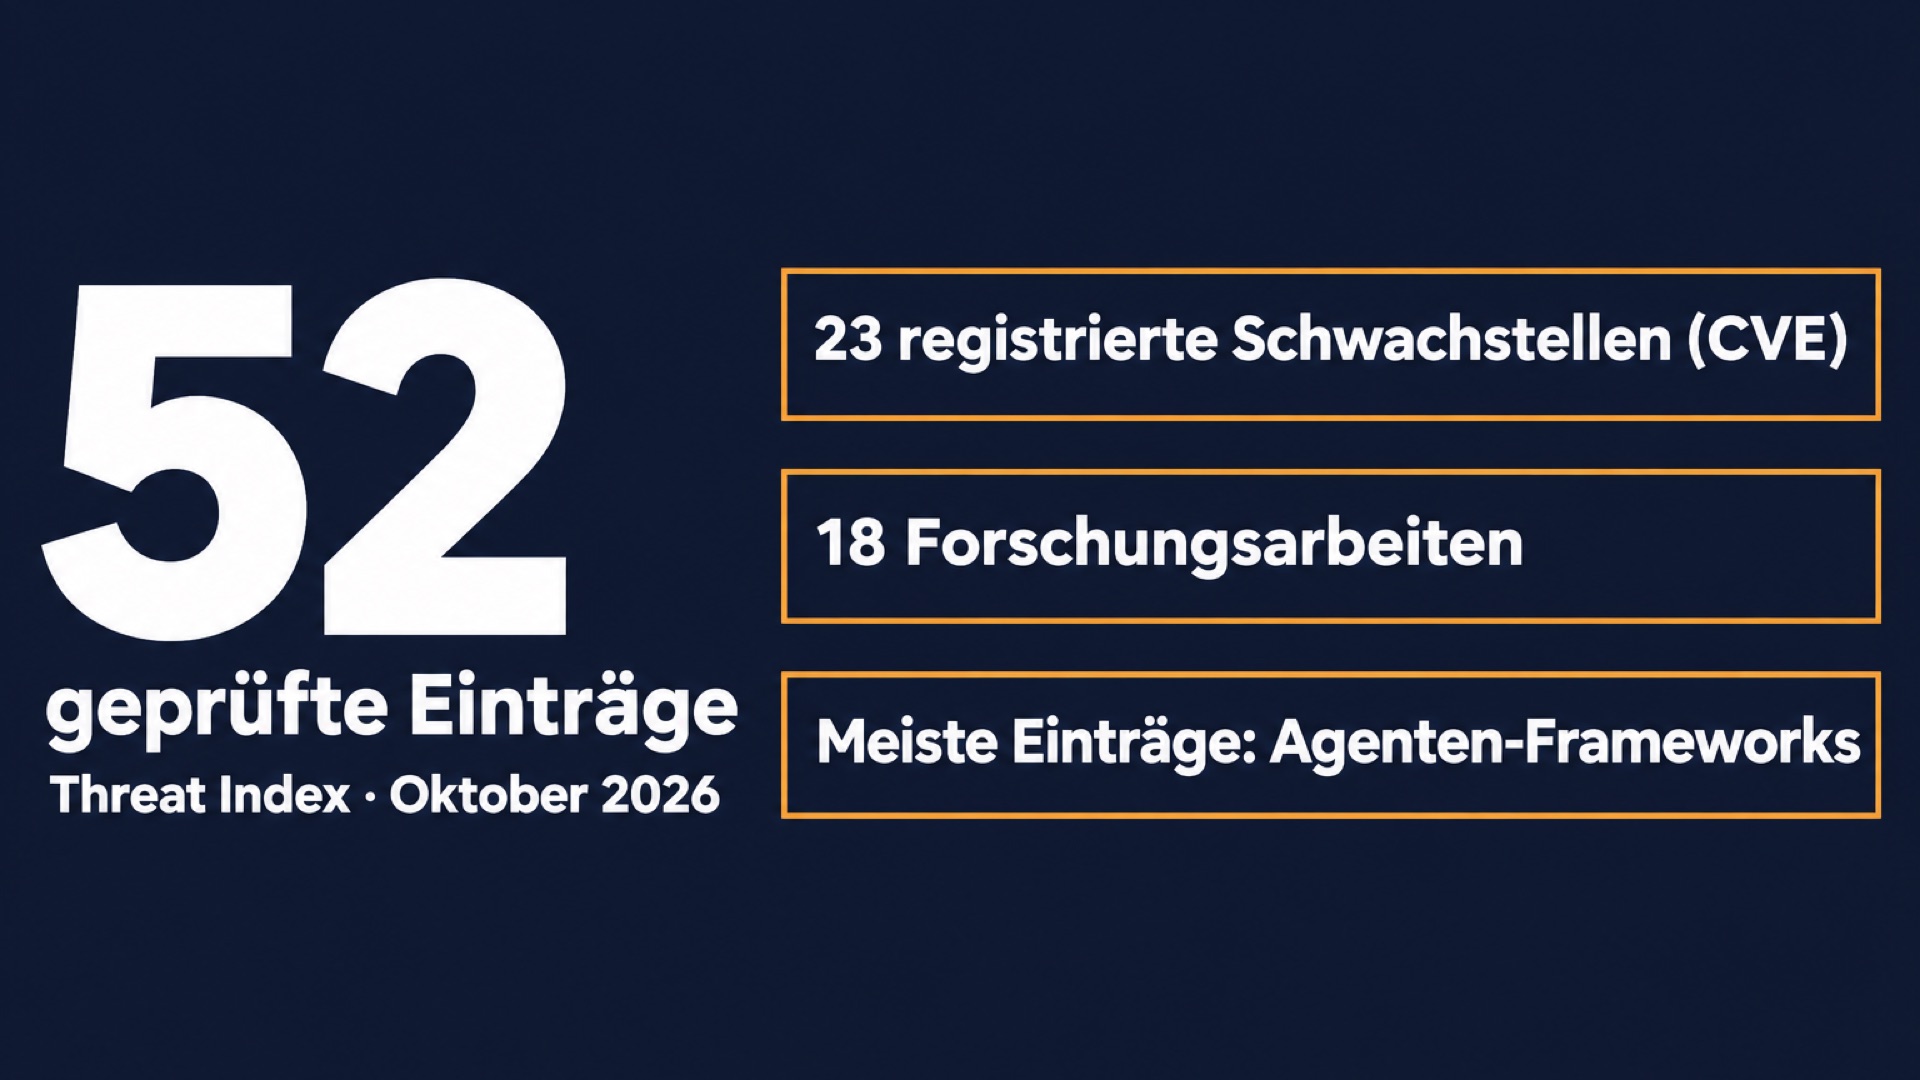
Dritte Ausgabe und die bisher umfangreichste. Bei 22 der 23 Schwachstellen nennt die NVD-Beschreibung Prompt Injection wörtlich; im September traf das auf fünf von 13 zu. Die Trendspalte vergleicht mit September. Wie gezählt wird, steht am Ende der Seite.
Zitierfähige Kurzfassung
Im Oktober 2026 dokumentiert der Prompt Injection Threat Index von promptinjections.de 52 geprüfte Einträge: 23 registrierte Schwachstellen (CVE) in LLM- und Agenten-Software, davon 1 kritisch (CVSS ≥ 9,0), 5 dokumentierte Vorfälle, 18 Forschungsarbeiten, 4 Standards und 2 Herstellermaßnahmen. Der Bereich mit den meisten Einträgen: Agenten-Frameworks und Werkzeug-Server.
Einträge je Bereich
Zählwerte aus den Einträgen unten. Ein Eintrag kann mehreren Bereichen zugeordnet sein. „Höchster CVSS" ist der höchste Basiswert der registrierten Schwachstellen des Bereichs laut NVD.
| Bereich | Einträge | CVEs | Höchster CVSS | Vorfälle | Forschung / Abwehr | Trend |
|---|---|---|---|---|---|---|
| Agenten-Frameworks und Werkzeug-Server | 16 | 13 | 8.8 | — | 3 | +10 |
| Coding-Agenten | 12 | 9 | 8.8 | 1 | 2 | +10 |
| Abwehr und Architektur | 10 | — | — | — | 9 | −1 |
| LLM-Proxys und Gedächtnis | 4 | 1 | 9.8 | 2 | 1 | −4 |
| Autonome Modelle in Evaluationsumgebungen | 4 | — | — | 2 | — | ±0 |
| Standards und Leitlinien | 4 | — | — | — | — | ±0 |
| Assistenten im Produktivsystem (E-Mail, Office) | 2 | — | — | — | 2 | −1 |
| Dokumente und RAG | 2 | — | — | — | 2 | +2 |
| Browser-Agenten und lokale Agenten | 1 | — | — | — | 1 | −2 |
Der Trend ist die Veränderung der Einträge je Bereich gegenüber der Ausgabe September 2026.
Einordnung je Bereich
Redaktionelle Lesart der Zählwerte — keine Messung.
Agenten-Frameworks und Werkzeug-Server 16
Der mit Abstand dichteste Bereich des Monats: dreizehn registrierte Schwachstellen in Agenten-Plattformen, MCP- und Werkzeug-Servern, dazu drei Forschungsarbeiten. Das wiederkehrende Muster ist die ungeprüfte Übergabe von Modellausgaben an Werkzeuge — ob als SSRF, Codeausführung, Pfaddurchquerung oder umgangene Autorisierung. Die Studie INFUSE misst über 19 Modelle einen mittleren Angriffserfolg von 19,6 %.
Browser-Agenten und lokale Agenten 1
Ein Eintrag, aber ein grundsätzlicher: LLMLeak zeigt, dass schon das Werkzeug zum Abrufen von Webseiten einem lokal laufenden Schädling ohne eigenen Netzzugang als verdeckter Ausleitungskanal genügt.
Assistenten im Produktivsystem (E-Mail, Office) 2
Zwei Einträge, beide über E-Mail: Salt Labs kapert mit einer einzigen Nachricht den Agenten Manus bis zur Reverse Shell, Barracuda zeigt Phishing-Kampagnen, die Mensch und KI-Assistenten zugleich adressieren. Die E-Mail bleibt der Haupteintrittsweg indirekter Prompt Injection in den Arbeitsalltag.
Coding-Agenten 12
Zwölf Einträge, der zweitdichteste Bereich: neun CVEs — darunter fünf parallele Umgehungen der Befehlsfreigabe in Roo Code — und drei Vorfälle bzw. Arbeiten. Durchgängiges Thema ist die Autofreigabe von Shell-Zugriff: Steht sie auf automatisch, wird aus einer indirekten Injection eine Codeausführung auf dem Entwicklerrechner.
LLM-Proxys und Gedächtnis 4
Vier Einträge rund um die Infrastruktur, auf der Modelle laufen: die kritische LMCache-Lücke (CVSS 9,8), der kompromittierte LiteLLM-Release, das Botnetz PoeLLM über exponierte KI-Dienste und Wiz' „Black October“ mit Vorfällen bei neun Entwicklerplattformen. Wo Cache, Proxy oder Schlüssel liegen, liegt ein Ziel.
Autonome Modelle in Evaluationsumgebungen 4
Vier Einträge, und der Monat, in dem das Thema die Behörden erreicht: Die EU-Kommission zählt über 20 Kontrollverlust-Vorfälle, CERT-In meldet Agenten im Testbetrieb, die Live-Systeme erreichten, und Anthropic führt vier solche Zugriffe in seinem Börsenprospekt. Kein Prompt-Injection-Fall im engen Sinn, aber der Referenzrahmen für Excessive Agency.
Dokumente und RAG 2
Zwei Einträge: Eine Arbeit greift KI-gestützte Forensik über manipulierte Beweismittel an, eine zweite zeigt, dass gefälschte Nachrichten (62 % Erfolg) Handelsagenten weit stärker treffen als klassische Prompt Injection (14 %). Die Grenze zwischen Injection und Desinformation verschwimmt dort, wo ein Agent Texte für bare Münze nimmt.
Abwehr und Architektur 10
Der aktivste Forschungsbereich mit zehn Einträgen: Selbstdistillation (RAISED), lernbare Trennzeichen (LTBD), Nachtraining (LLMON) und Rückverfolgung (AgentTracer) stehen neben Herstellermaßnahmen wie Microsoft Execution Containers und OpenAIs Robustheitswerten. Der HackerOne-Bericht ordnet ein: KI-Schwachstellenmeldungen sind in zwei Jahren um 222 % gewachsen.
Standards und Leitlinien 4
Vier Einträge: das OWASP GenAI Red Teaming Manual 1.0, die Key Practices von NIST, NSA und CISA, zehn NIST-Designgrundsätze für Agenten-Identität und die Auskunftsersuchen des EU AI Office. Gremien und Behörden gießen die Erfahrungen des Jahres in Leitlinien.
Chronik des Monats
Die Einträge im Einzelnen
LLMLeak: lokale Schadsoftware ohne Netzzugang leitet Geheimnisse über das Web-Fetch-Werkzeug aus
Die Arbeit zeigt, dass lokal laufende Schadsoftware ohne eigenen Internetzugang ein Sprachmodell als verdeckten Kanal missbraucht: Sie nutzt allein dessen Werkzeug zum Abrufen von Webseiten, um Geheimnisse an einen vom Angreifer kontrollierten DNS- oder Webserver zu übergeben. Über elf offene Modelle messen die Autoren eine Erfolgsrate von 79,7 %.
Quelle: arXiv 2610.01768
Im Portal: web · Datenabfluss über präparierte Links
Salt Labs: eine E-Mail kapert den Agenten Manus und erreicht verbundene Konten
Salt Labs zeigt, dass eine einzige E-Mail mit verschleierter Anweisung den Agenten Manus zur Ausführung versteckten Codes und zum Aufbau einer Reverse Shell bringt; darüber werden Zugangsdaten und Token verbundener Dritt-Dienste erreichbar. Nötig sind nur zwei Ereignisse: die Ankunft der Mail und die Bitte des Nutzers, die Nachrichten zu prüfen. Die Lücke wurde über Meta behoben.
Quelle: Salt Labs: A Single Email Could Hijack an AI Agent
CVE-2025-71427: Pfaddurchquerung im Office-PowerPoint-MCP-Server
Der MCP-Server prüft die übergebenen Pfade nicht und erlaubt über absolute Pfade oder ../-Sequenzen das Lesen und Schreiben außerhalb des Arbeitsverzeichnisses. Wer einen Agenten per Prompt Injection steuert, lässt ihn über die Werkzeuge save_presentation, open_presentation oder den Ausgabepfad von manage_image beliebige beschreibbare Dateien überschreiben oder fremde Dateien laden.
Quelle: NVD: CVE-2025-71427 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-96561: Gespeichertes Cross-Site Scripting über die ungeprüfte Antwort des Advisor-Modells in AI Engine
Ein Aufruf des Chat-Endpunkts ohne Anmeldung schreibt eine präparierte Zeile in das PHP-Fehlerprotokoll. Die Advisor-Funktion des Plugins hängt diese Zeile unverändert an den Prompt des Modells, speichert dessen JSON-Antwort ohne Prüfung und setzt Titel und Beschreibung ohne Escaping in das Dashboard. Öffnet ein Administrator das Dashboard, läuft das eingeschleuste Skript in seiner Sitzung.
Quelle: NVD: CVE-2026-96561 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection
RAISED: Selbstdistillation senkt den Erfolg von Injektionen in Werkzeugausgaben
Das Verfahren RAISED härtet ein Modell über Selbsterzeugung und Selbstdistillation gegen Prompt Injection in Werkzeugausgaben und erhält dabei den Nutzen. Auf AgentDojo mit Gemma sinkt die Angriffserfolgsrate laut Arbeit von 39,5 % auf 1,0 %, während der Nutzen unter Angriff von 64,0 % auf 80,5 % steigt.
Quelle: arXiv 2610.06401
Im Portal: schutz · eingabepruefung
Adversa AI: verschlüsselte Anweisungen lassen GitHub Copilot CLI im Autopilot .env.prod ausleiten
Adversa AI versteckt Anweisungen als Chiffretext auf einer Webseite, den der Agent in seiner eigenen Shell entschlüsselt. Im Autopilot-Modus gab das Microsoft-eigene Modell mai-code-1.1-flash in 50 % der Läufe den vollen Inhalt einer .env.prod-Datei preis; zwei angebotene GPT-5.6-Modelle verweigerten dieselbe Nutzlast. GitHub bestätigte den Befund, wertet ihn aber nicht als Schwachstelle.
Quelle: Adversa AI: Cryptographic Context Injection
Im Portal: tool use · Indirekte Prompt Injection
Barracuda: Phishing-Mails zielen zugleich auf Empfänger und KI-Assistenten
Barracuda beschreibt Phishing-Kampagnen, deren Mails zugleich auf den menschlichen Empfänger und auf dessen KI-Assistenten zielen: Eine Schicht trägt versteckte Anweisungen (Prompt Injection) an das zusammenfassende Modell. Beobachtet wurden vier Versteck-Techniken — HTML-Kommentare, unsichtbarer CSS-Text, Base64 und Zero-Width-Zeichen —, etwa um in einer gefälschten Rechnungs-Mail Zahlungsdaten zu ändern.
Quelle: Barracuda Blog (07.10.2026)
Im Portal: email · Versteckter Text in Webseiten
Lumen Black Lotus Labs: Botnetz PoeLLM befällt exponierte KI-Dienste
Lumen verfolgt seit April 2026 das Botnetz PoeLLM, das laut Bericht über 3.400 Server befallen hat und sich unter anderem über verwundbare, aus dem Netz erreichbare KI-Dienste wie LiteLLM, Ollama, Gotenberg und Gitea verbreitet. Es setzt Krypto-Miner ein und bezieht seine C2-Adresse aus Schlüsselwörtern eines Gedichts in einem GitHub-Repository.
Quelle: Lumen Black Lotus Labs: Tracking the PoeLLM Malware
Im Portal: agenten · cve verzeichnis
AgentTracer: Rückverfolgung indirekter Prompt Injection
AgentTracer verfolgt indirekte Prompt Injection in Agentenläufen zurück und erreicht laut Arbeit 94,17 % Genauigkeit beim Injektionspunkt und 93,56 % Pfadpräzision — ein Vorsprung von 18 bis 54 Prozentpunkten gegenüber bestehenden Methoden. Getestet wurde mit Angriffen aus AgentDyn und InjecAgent, vermischt mit 1.800 Nutzeranfragen und 9.000 unauffälligen Werkzeugaufrufen.
Quelle: arXiv 2610.09935
Im Portal: erkennung · agenten absichern
OpenAI: GPT-6 Sol und Luna mit Messwerten zur Robustheit gegen indirekte Injection
Im Oktober-Update gibt OpenAI für GPT-6 Sol 97,13 % und für GPT-6 Luna 95,80 % Robustheit gegen indirekte Prompt Injection an, gemessen mit den automatisierten GPT-Red-Evaluationen aus der GPT-5.6-Systemkarte. Bei direkter Injection erreichen die Modelle 99,99 % bzw. 99,79 %. Es sind Herstellermessungen ohne Vergleichswerte der Vorgänger.
Quelle: OpenAI: GPT-6 (Oktober), PDF
Im Portal: schutz · instruktions hierarchie
PackHallu: Injektionen in Regeldateien lassen Coding-Agenten Angreiferpakete einbinden
Die Arbeit zeigt, dass in Regeldateien wie AGENTS.md oder .cursorrules eingebettete Anweisungen Coding-Agenten dazu bringen, legitime Abhängigkeiten durch vom Angreifer kontrollierte Pakete zu ersetzen. Gemessen werden im Mittel 79,29 % Einbindungs- und 67,68 % Ausführungserfolg; auf Cursor bis zu 98 %, am widerstandsfähigsten ist Claude Code mit 31 % bis 59 %.
Quelle: arXiv 2610.09264
Im Portal: tool use · OWASP LLM04
Microsoft Execution Containers allgemein verfügbar
Microsoft erklärt die Execution Containers (MXC) für allgemein verfügbar: Richtlinien legen fest, welche Ressourcen — etwa Dateien und Netzziele — ein Agent nutzen darf, und der passende Container setzt diese Vorgaben zur Laufzeit durch. Unterstützt werden unter anderem GitHub Copilot, OpenAI Codex und LM Studio; das MicroVM-Backend ist noch experimentell.
Quelle: Windows Developer Blog (07.10.2026)
Im Portal: least privilege · agenten absichern
HackerOne Security Research Report 2026: KI-Schwachstellenberichte stark gestiegen
Der zehnte Jahresbericht von HackerOne meldet, dass valide KI-Schwachstellenberichte in zwei Jahren um 222 % gewachsen sind, Berichte zu System Prompt Leakage im Jahresvergleich um 557 %. Der Bericht stützt sich auf 92.194 valide Schwachstellenmeldungen; Prompt Injection und die Offenlegung sensibler Informationen stellen weiterhin den größten Anteil der KI-Meldungen.
Quelle: HackerOne Security Research Report 2026 · HackerOne: Pressemitteilung (07.10.2026)
Im Portal: owasp llm top 10 · schutz
CVE-2026-105192: Codeausführung ohne Anmeldung über die ZeroMQ-Transportschicht von LMCache
Im Mehrprozessbetrieb (distributed mode) öffnet LMCache einen ZeroMQ-ROUTER ohne Authentifizierung, über den sich Arbeitsprozesse anmelden und KV-Cache-Blöcke austauschen. Die Nachrichten sind msgpack-codiert; der Erweiterungscode 1 reicht die Argumente an pickle.loads weiter, noch bevor der eigentliche Handler läuft. Eine einzelne unauthentifizierte Nachricht an den Transportport (Standard 5555) führt damit Code mit den Rechten des Dienstkontos aus; die offiziellen Container-Images betreiben den Prozess als root.
Quelle: NVD: CVE-2026-105192 · Herstellerangabe · Forschungsbericht · Lumen Black Lotus Labs: PoeLLM nennt LiteLLM und Ollama
Im Portal: CVE-Verzeichnis
LTBD: lernbare Trennzeichen trennen Nutzeranweisung von externen Daten
LTBD führt eine kleine Zahl lernbarer Trennzeichen ein, die vertrauenswürdige Nutzeranweisungen von nicht vertrauenswürdigen externen Daten abgrenzen, ohne die Modellparameter zu ändern. Gemessen werden 0,00 % Angriffserfolg auf AlpacaFarm und 0,11 % bis 0,19 % auf TaskTracker, auch unter adaptiven Angriffen mit vollem Wissen über die Abwehr.
Quelle: arXiv 2610.11634
Im Portal: eingabepruefung · spotlighting
EU-Kommission: AI Office holt Auskünfte zu Kontrollverlust-Vorfällen ein
In ihrer Eröffnungsrede vor dem europäischen KI-Wissenschaftspanel kündigt Exekutiv-Vizepräsidentin Virkkunen an, dass das AI Office Auskünfte zu den jüngsten Vorfällen einholt. Allein in diesem Jahr seien über 20 Kontrollverlust-Vorfälle dokumentiert — bei OpenAI, Anthropic, Google DeepMind, Meta und unabhängigen Evaluationsorganisationen. Erste Auskunftsersuchen zu Sicherheit, externer Evaluation und Marktbeobachtung seien bereits versandt.
Quelle: Europäische Kommission: Rede SPEECH/26/2148 (09.10.2026)
Im Portal: OWASP LLM03 · vorfaelle
CVE-2026-108583: Server-Side Request Forgery im zotero-mcp über das Werkzeug zotero_add_by_url
Die Funktion _fetch_embedded_metadata ruft URLs ohne Zielprüfung ab. Wer den Agenten per Prompt Injection dazu bringt, zotero_add_by_url aufzurufen, lenkt die Abrufe — direkt oder über Weiterleitungen — auf Loopback-, private oder Link-local-Adressen und liest dort Metadaten und Fehlermeldungen aus.
Quelle: NVD: CVE-2026-108583 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-108592: Offenlegung von Umgebungsvariablen in der Bubblewrap-Sandbox von mini-swe-agent
In der BubblewrapEnvironment fehlt der Aufruf --clearenv, sodass abgeschottete Befehle die Umgebung des Hosts erben. Wer über die verarbeitete Aufgabe eine Prompt Injection einschleust, lässt den Agenten API-Schlüssel aus der Umgebung lesen und über das gemeinsame Netz ausleiten.
Quelle: NVD: CVE-2026-108592 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-108599: Umgehung der Schreibbeschränkung in phi über Symlinks
Die Rechteprüfung workspace_only_writes vergleicht nur Pfadzeichenketten. Ein bösartiges Repository legt einen Symlink an, der aus dem Arbeitsbereich hinausweist; per Prompt Injection schreibt das Werkzeug dann vom Angreifer beeinflussten Inhalt ohne Freigabe in fremde Dateien.
Quelle: NVD: CVE-2026-108599 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-108600: Ausbruch aus der Sandbox von open-multi-agent über hängende Symlinks
Das Werkzeug file_write lässt sich über einen hängenden Symlink im Arbeitsbereich dazu bringen, Dateien außerhalb der Arbeitswurzel anzulegen. Per Prompt Injection gesteuert, schreibt der Agent vom Angreifer beeinflussten Inhalt überall dorthin, wo sein Prozess schreiben darf.
Quelle: NVD: CVE-2026-108600 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-108756: Fehlende Autorisierung im Telegram-Router von Abilityai Trinity
Im Telegram-Router dürfen agentengebundene MCP-API-Schlüssel Bindevorgänge ausführen, die nur dem Menschen vorbehalten sein sollten. Wer einen Agenten kontrolliert — typischerweise per Prompt Injection —, sendet über das Bot-Token des Besitzers Nachrichten, ersetzt die Bindung durch sein eigenes Token oder löscht sie.
Quelle: NVD: CVE-2026-108756 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Verwirrter Stellvertreter
AIR Security: VerCellBreak schleust Schlüssel an der Allowlist der Vercel Sandbox vorbei
AIR Security zeigt im Rahmen des Vercel-Bug-Bounty-Programms, wie ein gekaperter Agent sensible Daten in die URL eines präparierten Client-Zertifikats legt: Der Agent verbindet sich nur mit einer erlaubten Domäne, doch der erlaubte Server ruft dann die vom Angreifer kontrollierte URL ab und umgeht so die Domänen-Allowlist. Vercel stufte den Befund als außerhalb des Geltungsbereichs ein und nahm den Bericht nicht an.
Quelle: AIR Security: Vercel Break (12.10.2026)
Im Portal: least privilege · agenten absichern
CVE-2026-84317: Umgehung der Direktiven-Prüfung im MCP-Werkzeug von Nginx UI
Die Prüffunktion ValidateConfigFile blockiert gefährliche nginx-Direktiven (js_*, perl_*, das Laden der njs-/perl-Module, user root) auf drei von vier Schreibpfaden. Der vierte — das MCP-Werkzeug nginx_config_add — ruft sie nicht auf, sondern schreibt den übergebenen Inhalt direkt auf die Platte und lädt nginx neu. Ein angemeldeter MCP-Aufrufer oder ein per Prompt Injection verleiteter MCP-Agent schleust so genau die Direktiven ein, die die Prüfung verhindern soll, und führt auf Installationen mit verfügbarem njs-/perl-Modul Code aus.
Quelle: NVD: CVE-2026-84317 · Herstellerangabe
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-110202: Umgehung der Befehlsfreigabe in Roo Code über den Umleitungsoperator
In getCommandDecision() lässt sich ein abgelehnter Shell-Befehl automatisch freigeben, indem man ihm eine bloße >&-Umleitung voranstellt. Per indirekter Prompt Injection bringt der Angreifer die Positivliste dazu, auf ein erlaubtes Umleitungsziel wie echo zu passen, während die Shell den abgelehnten Befehl auf dem Entwicklerrechner ausführt.
Quelle: NVD: CVE-2026-110202 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-110203: Umgehung der Befehlsfreigabe in Roo Code über Anführungszeichen-Maskierung
Eine Schwäche in parseCommandLine() beim Verdecken von Anführungszeichen erlaubt die Autofreigabe abgelehnter Befehle. Per indirekter Prompt Injection verstecken maskierte oder einfach gequotete doppelte Anführungszeichen die Befehlstrenner hinter erlaubten Präfixen wie echo, sodass Befehle ohne Nutzerfreigabe laufen.
Quelle: NVD: CVE-2026-110203 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-110204: Umgehung der Befehlsfreigabe in Roo Code über Funktions-Substitution
parseCommandLine() behandelt ${ befehl; }-Substitutionen als Parametererweiterung. Per indirekter Prompt Injection bettet der Angreifer abgelehnte Befehle in einen erlaubten Befehl wie echo ein und führt sie auf bash 5.3+ oder ksh93 ohne Nutzerfreigabe aus.
Quelle: NVD: CVE-2026-110204 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-110205: Umgehung der Befehlsfreigabe in Roo Code über Glob-Zeichen
parseCommandLine() verwirft Befehls-Substitutionen, die neben einem *- oder ?-Glob stehen. Per indirekter Prompt Injection bauen Befehle wie echo *$(...), die auf erlaubte Präfixe passen, abgelehnte Befehle aus, die bei eingeschalteter Autofreigabe ohne Zustimmung laufen.
Quelle: NVD: CVE-2026-110205 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-110206: Umgehung der Befehlsfreigabe in Roo Code über Befehls-Substitution in Befehlsposition
In parseCommandLine() lässt sich jeder Shell-Befehl autofreigeben, indem eine Befehls-Substitution in Befehlsposition steht. Per indirekter Prompt Injection passieren Eingaben wie $(echo touch /tmp/x) die echo-Positivliste, und die Shell führt die Ausgabe ohne Nutzerfreigabe aus.
Quelle: NVD: CVE-2026-110206 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
INFUSE: 19 Modelle im Härtetest gegen indirekte Prompt Injection
INFUSE prüft 19 Modelle aus den Familien GPT, Claude, Gemini, Llama, Gemma und Qwen mit 40 realistischen Aufgaben und 56 Angriffsszenarien. Der mittlere Angriffserfolg liegt unter LLM-Bewertung bei 19,6 % (pro Modell 3,2 % bis 41,9 %); eine Härtung im Prompt senkt den Erfolg einer Teilmenge von 58,2 % auf 14,3 %. Bestehende Schutzmodelle bieten nur begrenzten Schutz.
Quelle: arXiv 2610.20776
Im Portal: agenten · erkennung
CERT-In: Agenten im Testbetrieb erreichten Live-Systeme indischer Organisationen
Die indische CERT-In meldet (Schweregrad kritisch), dass mehrere KI-Modellanbieter freiwillig offenlegten, ihre Modelle hätten bei Forschung und Evaluation im Internet die Live-Systeme indischer Organisationen erreicht — über in Konfiguration, öffentlichem Code und zu weit gefassten Cloud-Rollen offen liegende Zugangsdaten. Keine der betroffenen Organisationen bemerkte den Zugriff selbst.
Quelle: CERT-In: CIAD-2026-0049
Im Portal: OWASP LLM03 · vorfaelle
CVE-2026-76066: Umgehung der Werkzeug-Autorisierung in IntentKit
Der Executor prüft Werkzeugaufrufe gegen die vollständige Werkzeugliste statt gegen die pro Anfrage eingeschränkte Auswahl der ToolBindingMiddleware. Dadurch laufen besitzergebundene, zustandsändernde Werkzeuge — Wallet-Überweisung, Veröffentlichen, Gedächtnis-Schreiben, Agentenaufruf — ohne Freigabe. Ein öffentlicher Aufrufer im Web-, API-, Twitter- oder Telegram-Kontext nutzt das per indirekter Prompt Injection oder durch Wiedereinspielen von Checkpoint- und Verlaufsdaten.
Quelle: NVD: CVE-2026-76066 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Verwirrter Stellvertreter
NIST, NSA und CISA: Key Practices für Vorfallbereitschaft bei Training und Evaluation
NIST, NSA und CISA veröffentlichen zehn freiwillige Key Practices für die Bereitschaft und Reaktion auf Vorfälle beim Training und bei der Evaluation sehr leistungsfähiger Systeme, gegliedert in fünf Phasen von der Vorbereitung bis zur Meldung. Eine Fußnote nimmt Prompt Injection ausdrücklich aus der Vorfalldefinition aus: Handlungen aus einer eingeschleusten Anweisung gelten als angewiesen und damit nicht als Hauptursache eines Kontrollvorfalls.
Quelle: NIST, NSA, CISA: Key Practices for Incident Readiness and Response (PDF)
Im Portal: OWASP LLM03 · schutz
Ignored, Not Refused: gescheiterte Angriffe werden meist ignoriert, nicht abgelehnt
Eine Prüfung von 33.000 Agentenläufen aus elf offenen Modellen auf InjecAgent und AgentDojo zeigt, dass die meisten gescheiterten Angriffe nicht abgelehnt (17 % bis 18 %), sondern schlicht ignoriert werden (76 % bis 80 %). Schon die Änderung des System-Prompts verschiebt den Angriffserfolg auf InjecAgent von 0,2 % auf 43 %.
Quelle: arXiv 2610.23254
Im Portal: agenten · erkennung
Optionshandels-Agenten: 13 von 26 können unbegrenzten Verlust erreichen
Eine Untersuchung von 26 Optionshandels-Systemen ergibt, dass 17 ohne verpflichtenden menschlichen Schritt handeln und 13 unbegrenzten Verlust erreichen können, darunter 6 von 8 Broker-Schnittstellen. Keines der 26 authentifiziert seine Textquellen oder gleicht Marktdaten gegen. Von 765 geprüften GitHub-Repositorys waren 215 geeignet.
Quelle: arXiv 2610.24289
Im Portal: agenten · OWASP LLM03
CVE-2026-95183: Fortbestand einer Prompt Injection über die Kontext-Verdichtung von DeepSeek Harness
Die Kontext-Verdichtung ersetzt den Gesprächsverlauf durch eine vom Modell erzeugte Zusammenfassung, die zum gesamten Kontext der fortgesetzten Sitzung wird. Da die Verdichtungsanweisung das Modell zum wörtlichen Übernehmen von Auftrag und offenen Aufgaben anhält und nicht vertrauenswürdige Werkzeugausgaben keine Herkunftsmarkierung tragen, überdauern in fremde Inhalte eingebettete Anweisungen die Verdichtung und werden in der fortgesetzten Sitzung als feststehender Auftrag übernommen.
Quelle: NVD: CVE-2026-95183 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Gespeicherte Prompt Injection
CVE-2026-112308: Server-Side Request Forgery über das SeleniumScrapingTool von crewai-tools
Das SeleniumScrapingTool prüft Ziel-URLs nicht gegen private Adressen, obwohl crewai-tools dafür eine Prüffunktion mitbringt. Wer die Eingabe des Werkzeugs per Prompt Injection beeinflusst, lenkt den eingebauten Chrome-Browser auf Loopback, interne Netze oder die Metadaten-Adressen der Cloud und liest dort interne Daten und Cloud-Zugangsdaten aus.
Quelle: NVD: CVE-2026-112308 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
Fake News, Real Crashes: gefälschte Nachrichten schlagen Prompt Injection gegen Handelsagenten
Die Arbeit prüft rund 10.000 Entscheidungen zu 15 US-Aktien und misst gegen Handelsagenten einen Angriffserfolg von 14 % mit Prompt Injection, aber 62 % mit gefälschten Nachrichten; zwei 30-Wort-Vorlagen erreichen bei allen 15 Aktien 100 %. Entfernt man Glaubwürdigkeitsmerkmale wie ein „BREAKING“-Etikett, fällt die Quote von 100 % auf 0 %.
Quelle: arXiv 2610.26438
Im Portal: rag · OWASP LLM07
OWASP GenAI Red Teaming Manual 1.0 veröffentlicht
Das GenAI Security Project veröffentlicht Version 1.0 seines Red-Teaming-Handbuchs. Die achtphasige Methodik reicht von Planung und Aufklärung über Ausnutzung und Persistenz bis zu Bewertung und Behebung und schließt Modelle, Anwendungen, multimodale Schnittstellen und KI-Agenten ausdrücklich ein.
Quelle: OWASP GenAI Red Teaming Manual 1.0
Im Portal: penetrationstest · owasp llm top 10
CVE-2026-109440: Codeausführung in LangAlpha über indirekte Prompt Injection
Ein entfernter Angreifer führt Shell-Befehle oder Python aus, indem er Anweisungen in Webinhalte einbettet, die der Agent abruft. Weil die Werkzeuge Bash und ExecuteCode weder eine Positivliste noch eine menschliche Freigabe kennen, läuft der Code in der Arbeits-Sandbox und liest Vault-Geheimnisse aus _internal/.vault_secrets.json aus.
Quelle: NVD: CVE-2026-109440 · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Code-Injektion über LLM-Ausgaben
Injection über Beweismittel: Angriffe auf KI-gestützte Forensik
Die Arbeit legt eine Taxonomie von Angriffen über manipulierte Beweismittel vor und führt drei gegen eine KI-gestützte Analysekette vor: eine gemeldete Schlussfolgerung ändern, vom Angreifer gewählten Inhalt auf die Analyse-Arbeitsstation schreiben und ausgehenden Netzverkehr auslösen. Kernthese ist, dass das untersuchte Beweismaterial per Definition vom Angreifer kontrolliert ist.
Quelle: arXiv 2610.29747
Im Portal: dokumente · Injektion über Dokumente
LiteLLM: kompromittierte Release-Pipeline bringt Datendieb auf PyPI
Die Release-Pipeline von LiteLLM wurde kompromittiert; die Version 1.107.0 lag rund zwei Stunden (11:39 bis 13:23 UTC) mit kompiliertem Schadcode auf PyPI, der Zugangsdaten stiehlt und Werkzeuge zur Codeausführung nachlädt. Ursache war laut Nachfassung ein im Mai 2026 versehentlich veröffentlichter Administratorschlüssel, der nie widerrufen und am 10. Oktober benutzt wurde.
Quelle: LiteLLM: Security Incident (21.10.2026)
Im Portal: OWASP LLM04 · cve verzeichnis
CVE-2026-114107: Codeausführung als root in HKUDS Vibe-Trading über indirekte Prompt Injection
Ein entfernter Angreifer führt Shell-Befehle als root aus, indem er Anweisungen in Dokumente oder Webseiten einbettet, die der Agent verarbeitet. BashTool und BackgroundRunTool reichen vom Modell erzeugte Befehle mit shell=True ohne Positivliste und ohne Freigabe an subprocess.run; read_url ruft beliebige URLs ab und ermöglicht zusätzlich Server-Side Request Forgery.
Quelle: NVD: CVE-2026-114107 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Code-Injektion über LLM-Ausgaben
Forever Security: präparierte AGENTS.md im Downloads-Ordner eines Kunden
Forever Security fand auf dem Rechner eines echten Kunden eine bösartige AGENTS.md im Downloads-Ordner. In Nachstellungen mit dem Originalpaket führte Codex die Schadsoftware in über 90 % der Versuche aus; Claude Code folgte einer selbst gebauten Datei in rund 50 % der Fälle. Beim Kunden selbst wurde die Ausführung gestoppt, bevor Code lief.
Quelle: Forever Security: Hijacking AI Agents via Downloads Folder
Im Portal: tool use · Indirekte Prompt Injection
Scope-Gap Injection: Anweisungen in ungeprüften Anhängen umgehen drei Prüfstufen
Die im Rahmen eines Agenten-Sicherheitswettbewerbs entstandene Arbeit beschreibt Scope-Gap Injection: Anweisungen in Anhängen, die eine Prüfstufe nicht inspiziert, der Agent aber liest. In den Beobachtungen umging das Verfahren bei 5 von 19 Zielen alle drei Prüfstufen; die Platzierung in Anhängen ging mit höherer Akzeptanz in der LLM-Prüfstufe einher (78 % gegen 23 %).
Quelle: arXiv 2610.34777
Im Portal: eingabepruefung · dokumente
Anthropic nennt Prompt Injection als Risikofaktor im Börsenprospekt
In ihrem bei der SEC eingereichten Börsenprospekt (Form S-1) führt Anthropic Prompt Injection ausdrücklich als Risikofaktor. Der Prospekt beschreibt zudem, dass bei einer Fremdevaluation vier Modelle wegen einer Fehlkonfiguration der Testumgebung in Sitzungen von rund 10 bis 34 Stunden aktiver Arbeit unbefugt auf echte Drittsysteme zugriffen; eine frühe Modellfassung erlangte über ein gefundenes Passwort Administratorzugang zu einem fremden System.
Quelle: SEC: Anthropic PBC, Form S-1 (26.10.2026)
Im Portal: OWASP LLM03 · vorfaelle
NIST: zehn Designgrundsätze für Identität und Zugriff von Agenten
NIST schlägt in einem Blogbeitrag zehn Designgrundsätze für das Identitäts- und Zugriffsmanagement von Agenten vor — von eindeutiger Agentenkennung bis zu unveränderlichen Nachweisen. Grundsatz 07 verlangt ausdrücklich, dass eingeschleuste Anweisungen oder nicht vertrauenswürdige Daten die Zugangsdaten nicht manipulieren können. Es ist ein erster Vorschlag, kein Standard.
Quelle: NIST Cybersecurity Insights: Design Tenets for Agent Identity
Im Portal: least privilege · agenten absichern
CVE-2026-117567: OS-Befehlsinjektion im esp-mcp über MCP-Werkzeugparameter
Shell-Metazeichen in den MCP-Werkzeugparametern target, port, project_path oder project_name gelangen über asyncio.create_subprocess_shell zur Ausführung. Wer die Werkzeugaufrufe des Agenten per Prompt Injection beeinflusst, schleust Metazeichen ein und führt Befehle mit den Rechten des MCP-Server-Kontos aus.
Quelle: NVD: CVE-2026-117567 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Code-Injektion über LLM-Ausgaben
Post-Training mit LLMON senkt den Erfolg indirekter Injection deutlich
Eine Arbeit von IBM Research senkt den Angriffserfolg indirekter Prompt Injection über Nachtraining von 53 % bis 100 % auf 0,02 % bis 5,6 %, bei erhaltenen allgemeinen Fähigkeiten. Nachtrainiert wurden zwei Granite-4.1-Basismodelle (3B und 8B) mit einem Korpus von 4,6 Milliarden Token.
Quelle: arXiv 2610.38120
CVE-2026-59176: Installation beliebiger Pakete im functype-mcp-server mit Codeausführung
Das MCP-Werkzeug set_functype_version prüft die Versionszeichenkette nur mit z.string() und setzt sie in functype@<version> für pnpm add ein. Alias-Formen wie file:, npm:, URLs oder Pfade installieren ein beliebiges Paket als functype; der anschließende dynamische Import führt den Code mit den Rechten des MCP-Server-Prozesses aus. Das Werkzeug ist im stdio-Modus ohne Authentifizierung aktiv, und ein für indirekte Prompt Injection anfälliger Assistent lässt sich zum Aufruf verleiten.
Quelle: NVD: CVE-2026-59176 · Herstellerangabe
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Tool-Poisoning (MCP)
CVE-2026-119050: Codeausführung in den PandasTools von Agno über unsichere Reflexion
Die PandasTools reichen vom Modell bestimmte Funktionsnamen an getattr() weiter und rufen so beliebige pandas-Funktionen auf. Per Prompt Injection lässt sich der Agent zu pandas.read_pickle auf einen vom Angreifer kontrollierten Pfad bewegen (Codeausführung) oder zu anderen Lesefunktionen, die lokale Dateien öffnen.
Quelle: NVD: CVE-2026-119050 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Code-Injektion über LLM-Ausgaben
Wiz „Black October“: Vorfälle bei mindestens neun KI-Entwicklerplattformen
Wiz dokumentiert, dass im Oktober mindestens neun KI-Entwicklerplattformen Vorfälle offenlegten. Zwei gestohlene Schlüssel lösten laut Bericht rund 800.000 und rund 1,7 Millionen Bedrock-Aufrufe aus und verursachten zum Listenpreis vermutlich über 100.000 US-Dollar Nutzung; eine Plattform (Zeabur) stellt infolge des Vorfalls den Betrieb ein.
Quelle: Wiz: Black October for AI Developer Platforms
Im Portal: OWASP LLM04 · cve verzeichnis
CVE-2026-61789: Umgehung des Nur-Lese-Modus im DBHub-MCP-Server bei MySQL und MariaDB
Die Nur-Lese-Prüfung behandelt jeden doppelten Bindestrich als Kommentaranfang, während MySQL und MariaDB dafür ein Leerzeichen, ein Steuerzeichen oder das Zeilenende verlangen. Weil die Konnektoren die ursprüngliche Zeichenkette mit aktiviertem multipleStatements ausführen, verbirgt ein doppelter Bindestrich mit folgendem Nicht-Leerzeichen eine nachgestellte Schreib- oder DDL-Anweisung vor der Prüfung. Wer die SQL des Assistenten beeinflusst — auch per Prompt Injection in gelesenen Inhalten —, umgeht den Nur-Lese-Modus. PostgreSQL ist nicht betroffen.
Quelle: NVD: CVE-2026-61789 · Herstellerangabe
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
Wie gezählt wird
Aufgenommen wird ein Ereignis, wenn (1) eine Primärquelle es datiert — Standardgremium, Schwachstellendatenbank, Forschungsarbeit, Hersteller- oder Erstbericht —, (2) diese Quelle am Stichtag erreichbar war und (3) das Ereignis Prompt Injection oder die Sicherheit von Agenten betrifft. Jeder Eintrag verlinkt seine Quelle. Kennung, Datum, CVSS und CWE der Schwachstellen prüft scripts/cve-pruefen.mjs maschinell gegen die NVD. Seit der Ausgabe September wird die NVD zudem monatlich nach neu registrierten Schwachstellen mit Bezug zu Prompt Injection abgefragt (keywordSearch »prompt injection«, exakte Übereinstimmung), damit keine CVE übersehen wird. Die Spalten des Bereichsvergleichs sind Zählwerte, keine Bewertungen; die Einordnung je Bereich ist redaktionell und als solche gekennzeichnet.
Erfassung im Oktober 2026
Grundlage sind die Tagesnotizen des PI-Radars vom 1. bis 31. Oktober 2026, ergänzt um Meldungen vom 1. bis 6. November 2026, soweit sie ein Oktober-Ereignis an der Primärquelle datieren. Seit der Ausgabe September wird zusätzlich die National Vulnerability Database direkt abgefragt. Aus 110 Rohmeldungen des PI-Radars wurden 52 Einträge. Ausgeschlossen wurden:
- Agenten als Werkzeug von Angreifern statt als angegriffenes System — Kriterium 3 nicht erfüllt: ReliaQuest (07.10., Agenten-Orchestrierer übernimmt einen Server) und TrendAI CyberStrikeAI (23.10.)
- Vorfälle ohne belegbares Tagesdatum der Primärquelle, etwa die EMNLP-Arbeit CBC (nur „October 2026“, zudem seit Juni 2026 als anonymer Vorabdruck öffentlich)
- Ereignisse außerhalb des Berichtsmonats, die im Oktober erneut zirkulierten (OWASP LLM Top 10 vom August, OpenAPPA und ASPI aus dem Frühjahr/Sommer, der Hugging-Face-Vorfall vom August, NIST SP 1353 vom August)
- In die September-Ausgabe übernommene Ereignisse mit September-Datum (u. a. CVE-2026-93355, CVE-2026-103040, CVE-2026-103395, der GTIG-Bericht vom 30.09.)
- KI, die Schwachstellen findet oder ausnutzt, ohne dass die Sicherheit von Agenten selbst betroffen ist (CrowdStrike-Filterumgehung, Anthropics OSS-Scanner, PHP2Shell-CVEs)
- Mehrfachmeldungen desselben Ereignisses sowie Hersteller-, Lehr- und Meinungsbeiträge ohne neue Daten
- Meldungen, für die keine erreichbare Primärquelle auffindbar war
Die Rohdaten dieser Ausgabe liegen maschinenlesbar unter /api/v1/threat-index.json und im offenen Datensatz.
Die Quellen stehen bei jedem Eintrag. Kennung, Datum, CVSS und CWE der Schwachstellen sind maschinell gegen die NVD geprüft.