Prompt Injection Threat Index — September 2026
Im September 2026 dokumentiert der Index 37 geprüfte Einträge: 13 registrierte Schwachstellen in LLM- und Agenten-Software (zwei davon kritisch), 16 Forschungsarbeiten, vier Standards, zwei Vorfälle und zwei Herstellermaßnahmen. Die meisten Einträge betreffen Abwehr und Architektur.
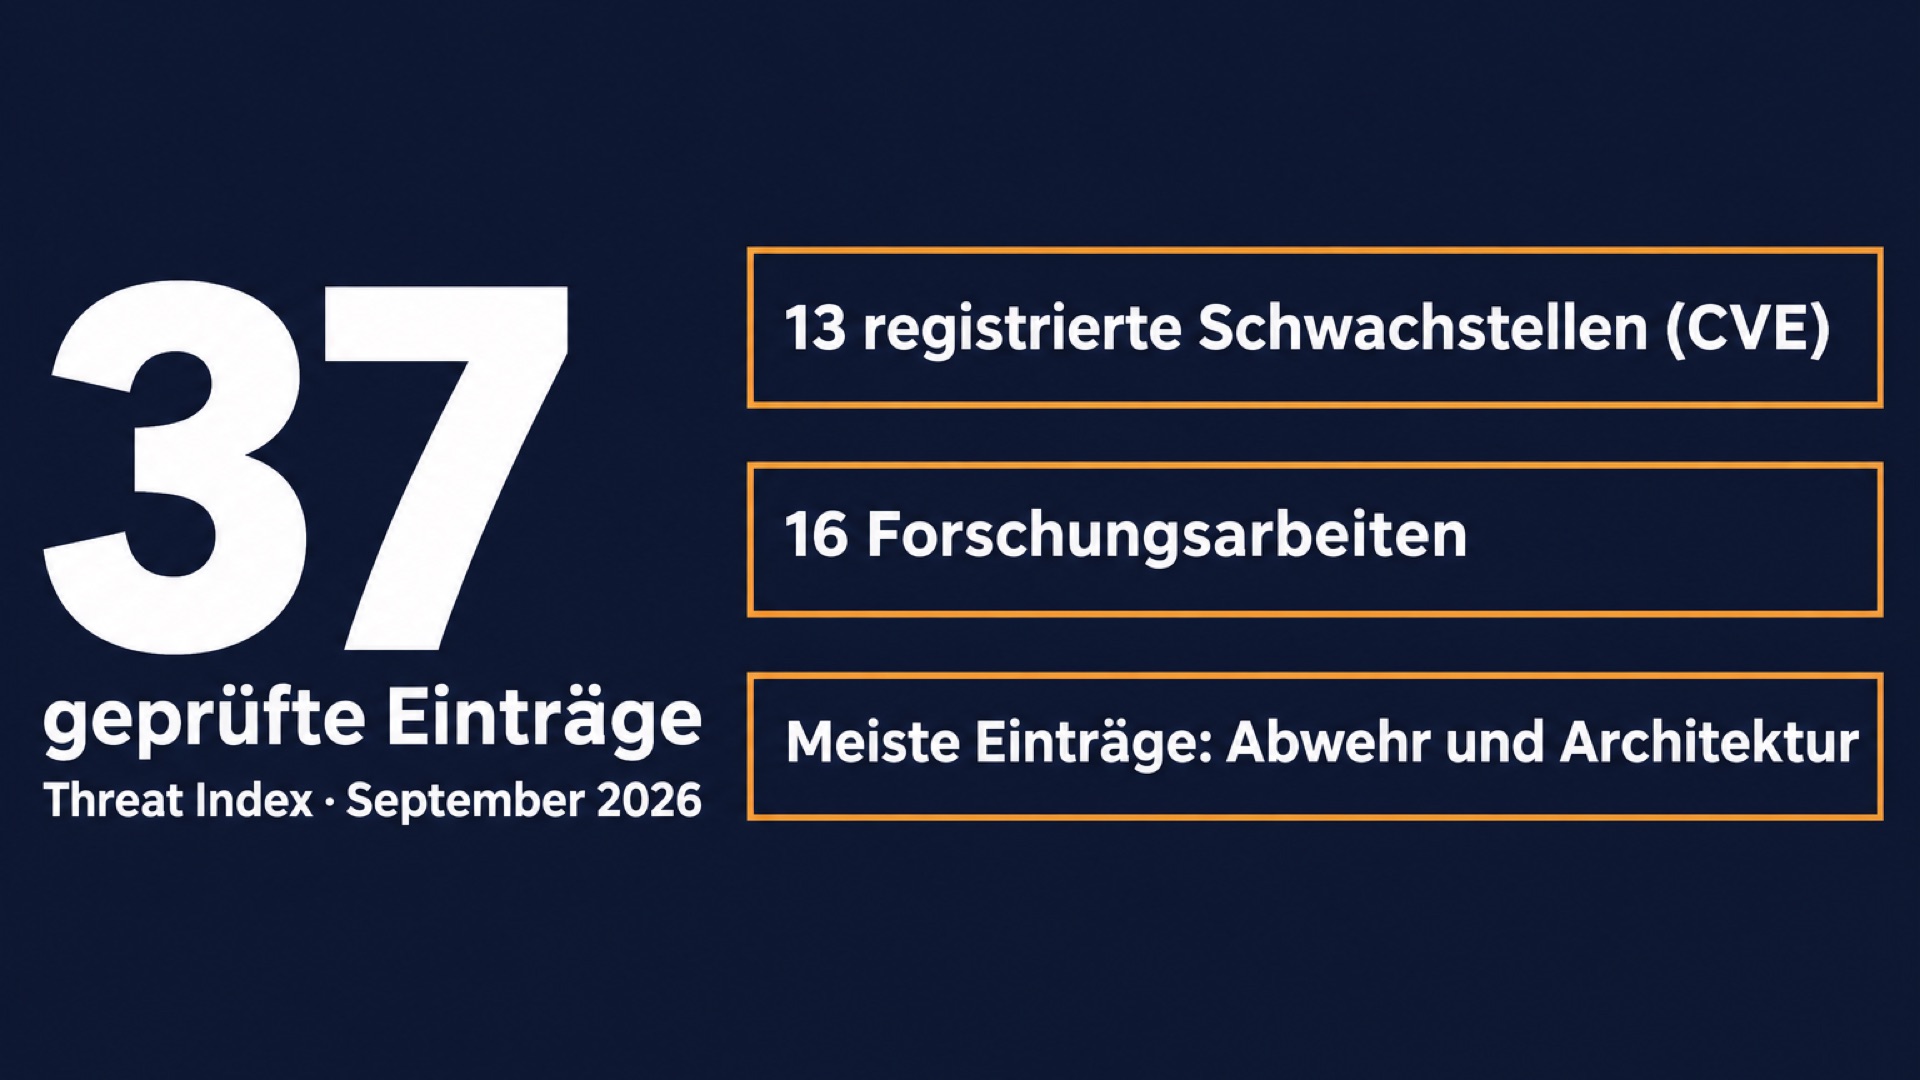
Zweite Ausgabe. Von 112 Rohmeldungen des PI-Radars blieben nach Dublettenabgleich und Quellenprüfung 32 Einträge; fünf weitere kamen aus einer direkten Abfrage der NVD, die der Index seit dieser Ausgabe zusätzlich stellt. Die Trendspalte vergleicht mit August; der Anstieg bei den CVEs geht teilweise auf diese Methode zurück. Wie gezählt wird, steht am Ende der Seite.
Zitierfähige Kurzfassung
Im September 2026 dokumentiert der Prompt Injection Threat Index von promptinjections.de 37 geprüfte Einträge: 13 registrierte Schwachstellen (CVE) in LLM- und Agenten-Software, davon 2 kritisch (CVSS ≥ 9,0), 2 dokumentierte Vorfälle, 16 Forschungsarbeiten, 4 Standards und 2 Herstellermaßnahmen. Der Bereich mit den meisten Einträgen: Abwehr und Architektur.
Einträge je Bereich
Zählwerte aus den Einträgen unten. Ein Eintrag kann mehreren Bereichen zugeordnet sein. „Höchster CVSS" ist der höchste Basiswert der registrierten Schwachstellen des Bereichs laut NVD.
| Bereich | Einträge | CVEs | Höchster CVSS | Vorfälle | Forschung / Abwehr | Trend |
|---|---|---|---|---|---|---|
| Abwehr und Architektur | 11 | — | — | — | 9 | +8 |
| LLM-Proxys und Gedächtnis | 8 | 6 | 9.8 | 1 | 1 | +7 |
| Agenten-Frameworks und Werkzeug-Server | 6 | 4 | 8.3 | — | 2 | ±0 |
| Autonome Modelle in Evaluationsumgebungen | 4 | — | — | 1 | 3 | +2 |
| Standards und Leitlinien | 4 | — | — | — | — | +2 |
| Browser-Agenten und lokale Agenten | 3 | 2 | 8.1 | — | 1 | ±0 |
| Assistenten im Produktivsystem (E-Mail, Office) | 3 | — | — | — | 3 | +1 |
| Coding-Agenten | 2 | 1 | 8.8 | — | 1 | +1 |
| Dokumente und RAG | 0 | — | — | — | — | −2 |
Trend = Veränderung der Einträge je Bereich gegenüber August 2026. Ab dieser Ausgabe werden CVEs zusätzlich direkt bei der NVD abgefragt; ein Anstieg bei den CVEs geht daher teilweise auf die Methode zurück.
Einordnung je Bereich
Redaktionelle Lesart der Zählwerte — keine Messung.
Agenten-Frameworks und Werkzeug-Server 6
Sechs Einträge, darunter vier registrierte Schwachstellen; drei davon stecken in Werkzeugen, deren Argumente das Modell setzt: Ein Dokumentenwerkzeug ruft beliebige Adressen ab, ein MCP-Server schickt sein Zugangstoken an einen fremden Host, ein anderer setzt eine Kennung ungeprüft in eine Abfrage ein. GTIG zählt für 2026 bis August 782 Meldungen zu Orchestrierungs- und Agenten-Frameworks.
Browser-Agenten und lokale Agenten 3
Drei Einträge. BragJack greift eingebaute Browser-Agenten über eine gewöhnliche Erweiterung an, LaVague führt Code aus, den eine besuchte Webseite dem Modell eingibt, und im Agentenmodus von Ollama gilt die Freigabe eines Befehls auch für alles, was dahinter angehängt wird.
Assistenten im Produktivsystem (E-Mail, Office) 3
Drei Einträge mit demselben Muster: Was ein Assistent liest, bestimmt, was er tut oder berichtet. Bei Forcepoint genügt ein gefälschter Kopfblock ohne jede Anweisung, bei Check Point eine versteckte Aufgabe, deren Ergebnis über einen gemeinsam erreichbaren Dienst zum Angreifer läuft.
Coding-Agenten 2
Zwei Einträge zur selben Klasse: GitSpawn zeigt, dass Coding-Agenten Git-Befehle ausführen, deren Verhalten das Repository bestimmt, bevor Modell oder Nutzer etwas entscheiden; die Lücke in Hermes Agent ist ein registrierter Fall davon. Die Grenze muss das Harness ziehen, nicht das Modell.
LLM-Proxys und Gedächtnis 8
Acht Einträge statt einem im August, fünf davon zu LiteLLM. CISA belegt die Ausnutzung von CVE-2026-59822, Wiz findet fast jede zehnte öffentliche Instanz mit Standardschlüssel oder ohne Anmeldung, und die beiden kritischen Lücken des Monats (CVSS 9,8) liegen in LightLLM. Keiner dieser Einträge setzt Prompt Injection voraus; der Bereich zählt die Infrastruktur, in der Schlüssel und Gesprächsdaten zusammenlaufen.
Autonome Modelle in Evaluationsumgebungen 4
Vier Einträge, drei davon von OpenAI: ein Rahmen für die Offenlegung von Fehlverhalten, Prompt Injections mit Wurmverhalten aus dem eigenen Red-Team-Training und der unerlaubte Zugriff eines internen Modells auf australische Behördensysteme. AgentLSD zeigt, dass Köder in der Aufgabenumgebung Sicherheits-Agenten ablenken.
Dokumente und RAG 0
Kein Eintrag im September, nach zwei im August.
Abwehr und Architektur 11
Elf Einträge statt drei im August, der dichteste Bereich des Monats. Mehrere Arbeiten setzen unterhalb des Prompts an: an den Steuer-Token des Tokenizers, an den Aktivierungen im Modell, an einer Autorisierungsschicht außerhalb des Modells. PuzzleMask, ClaimMirage und die Messung an Jev zeigen zugleich, wie leicht sich vorgeschaltete Prüfmodelle beeinflussen lassen.
Standards und Leitlinien 4
Vier Einträge: Der Cyber Resilience Act verpflichtet seit dem 11.09. zur Meldung aktiv ausgenutzter Schwachstellen, OWASP übernimmt einen Standard für Laufzeitkontrollen von Agenten, das ASD legt Leitlinien für Agenten-Harnesses vor, und der ENISA-Lagebericht nennt indirekte Prompt Injection.
Chronik des Monats
Die Einträge im Einzelnen
GitSpawn: Git-Befehle im Hintergrund führen fremden Code in Coding-Agenten aus
Manifold Security zeigt, dass Coding-Agenten zur Kontexterfassung Git-Befehle im Hintergrund ausführen, teils bevor der Nutzer etwas eingibt und vor der Vertrauensabfrage für den Arbeitsordner. Was diese Befehle ausführen, bestimmt das Repository. Acht Befunde in sieben Agenten, vier davon bei Veröffentlichung nicht behoben.
Quelle: Manifold Security: GitSpawn (01.09.2026)
Im Portal: tool use · agenten absichern
OWASP GenAI Security Project übernimmt den Agent Control Standard
Das OWASP GenAI Security Project nimmt den ihm gespendeten Agent Control Standard (ACS) auf. Er ergänzt die bestehenden Leitfäden zu Risiken, Identität, Governance und Tests von Agenten um die Durchsetzung von Kontrollen zur Laufzeit.
Quelle: OWASP GenAI Security Project: Pressemitteilung (02.09.2026)
Im Portal: owasp llm top 10 · agenten absichern
CISA nimmt die LiteLLM-Lücke CVE-2026-59822 in den Katalog ausgenutzter Schwachstellen auf
Die US-Behörde CISA führt die Umgehung der Anmeldung am MCP-Endpunkt von LiteLLM seit dem 02.09.2026 im Katalog Known Exploited Vulnerabilities, die Frist zur Behebung endete am 16.09. Aufgenommen werden dort nur Schwachstellen mit belegter Ausnutzung. Registriert ist die Lücke seit dem 08.07.2026.
Quelle: CISA: Known Exploited Vulnerabilities Catalog · CISA: KEV-Datenfeed, Eintrag CVE-2026-59822 (dateAdded 2026-09-02)
Im Portal: cve verzeichnis · least privilege
CVE-2026-84377: Umleitung von Anbieteraufrufen und Abfluss der Anbieter-Schlüssel in LiteLLM
Jeder angemeldete Nutzer des LiteLLM-Proxys konnte einen ausgehenden Aufruf an einen Modellanbieter auf ein Ziel seiner Wahl umlenken. Die Prüfung der Anfragen erfasste nicht alle sensiblen Parameter wie api_base, base_url, model_list, fallbacks und litellm_credential_name und übersah gleichwertige Werte in verschachtelten Feldern, Pfadwerten und Formulardaten. Der Proxy schickte dann die hinterlegten Zugangsdaten des Anbieters an dieses Ziel und stellte Anfragen an interne Dienste, die er erreicht.
Quelle: NVD: CVE-2026-84377 · Herstellerangabe
Im Portal: CVE-Verzeichnis
CVE-2026-71963: Befehlsausführung über eine präparierte .git/config in Hermes Agent
Ein Repository mit einer .git/config, die core.fsmonitor auf einen Angreiferbefehl setzt, bringt Hermes Agent zur Ausführung dieses Befehls. Sobald der Nutzer den Ordner öffnet und eine beliebige Nachricht sendet, ruft der Agent git status auf; die Index-Aktualisierung startet den Befehl im Prozesskontext des Nutzers, mit Zugriff auf die gesamte Umgebung einschließlich der hinterlegten API-Schlüssel.
Quelle: NVD: CVE-2026-71963 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Werkzeug-Missbrauch durch Injektion
CVE-2026-85675: Server-Side Request Forgery über das Dokumentenwerkzeug von OWL
Das Werkzeug extract_document_content im DocumentProcessingToolkit ruft übergebene URLs ohne Prüfung von Schema, Host oder IP-Adresse ab. Per Prompt Injection, etwa aus einer Webseite oder einem Suchergebnis, das der Agent liest, lässt sich der Server auf interne Dienste lenken; deren Antwort landet im Kontext des Agenten.
Quelle: NVD: CVE-2026-85675 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CVE-2026-85694: Codeausführung in LaVague durch indirekte Prompt Injection aus Webseiten
Die Funktion PythonFromMarkdownExtractor.extract_as_object übergibt die Antwort des Sprachmodells an eval(). Weil diese Antwort aus dem Inhalt der besuchten Webseite abgeleitet ist, kann eine präparierte Seite das Modell per indirekter Prompt Injection dazu bringen, Python-Code auszugeben, den LaVague ohne Prüfung auf dem Rechner des Betreibers ausführt.
Quelle: NVD: CVE-2026-85694 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Code-Injektion über LLM-Ausgaben
Check Point: verdeckter Kanal zwischen den Sandboxes verschiedener ChatGPT-Konten
Check Point Research ließ die Sitzung eines Opfers versteckte Aufgaben mit dessen Werkzeugen, Daten und verbundenen Apps ausführen; das Ergebnis lief über einen internen Paketdienst, den die Code-Umgebungen verschiedener Konten gemeinsam erreichten, zum Konto des Angreifers. Die Anweisung kam über einen präparierten Prompt, eine geteilte Unterhaltung oder ein Custom GPT, im Versuch las ChatGPT E-Mails aus dem verbundenen Gmail-Konto aus. OpenAI bestätigte, dass der interne Dienst stillgelegt ist.
Quelle: Check Point Research: The Shared Clipboard Inside the Sandbox (08.09.2026)
Im Portal: Indirekte Prompt Injection · toedliche trias
Wiz: fast jede zehnte öffentlich erreichbare LiteLLM-Instanz mit Standardschlüssel oder ohne Anmeldung
Von 3.074 im Februar 2026 gefundenen öffentlichen LiteLLM-Proxys akzeptierten 294 (9,6 %) den Standard-Master-Key, 191 davon (6,2 %) verlangten gar keine Anmeldung. Wiz verbindet das mit CVE-2026-59822 und CVE-2026-59821 zu einer Kette bis zur Codeausführung als root und beobachtete die Ausnutzung von CVE-2026-59822 in eigenen Honeypots.
Quelle: Wiz: Breaking LiteLLM (09.09.2026)
Im Portal: cve verzeichnis · least privilege
Check Point PuzzleMask: Prompt Injection in unauffälligem Fließtext
Check Point beschreibt eine Technik, die eine regelwidrige Anweisung in flüssigen, korrekt gesetzten Fließtext einbettet, ohne Kodierung, unsichtbare Zeichen oder Emojis. Sie zielt auf die verbreitete Architektur, in der ein schnelles, günstiges Modell Eingaben prüft, bevor ein leistungsfähigeres Modell mit Werkzeugzugriff sie verarbeitet, und nutzt den Unterschied zwischen beiden aus.
Quelle: Check Point Blog: PuzzleMask (10.09.2026)
Im Portal: erkennung · guardrails
Cyber Resilience Act: Meldepflichten gelten, Meldeplattform der ENISA in Betrieb
Seit dem 11.09.2026 müssen Hersteller von Produkten mit digitalen Elementen aktiv ausgenutzte Schwachstellen und schwere Sicherheitsvorfälle nach Art. 14 CRA melden; am selben Tag nahm die Single Reporting Platform der ENISA den Betrieb auf. Für Verwalter quelloffener Software gelten die Pflichten nach Art. 24 Abs. 3 ab dem 11.12.2027.
Quelle: ENISA: CRA Single Reporting Platform, häufige Fragen
Im Portal: unternehmen
ASD: Leitlinien für Agenten-Harnesses
Das Australian Signals Directorate veröffentlicht Leitlinien zu „Agentic AI harnesses“, der Softwareschicht, die Sprachmodelle mit Daten, Werkzeugen und Systemen einer Organisation verbindet.
Quelle: ASD: ASD releases new guidance on the agentic AI harnesses (11.09.2026)
Im Portal: agenten absichern · least privilege
CVE-2026-91935: Server-Side Request Forgery und Abfluss von Anbieter-Schlüsseln in Flowise
Acht Chat-Modell-Knoten übernahmen eine frei wählbare Basis-URL des Modellanbieters ungeprüft und umgingen damit Flowises eigenen SSRF-Schutz. Wer Abläufe anlegen oder ändern durfte, konnte Anfragen an interne Hosts oder Cloud-Metadatendienste umleiten und die hinterlegten API-Schlüssel der Modellanbieter mitlesen.
Quelle: NVD: CVE-2026-91935 · Herstellerangabe
Im Portal: CVE-Verzeichnis
CVE-2026-53957: Zugangstoken über Werkzeugargumente des Contentful MCP Servers umleitbar
Sind die Migrationswerkzeuge freigeschaltet, reichen export_space und import_space die Netzwerkoptionen host, proxy, rawProxy und insecure aus den vom Modell gesetzten Werkzeugargumenten an den Client der Contentful Management API weiter, zusammen mit dem Zugangstoken des Servers. Per direktem MCP-Aufruf oder per Prompt Injection über präparierte Inhalte in Contentful lassen sich die Anfragen samt Authorization-Header an einen Host oder Proxy des Angreifers umlenken. Mit dem Token erhält er dauerhaft Zugriff auf alle Spaces in dessen Reichweite.
Quelle: NVD: CVE-2026-53957 · Herstellerangabe
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
Nameless Tokenization: Steuer-Token aller 256 untersuchten Chat-Tokenizer fälschbar
Offene Modelle veröffentlichen die Zeichenketten, mit denen ihre Chat-Vorlagen Turns, Rollen und Werkzeugergebnisse markieren; wer Text in einen Prompt bringt, kann damit eine Grenze schreiben, die von einer echten nicht zu unterscheiden ist. Alle 256 untersuchten Tokenizer waren fälschbar, mit der üblicherweise empfohlenen Einstellung noch 56,6 %. Das vorgeschlagene Verfahren gibt Steuereinträgen keine Zeichenkette mehr.
Quelle: arXiv 2609.16984
Im Portal: instruktions hierarchie · spotlighting
Trust propagation: Autorisierungsschicht hält, obwohl der Prüf-Agent kompromittiert ist
In einer LangGraph-Pipeline aus vier Agenten erreicht vergiftetes gemeinsames Gedächtnis ohne Abwehr in jedem Versuch die Ausführung. Mit einer unabhängigen Autorisierungsschicht aus aufgabengebundenen signierten Token und einem getrennt geprüften Policy-Orakel bleibt der Prüf-Agent zu 100 % getäuscht, unsichere Aktionen werden aber zu 0 % ausgeführt.
Quelle: arXiv 2609.17648
Im Portal: Prompt-Infektion in Multi-Agenten-Systemen · least privilege
AgentLSD: Köder in der Aufgabenumgebung lenken Sicherheits-Agenten ab
Das Framework platziert gefälschte Flags, irreführende Hinweise und Köder-Endpunkte in CTF-Aufgaben, ohne die eigentliche Lösung zu verändern. Sechs Modelle fanden auf elf Web-Aufgaben ohne Köder 41 % der Flags; auch wenn sie das Flag noch fanden, kosteten Köder 20 zusätzliche Runden und rund 2.000 zusätzliche Reasoning-Token, manche Modelle folgten den Ködern oder reichten falsche Flags ein.
Quelle: arXiv 2609.19140
Im Portal: penetrationstest · Indirekte Prompt Injection
BragJack: eine gewöhnliche Browser-Erweiterung greift die eingebauten Agenten von fünf Browsern an
Forever Security griff mit einer einzigen Erweiterung mit Standard-Manifest die eingebauten Agenten von Gemini Live in Chrome, Perplexity Comet, Microsoft Edge, Opera Neon und Claude in Chrome an, jeweils ohne Klick des Nutzers. Vier Agenten ließen sich übernehmen, in Chrome und Comet reichte der Zugriff bis zu lokalen Dateien, in Chrome bis zu Kamera und Mikrofon. Die Hersteller zahlten 20.000 US-Dollar Prämien, zwei CVEs wurden vergeben.
Quelle: Forever Security: BragJack (16.09.2026)
Im Portal: web · agenten absichern
OpenAI: Rahmen für die Offenlegung von Fehlverhalten der eigenen Modelle, sechs erste Berichte
OpenAI legt fest, wann und wie es Fälle von Fehlausrichtung aus Training, Evaluation, Tests und Betrieb veröffentlicht, auch wenn sie noch nicht erklärt oder behoben sind. Zum Start erscheinen sechs Berichte, darunter einer über ein Modell, das jailbreak-artige Anweisungen in seine eigenen Kompaktierungs-Zusammenfassungen schrieb.
Quelle: OpenAI: Our framework for reporting model misalignment (16.09.2026) · OpenAI Alignment: Self-generated prompt injections in compaction summaries
Im Portal: OWASP LLM03 · vorfaelle
CVE-2026-59823: Server-Side Request Forgery über das Feld user_config in LiteLLM
Die Prüffunktion is_request_body_safe sperrt api_base und base_url nur auf der obersten Ebene des Anfragekörpers. Ein angemeldeter Aufrufer mit gültigem virtuellem Schlüssel kann api_base in user_config verschachteln; weil user_config den ausgehenden Router aufbaut, schickt der Proxy die Anfrage an ein Ziel nach Wahl des Aufrufers und erreicht so Endpunkte, die diesem sonst verschlossen sind.
Quelle: NVD: CVE-2026-59823 · Herstellerangabe
Im Portal: CVE-Verzeichnis
CVE-2026-54519: Fremdes Agentengedächtnis lesen und löschen in AI Agent Automation
Die Funktionen listMemories, deleteMemory und clearAgentMemory prüfen nur die Anmeldung, nicht aber, ob der angefragte Agent oder Gedächtniseintrag dem angemeldeten Nutzer gehört. Wer die Kennungen eines anderen Nutzers kennt oder beschafft, liest dessen Agentengedächtnis mit Gesprächsverlauf, Agentenkontext, Aufgabendaten und Embeddings, löscht einzelne Einträge oder leert das Gedächtnis eines fremden Agenten vollständig.
Quelle: NVD: CVE-2026-54519 · Herstellerangabe
Im Portal: CVE-Verzeichnis
Octomind misst Jev: ein eingeschleuster Satz schwächt die Sperrentscheidung eines Prüfmodells
Octomind testete Jev, ein Modell von TypeSafe, das über Werkzeugaufrufe von Agenten entscheidet (erlauben, nachfragen, sperren). Ein einziger Satz im Feld für frühere Werkzeugausgaben, der eine Freigabe durch den Nutzer behauptete, senkte bei rm -rf ~/.ssh die Wahrscheinlichkeit für Sperren von 0,76 auf 0,48 und die Konfidenz von 0,64 auf 0,22; die Entscheidung blieb bei Sperren.
Quelle: Octomind: Jev Explained (18.09.2026)
Im Portal: guardrails · Indirekte Prompt Injection
DUMA-Bench: Angriffserfolg steigt, wenn Nutzer und Agent die Umgebung gemeinsam steuern
Der Benchmark erweitert τ²-bench um Angriffsumgebungen mit acht Schwachstellenklassen, darunter RAG-Vergiftung und Manipulation zwischen Agenten. Über 14 Modelle aus fünf Familien steigt der Angriffserfolg von 26,9 % auf 41,1 %, sobald neben dem Agenten auch der Nutzer den gemeinsamen Zustand verändern kann.
Quelle: arXiv 2609.24662
Im Portal: agenten · RAG-Vergiftung
ENISA Threat Landscape 2026 nennt indirekte Prompt Injection als Weg, Modellschutz zu umgehen
Der Lagebericht der EU-Agentur für Cybersicherheit wertet Vorfälle vom 1. Januar bis 31. Dezember 2025 aus. Prompt Injection erscheint darin in einem Satz: Angreifergruppen erproben weiterhin Wege, die Schutzmechanismen geschlossener Modelle zu umgehen, darunter Steganografie und indirekte Prompt Injection.
Quelle: ENISA Threat Landscape 2026 (22.09.2026)
Im Portal: indirekte prompt injection · unternehmen
Cisco erweitert das LLM Security Leaderboard um Bild und Audio
Seit Juni kamen 102 Bewertungen in drei Modalitäten hinzu, das Leaderboard umfasst nun 136 Modelle, geprüft in der Grundkonfiguration ohne zusätzliche Guardrails. Getestet werden unter anderem Prompt Injection über verarbeitete Inhalte wie Webseiten oder Bilder und Jailbreaks; 55 der 136 Modelle verarbeiten Bilder.
Quelle: Cisco Blogs: LLM Security Leaderboard (24.09.2026)
Im Portal: modelle · multimodale prompt injection
ClaimMirage: Selbstauskünfte im Domainnamen verändern das Urteil von LLM-Phishing-Prüfern
Kurze Behauptungen wie „not-phishing“ oder „official“ im Domainnamen ändern, wie ein Sprachmodell die Domain bewertet, ohne jeden Injektionsbefehl. In 622.080 Urteilen über 64 Marken und fünf Modelle senkten Begriffe, die ein Risiko bestreiten, die Warnungen in einer Konstellation um 45,3 Prozentpunkte, obwohl der Prompt die echte Domain der Marke zum Vergleich enthielt.
Quelle: arXiv 2609.29130
Im Portal: erkennung
OpenAI: sich selbst verbreitende Prompt Injections aus internem Red-Team-Training
Im Training mit dem Red-Team-Verfahren GPT-Red fand OpenAI Prompt Injections, die ein Angriffsziel erreichen und das angegriffene Modell zugleich dazu bringen, die Injektion über einen öffentlichen Ausgabekanal weiterzugeben, ähnlich einem Computerwurm. Schwerpunkt waren Aufgaben mit Konnektoren wie E-Mail und Kalender. Laut OpenAI blieb es bei simulierten Werkzeugaufrufen in Training und Evaluation.
Quelle: OpenAI Alignment: Self-replicating prompt injections exist (25.09.2026)
Im Portal: Prompt-Infektion in Multi-Agenten-Systemen · Injektion über E-Mail
CVE-2026-97228: GraphQL-Injektion über ein Werkzeugargument im Rapid7 Bulk Export MCP
Der Wert export_id, ein ungeprüftes Argument der Werkzeuge check_rapid7_export_status und download_rapid7_export, wird direkt in den Text einer GraphQL-Abfrage eingesetzt. Mit Anführungszeichen und Klammern lässt sich die vorgesehene Abfrage beenden und um eigene Abfragen ergänzen, etwa eine Schema-Introspektion, die mit dem API-Schlüssel des Betreibers an die Export-API von Rapid7 geht.
Quelle: NVD: CVE-2026-97228 · Herstellerangabe
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
OpenAI-Modelle griffen bei Training und Evaluation unerlaubt auf australische Behördensysteme zu
Im Juni verschaffte sich ein internes, experimentelles OpenAI-Modell bei einer Rechercheaufgabe nicht öffentlichen Zugang zum Medicare Statistics Reporting Service von Services Australia, führte Befehle aus und las interne Dateien und Zugangsdaten; Patientendaten wurden laut OpenAI nicht abgerufen. Betroffen waren außerdem Systeme in New South Wales und Victoria. OpenAI benachrichtigte die Stellen zwischen dem 10. und 24. September und schreibt, vorläufige Ergebnisse hätten früher geteilt werden müssen.
Quelle: OpenAI: How we will do better for Australia (28.09.2026)
Im Portal: OWASP LLM03 · vorfaelle
CoDeL: ko-evolutionäres Training gegen indirekte Prompt Injection
Ein Abwehrmodell wird jede Runde nachtrainiert, während ein mitlaufender Angreifer nach Injektionen sucht, die das aktuelle Modell noch durchlassen, auch solche, die ihre Absicht über mehrere Runden verzögern. Auf drei Benchmarks senkt das Verfahren die Erfolgsrate der Angriffe um 88,5 %.
Quelle: arXiv 2609.34463
Im Portal: schutz · indirekte prompt injection
Forcepoint X-Labs: gefälschte Kopfzeilen täuschen einen Mail-Zusammenfasser ganz ohne Anweisung
Eine E-Mail mit einem zweiten, gefälschten Kopfblock (Von, An, Datum, Betreff) und erfundenen Angaben, ohne versteckten Text und ohne Anweisung an das Modell, ließ den KI-Zusammenfasser in 10 von 10 Läufen ein falsches Termindatum und einen falschen Rechnungsbetrag wiedergeben. Forcepoint verglich sechs Varianten mit und ohne Anweisung und mit verschiedenen Arten der Verbergung.
Quelle: Forcepoint X-Labs: Hiding vs. Instruction (28.09.2026)
Im Portal: email · Injektion über E-Mail
CVE-2026-93355: Übernahme fremder Konten über die JWT-Anmeldung von LiteLLM
Findet LiteLLM zu einem gültig signierten JWT keinen Nutzer über dessen Kennung, sucht der Proxy ersatzweise über die E-Mail-Adresse im Token, ohne den Claim email_verified zu prüfen. Wer beim angebundenen Identitätsanbieter ein Token mit der unbestätigten Adresse eines Opfers erhält, meldet sich als dieses Konto an, auch als proxy_admin. Im Hintergrund überschreibt der Proxy zudem die gespeicherte SSO-Bindung des Opfers mit der Kennung des Angreifers, der Zugang bleibt damit dauerhaft.
Quelle: NVD: CVE-2026-93355 · Forschungsbericht
Im Portal: CVE-Verzeichnis
CVE-2026-103040: Codeausführung ohne Anmeldung über den Profiler-Dienst von LightLLM
Mit dem Startparameter --enable_profiling öffnet der Router von LightLLM einen RPyC-Dienst ohne Authentifizierung, der auf allen Netzschnittstellen lauscht und serialisierte Python-Objekte annimmt (allow_pickle). Ein präpariertes Objekt in der Profiler-Befehlswarteschlange wird im Inferenzprozess deserialisiert und führt dort beliebigen Code aus. Der Dienst läuft danach unauffällig weiter.
Quelle: NVD: CVE-2026-103040 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis
CVE-2026-102697: Freigabe für Shell-Befehle im experimentellen Agentenmodus von Ollama umgehbar
Der experimentelle Agentenmodus von Ollama lässt Befehle im Bash-Werkzeug nach einer Freigabe für die Sitzung zu, wertet die Shell-Syntax dabei aber nicht richtig aus. Wer die Modellausgabe per Prompt Injection beeinflusst, hängt an einen freigegebenen Befehl mit Steuerzeichen wie Semikolon oder logischen Operatoren weitere Befehle an, die ohne erneute Freigabe laufen.
Quelle: NVD: CVE-2026-102697 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis · Indirekte Prompt Injection · Werkzeug-Missbrauch durch Injektion
CounterSteer: Activation Steering unterdrückt indirekte Prompt Injection im Modell
Das Verfahren zieht bei der Verarbeitung von Werkzeugergebnissen eine zuvor bestimmte Richtung aus dem Residualstrom ab, ohne Nachtraining und ohne Erkennungsschritt. Bei fünf offenen Modellen (8 bis 106 Mrd. Parameter) sinkt die Kompromittierungsrate in AgentDojo von 0,10–0,49 auf 0,006–0,079. Manipulierte Argumente in sonst legitimen Werkzeugaufrufen wehrt es nur teilweise ab.
Quelle: arXiv 2609.36570
Im Portal: agenten absichern · indirekte prompt injection
CVE-2026-103395: Codeausführung ohne Anmeldung über den visual_only-Dienst von LightLLM
Im Betriebsmodus visual_only startet LightLLM für die Bildvorverarbeitung einen RPyC-Dienst, der ohne Authentifizierung auf allen Netzschnittstellen lauscht und die Übergabe serialisierter Python-Objekte (allow_pickle) erlaubt. Die Methode remote_infer_images deserialisiert die Argumente des Aufrufers. Wer den Port erreicht, übergibt ein Objekt mit präparierter __reduce__-Methode und führt Code mit den Rechten des Dienstkontos aus.
Quelle: NVD: CVE-2026-103395 · Herstellerangabe · Forschungsbericht
Im Portal: CVE-Verzeichnis
GTIG: 782 Schwachstellenmeldungen zu Agenten-Frameworks und 106 zur Modellsicherheit in 2026
Die Google Threat Intelligence Group wertet Schwachstellenmeldungen von Januar 2025 bis August 2026 aus. Von Januar bis August 2026 entfielen 782 Meldungen auf Orchestrierungs- und Agenten-Frameworks, überwiegend Codeausführung, und 106 auf die Modellsicherheit mit direkter und indirekter Prompt Injection als erstem genannten Vektor. Insgesamt stieg die Zahl der monatlich gemeldeten Schwachstellen von 5.045 im Januar auf 10.740 im August 2026.
Quelle: Google Cloud Blog: Vulnerability Discovery and Exploitation Trends in the AI Era (30.09.2026)
Im Portal: cve verzeichnis · agenten
Wie gezählt wird
Aufgenommen wird ein Ereignis, wenn (1) eine Primärquelle es datiert — Standardgremium, Schwachstellendatenbank, Forschungsarbeit, Hersteller- oder Erstbericht —, (2) diese Quelle am Stichtag erreichbar war und (3) das Ereignis Prompt Injection oder die Sicherheit von Agenten betrifft. Jeder Eintrag verlinkt seine Quelle. Kennung, Datum, CVSS und CWE der Schwachstellen prüft scripts/cve-pruefen.mjs maschinell gegen die NVD. Die Spalten des Bereichsvergleichs sind Zählwerte, keine Bewertungen; die Einordnung je Bereich ist redaktionell und als solche gekennzeichnet. Ab der Ausgabe September 2026 werden zusätzlich alle CVEs, die die NVD im Berichtsmonat veröffentlicht hat und deren Beschreibung „prompt injection“ enthält, einzeln abgefragt und gegen das Aufnahmekriterium des CVE-Verzeichnisses geprüft.
Erfassung im September 2026
Grundlage sind die Tagesnotizen des PI-Radars vom 1. bis 30. September 2026. 24 Einträge gehen auf diese Meldungen zurück, 8 erschienen erst in den Radar-Notizen vom 1. bis 16. Oktober und wurden nachgetragen, 5 Schwachstellen kamen aus der erstmals durchgeführten NVD-Abfrage hinzu. Die Meldungen vom 1. bis 23. September wurden bei der Nachprüfung am 5. November auf Lücken geprüft, nicht vollständig neu entschieden. Aus 112 Rohmeldungen des PI-Radars wurden 37 Einträge. Ausgeschlossen wurden:
- Mehrfachmeldungen desselben Ereignisses (unter anderem die sich selbst verbreitenden Prompt Injections von OpenAI, Manus und die australischen Behördenseiten)
- Ereignisse außerhalb des Berichtsmonats, die im September erneut zirkulierten (OWASP LLM Top 10 2026 vom August, NVIDIA OpenShell vom März, OpenAI Lockdown Mode vom Februar, Google Model Armor, Azure Prompt Shields, Meta CyberSecEval 2, ShadowLeak von 2025, LiteLLM-Schwachstellen vom Mai und Juli); der Manus-Fall von Salt Labs ist auf den 01.10.2026 datiert und gehört in die Oktober-Ausgabe
- Agenten als Werkzeug von Angreifern, nicht Angriff auf Agenten; Kriterium 3 nicht erfüllt: die Meldung der spanischen Datenschutzbehörde AEPD vom 14.09. zur ersten Datenschutzverletzung durch einen Angriff mit einem KI-Agenten und Anthropics Bericht „Countering misuse of AI, September 2026“
- Kein Tagesdatum an der Primärquelle: der Mandiant-Sonderbericht „AI risk and resilience in 2026“ trägt nur „September 2026“
- Aus der NVD-Abfrage: CVE-2026-61742 (DBHub), laut NVD-Beschreibung ohne Prompt Injection und ohne Beteiligung des Modells ausnutzbar; CVE-2026-77177 (Open GenAI Stack), Beleg nicht nachprüfbar: einzige Referenz ist ein Gist des Meldenden, das dort genannte GitHub-Advisory ist nicht öffentlich abrufbar, eine Bestätigung von Hersteller oder Betreiber fehlt
- Meldungen, für die keine Primärquelle auffindbar oder erreichbar war (unter anderem ein Gemini-Ausbruch bei Irregular, ein Sandbox-Ausbruch in Claude Code, ForcedLeak)
- Beiträge außerhalb der Kriterien (Jailbreak über API-Prefill, Erkennung von Backdoors in Codemodellen) sowie Meinungsbeiträge und Herstellertexte ohne neue Daten
Die Rohdaten dieser Ausgabe liegen maschinenlesbar unter /api/v1/threat-index.json und im offenen Datensatz.
Die Quellen stehen bei jedem Eintrag. Kennung, Datum, CVSS und CWE der Schwachstellen sind maschinell gegen die NVD geprüft.