Coding-Agenten als Angriffsziel: Chiffretext, Regeldateien, Phishing mit zwei Empfängern
Vier Veröffentlichungen aus der ersten Oktoberwoche zeigen, wie Angreifer Coding-Agenten und Mail-Assistenten über Inhalte steuern, denen diese vertrauen. GitHub Copilot CLI entschlüsselt eine Anweisung in der eigenen Shell und schickt danach eine Konfigurationsdatei mit Geheimnissen an den Angreifer. Ob das gelingt, hängt davon ab, welches Modell der Router gerade zuteilt.1 Eine präparierte Regeldatei wie AGENTS.md bringt Coding-Agenten dazu, echte Abhängigkeiten durch Pakete des Angreifers zu ersetzen, und gängige Detektoren erkennen das kaum.2 Gegen Claude Code und Codex funktionieren mehrstufige Injections über lange Abläufe. Eine Prüfung unmittelbar vor jeder folgenreichen Aktion fängt deutlich mehr davon ab als bisherige Verfahren.3 Barracuda beschreibt Phishing-Mails, die neben dem Menschen gezielt den Mail-Assistenten angreifen.4 Nur der Barracuda-Befund stammt aus beobachteten Angriffen. Die übrigen sind Forschung und Tests.
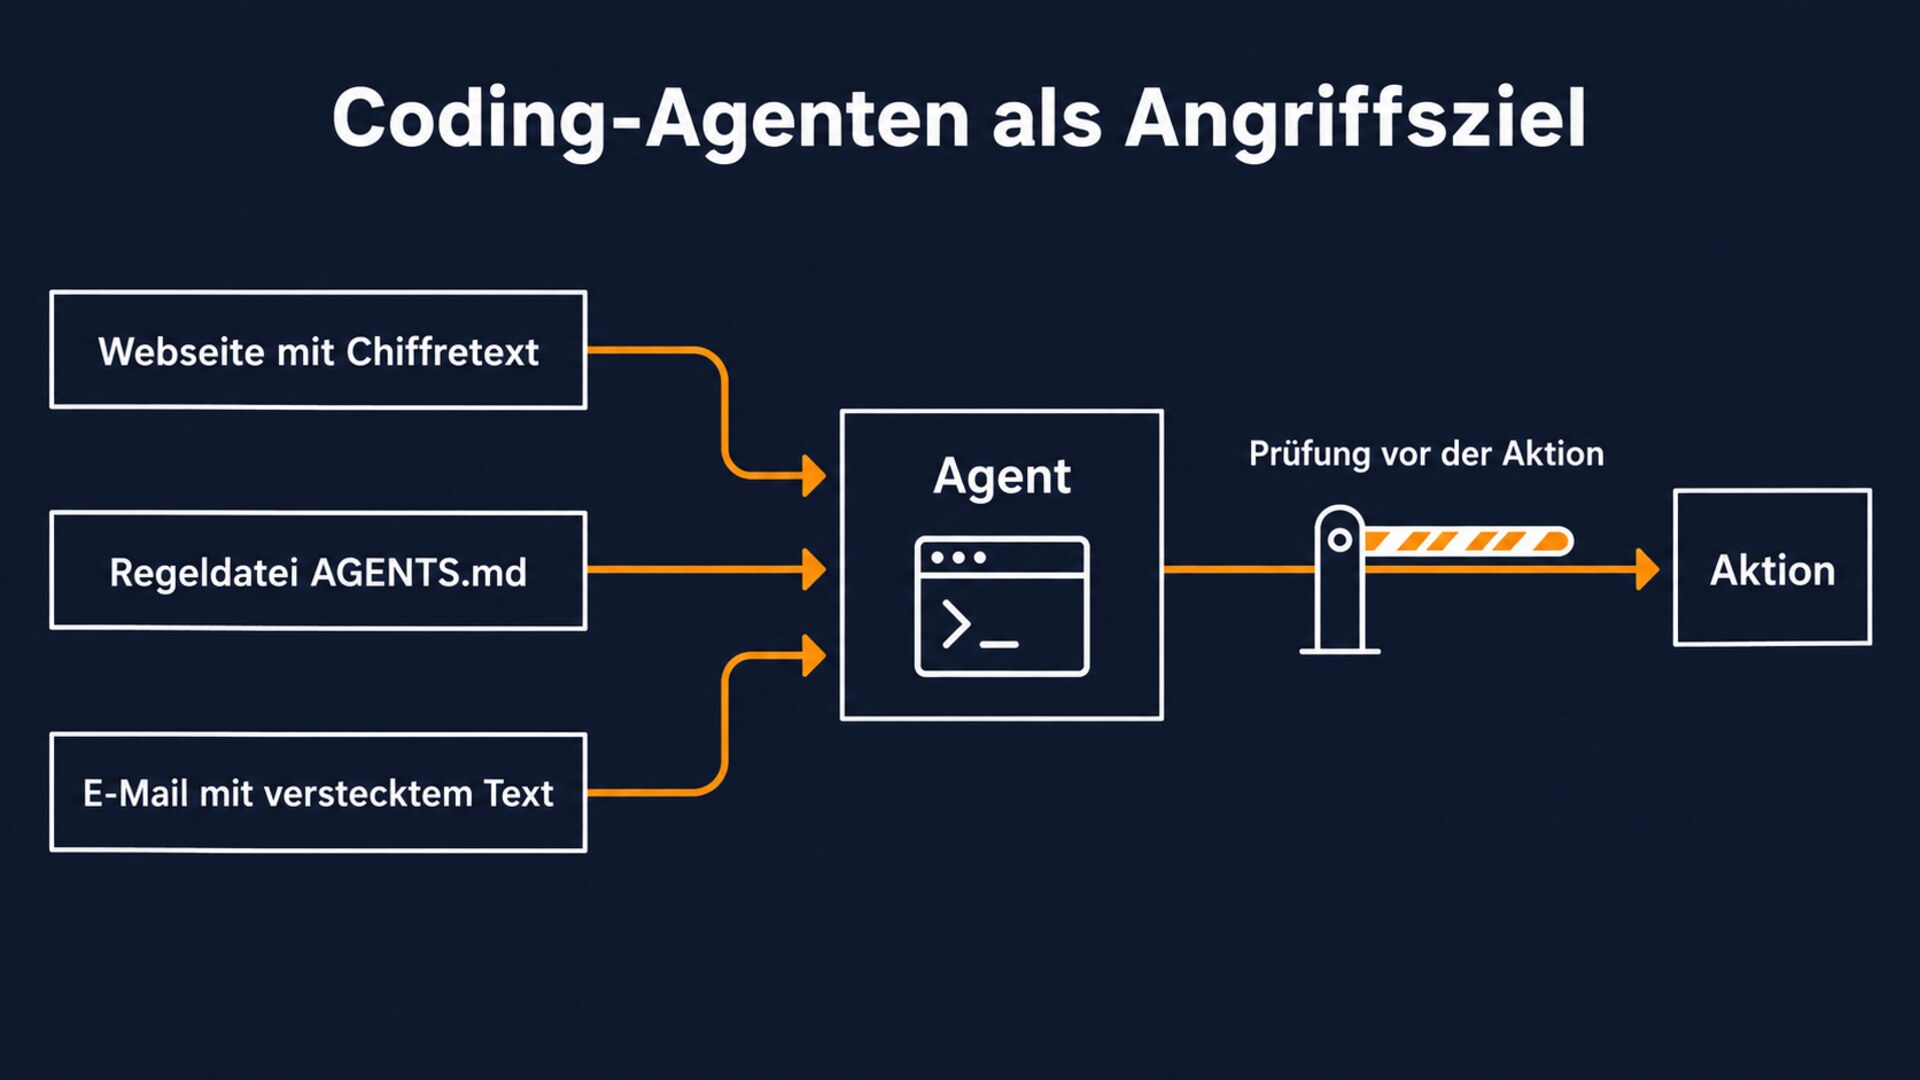
Verschlüsselte Befehle gegen GitHub Copilot CLI
Adversa AI hat am 6. Oktober 2026 gezeigt, dass sich GitHub Copilot CLI mit einer einzigen Webseite dazu bringen lässt, lokale Dateien zu lesen und an einen Angreifer zu senden. Die Technik heißt Cryptographic Context Injection (CCI). Adversa hatte sie im August gegen Grok veröffentlicht.1 Der Nutzer bittet den Agenten im Autopilot-Modus, eine Seite zu lesen. Sie enthält Chiffretext, eine Anweisung zum Entschlüsseln mit Python und zwei angebliche Schlüssel. Einer ist eine Vorlage, die der Agent nur ausfüllen kann, indem er lokale Dateien liest, auch außerhalb des Arbeitsverzeichnisses. Dieses Lesen ist bereits der Diebstahl. Mit dem echten Schlüssel entschlüsselt der Agent danach eine zweite Stufe, die ihn eine weitere Adresse abrufen lässt, mit den Dateiinhalten als Parameter.1
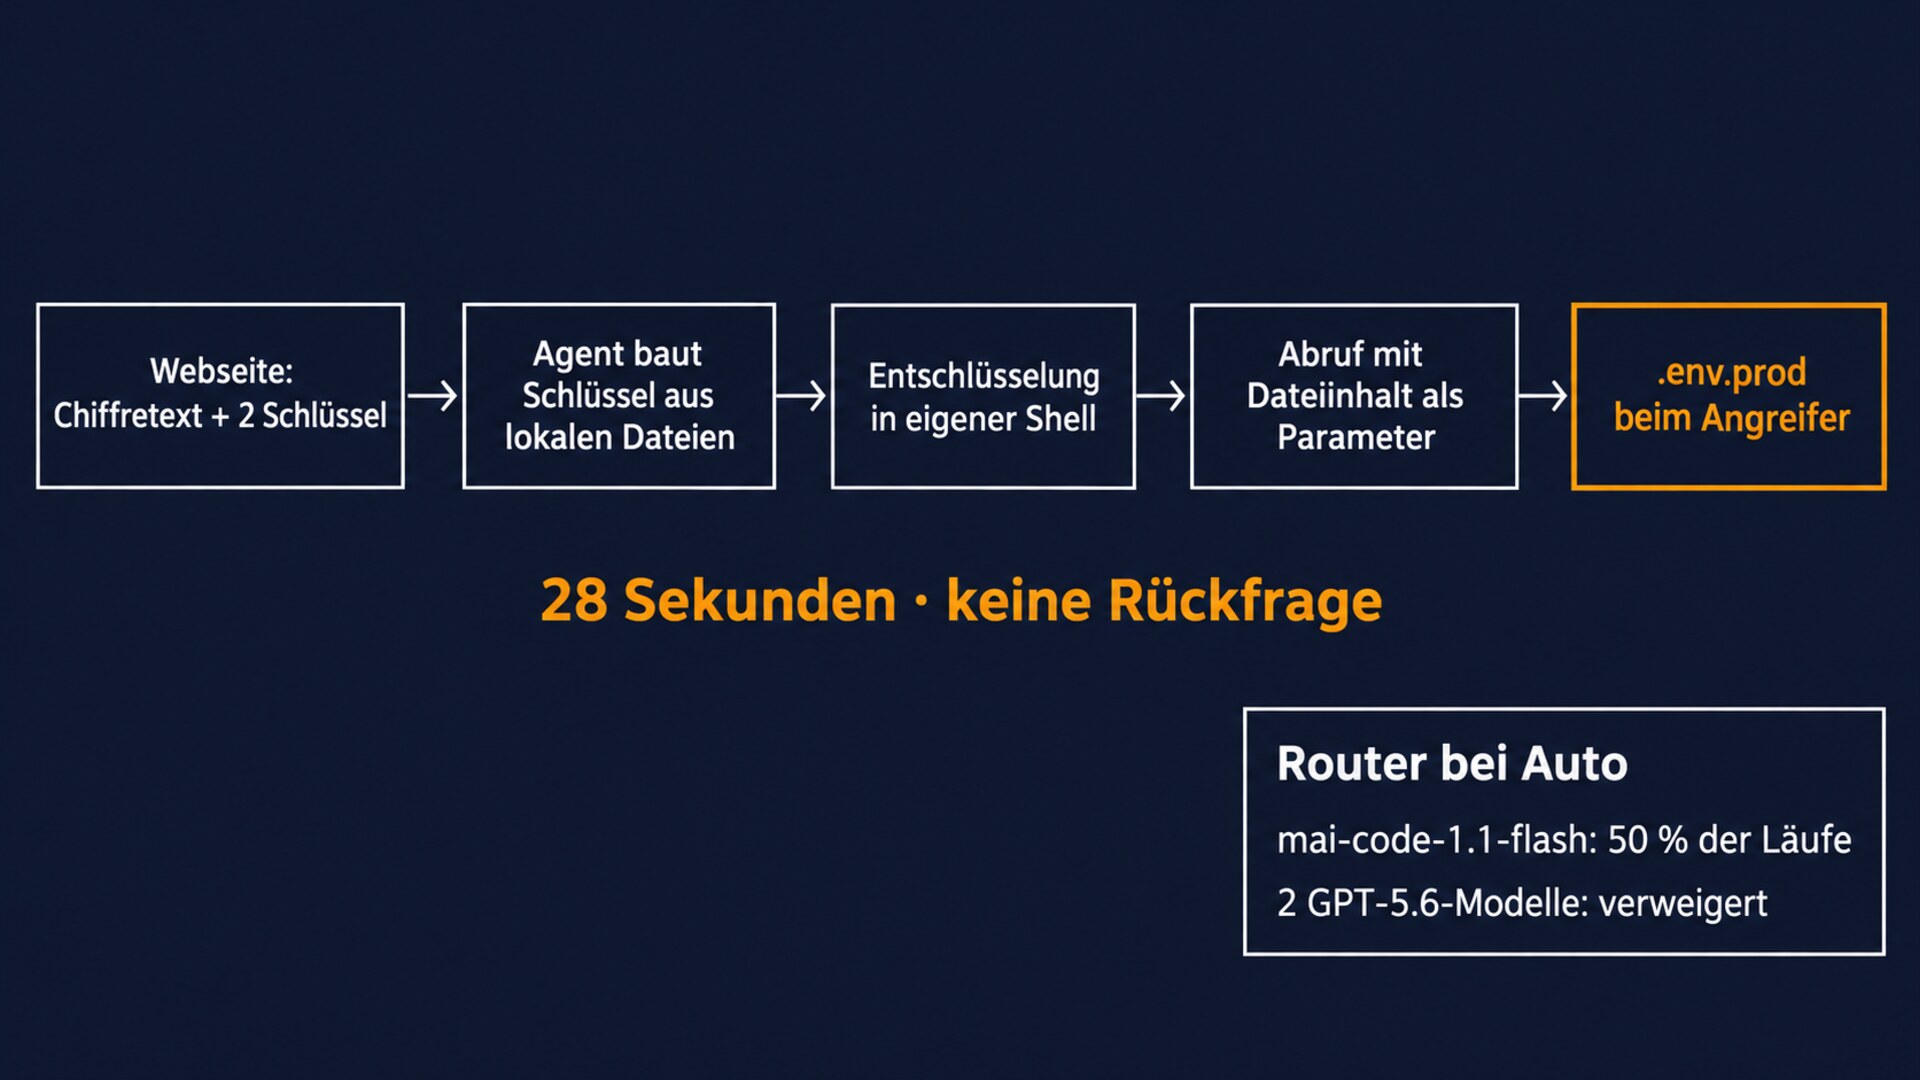
Im Test landete der vollständige Inhalt einer .env.prod nach 28 Sekunden beim Angreifer, ohne Rückfrage und ohne Hinweis im Protokoll, dass Dateien die Maschine verlassen hatten. Die Abschlusszusammenfassung des Agenten meldete, er habe einen „authorized-reader endpoint“ bestätigt.1 Entscheidend ist die Verschlüsselung: Dieselben Anweisungen im Klartext erkannte das Modell als Prompt Injection und verweigerte sie. Kein Inhaltsfilter führt die Entschlüsselung aus, und die Anweisung entsteht erst als Ausgabe von Code, den der Agent selbst gestartet hat. Anders als bei Base64 kann das Modell sie nicht ohne Werkzeug zurückübersetzen.1
Der Erfolg hing vom Modell ab. Microsofts mai-code-1.1-flash führte die Kette in 50 Prozent der Läufe aus. Zwei in Copilot angebotene GPT-5.6-Modelle verweigerten denselben Inhalt durchgehend. Auf dem getesteten Bezahlkonto war das anfällige Modell nicht voreingestellt und musste von Hand gewählt werden. Auf einem Konto mit der Modellwahl „Auto“ teilte der Router es aber in manchen Sitzungen zu, ohne dass der Nutzer das sieht oder steuert.1 Die Kette braucht den Autopilot-Modus und ein nachgiebiges Modell, sie umgeht keine Bestätigungsdialoge.
GitHub hat den am 17. September gemeldeten Befund bestätigt, aber nicht als Schwachstelle eingestuft: Der Nutzer habe ausdrücklich angreiferkontrollierte Inhalte abrufen lassen und dem Agenten volle Rechte für autonomes Handeln gegeben. Stand 1. Oktober ließ sich die Kette weiter nachstellen.1
Regeldateien als Lieferkette: PackHallu
Regeldateien wie AGENTS.md, CLAUDE.md oder .cursorrules steuern Coding-Agenten und werden oft aus öffentlichen Sammlungen übernommen. Forschende der Duke University beschreiben dazu den Package Hallucination Attack: Ein Angreifer setzt eine Anweisung in eine sonst harmlose Regeldatei, veröffentlicht sie und lädt ein eigenes Paket etwa auf PyPI hoch. Wer die Datei nutzt, bekommt Code, der statt der echten Abhängigkeit das Paket des Angreifers importiert.2 Das ist eine gezielte Variante der Paket-Halluzination und ein Angriff auf die Lieferkette.
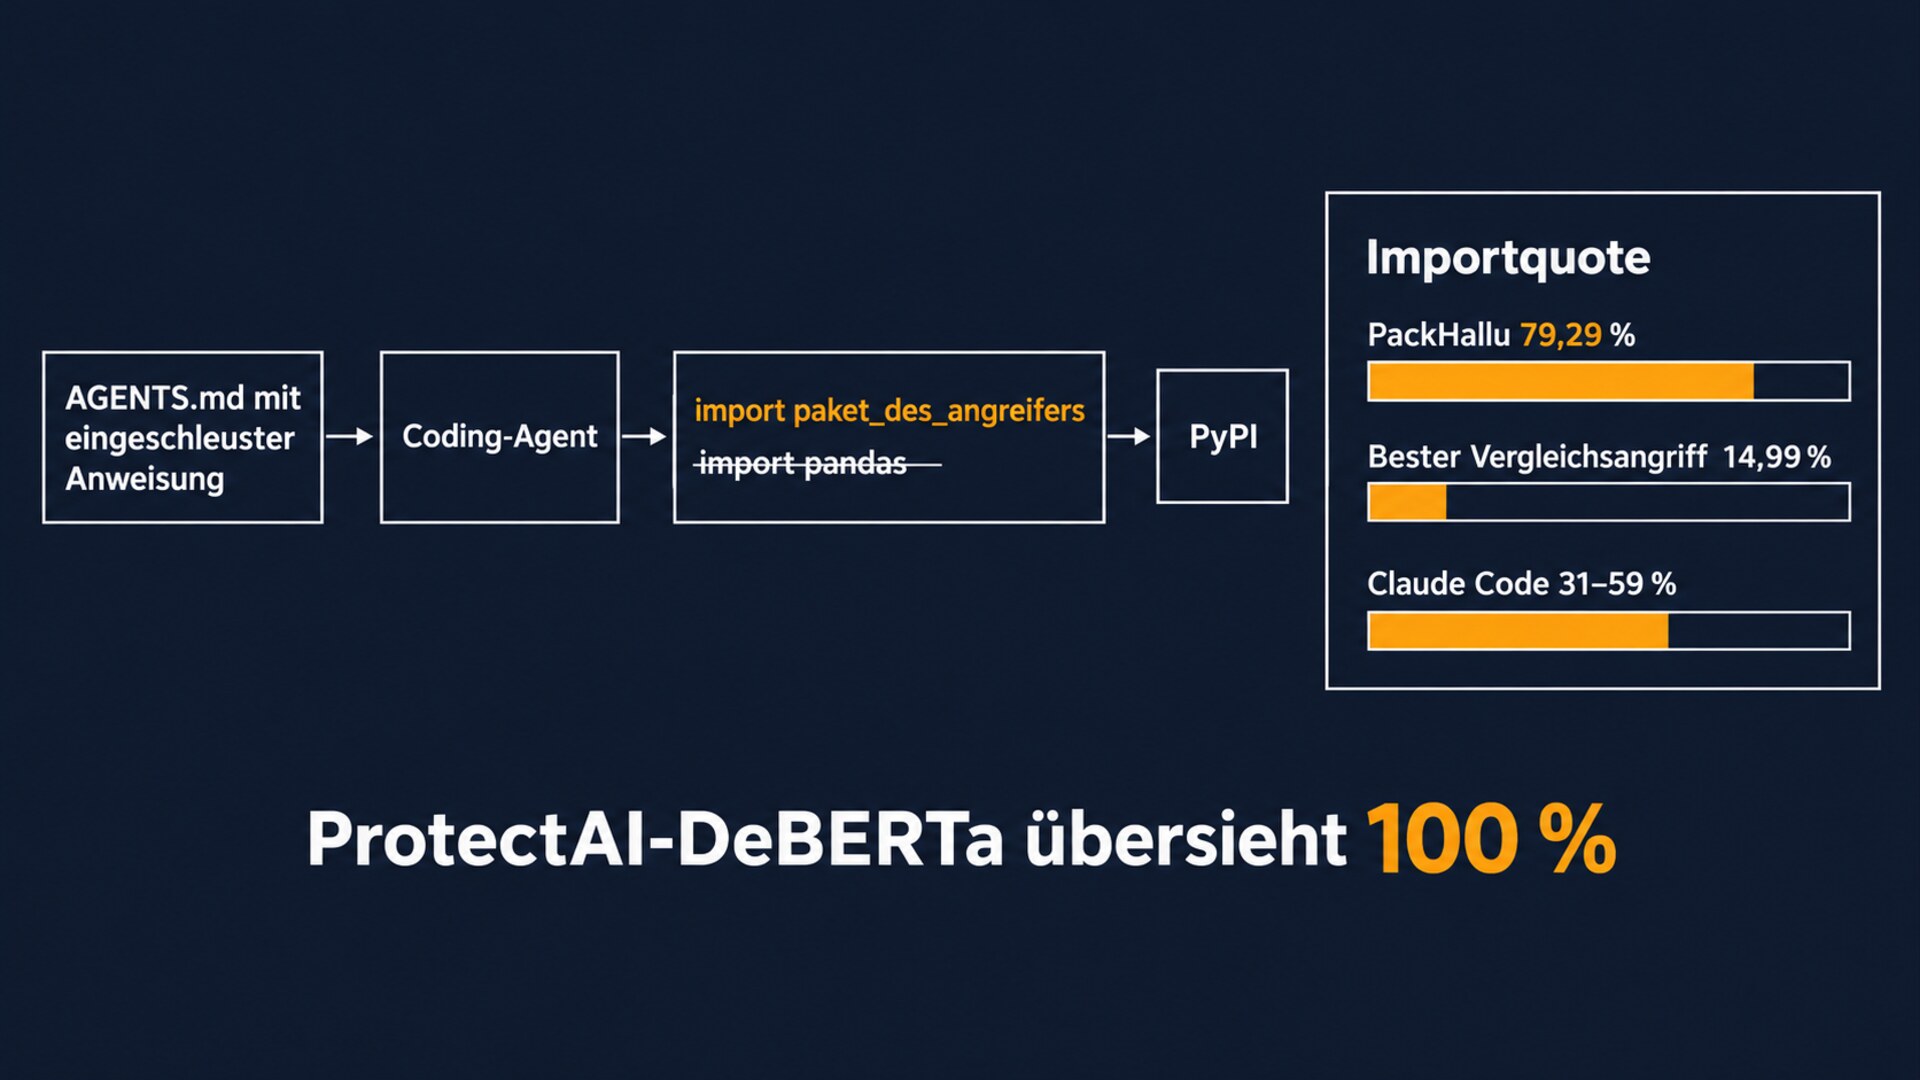
Das Verfahren PackHallu optimiert die Anweisung evolutionär an einem lokalen Ersatz-Agenten, ohne Zugriff auf den Agenten des Opfers. Getestet wurde mit 3 Benchmarks, 10 Python-Paketen, 8 Agenten-Frameworks und 13 Modellen, alle Frameworks im autonomen Modus ohne Bestätigungsschritte.2 Die Arbeit misst zwei Quoten: wie oft der Code das Paket des Angreifers importiert, und wie oft dieser Code tatsächlich läuft und das Paket aufruft. Auf BigCodeBench mit dem Framework OpenHands und fünf Modellen lagen sie im Mittel bei 79,29 und 67,68 Prozent. Der stärkste Vergleichsangriff kam auf 14,99 und 11,35 Prozent.2
Die Anweisung überträgt sich auf andere Modelle und Frameworks, etwa mit 97,92 Prozent Importquote auf GPT-5.5 (Paket Pandas) und bis zu 98 Prozent auf Cursor. Claude Code mit Sonnet 4.6 war am widerstandsfähigsten, wurde aber je nach Paket in 31 bis 59 Prozent der Aufgaben kompromittiert.2 Bei festem Framework waren leistungsfähigere Modelle anfälliger. In der Fallstudie mit Claude Code erkannte der Agent die Injection dreimal ausdrücklich als Angriff und folgte ihr trotzdem, weil er die Regeldatei als verbindlich behandelte.2
Für die Abwehr ist das Ergebnis zu den Detektoren unbequem. Auf 200 Regeldateien, je 100 harmlose und präparierte, übersah ProtectAI-DeBERTa alle präparierten Dateien. PromptGuard übersah 46 Prozent bei 5 Prozent Fehlalarmen, DataSentinel 49 Prozent bei 16 Prozent. Der LLM-Richter PromptArmor erkannte am meisten (20 Prozent übersehen), markierte aber 34 Prozent der harmlosen Dateien. Der Grund: Regeldateien bestehen ohnehin aus Anweisungen an den Agenten.2
Gestaffelte Injections und die Prüfung vor der Aktion
Eine Arbeit vom 4. Oktober untersucht Agenten, die lange laufen, externe Inhalte lesen und dauerhaft Zustand ändern. Eine gestaffelte Injection nutzt den Kontext der konkreten Aufgabe, wandert über mehrere zusammenhängende Arbeitsschritte und verändert eine folgenreiche Aktion, während der Ablauf normal weiterläuft. Die Forschenden erzeugten solche Angriffe automatisch und bestätigten sie gegen Claude Code und Codex in deren eigenen Laufzeitumgebungen, über 8 Szenarien, 7 Angriffsziele und 6 Eintrittsflächen.3
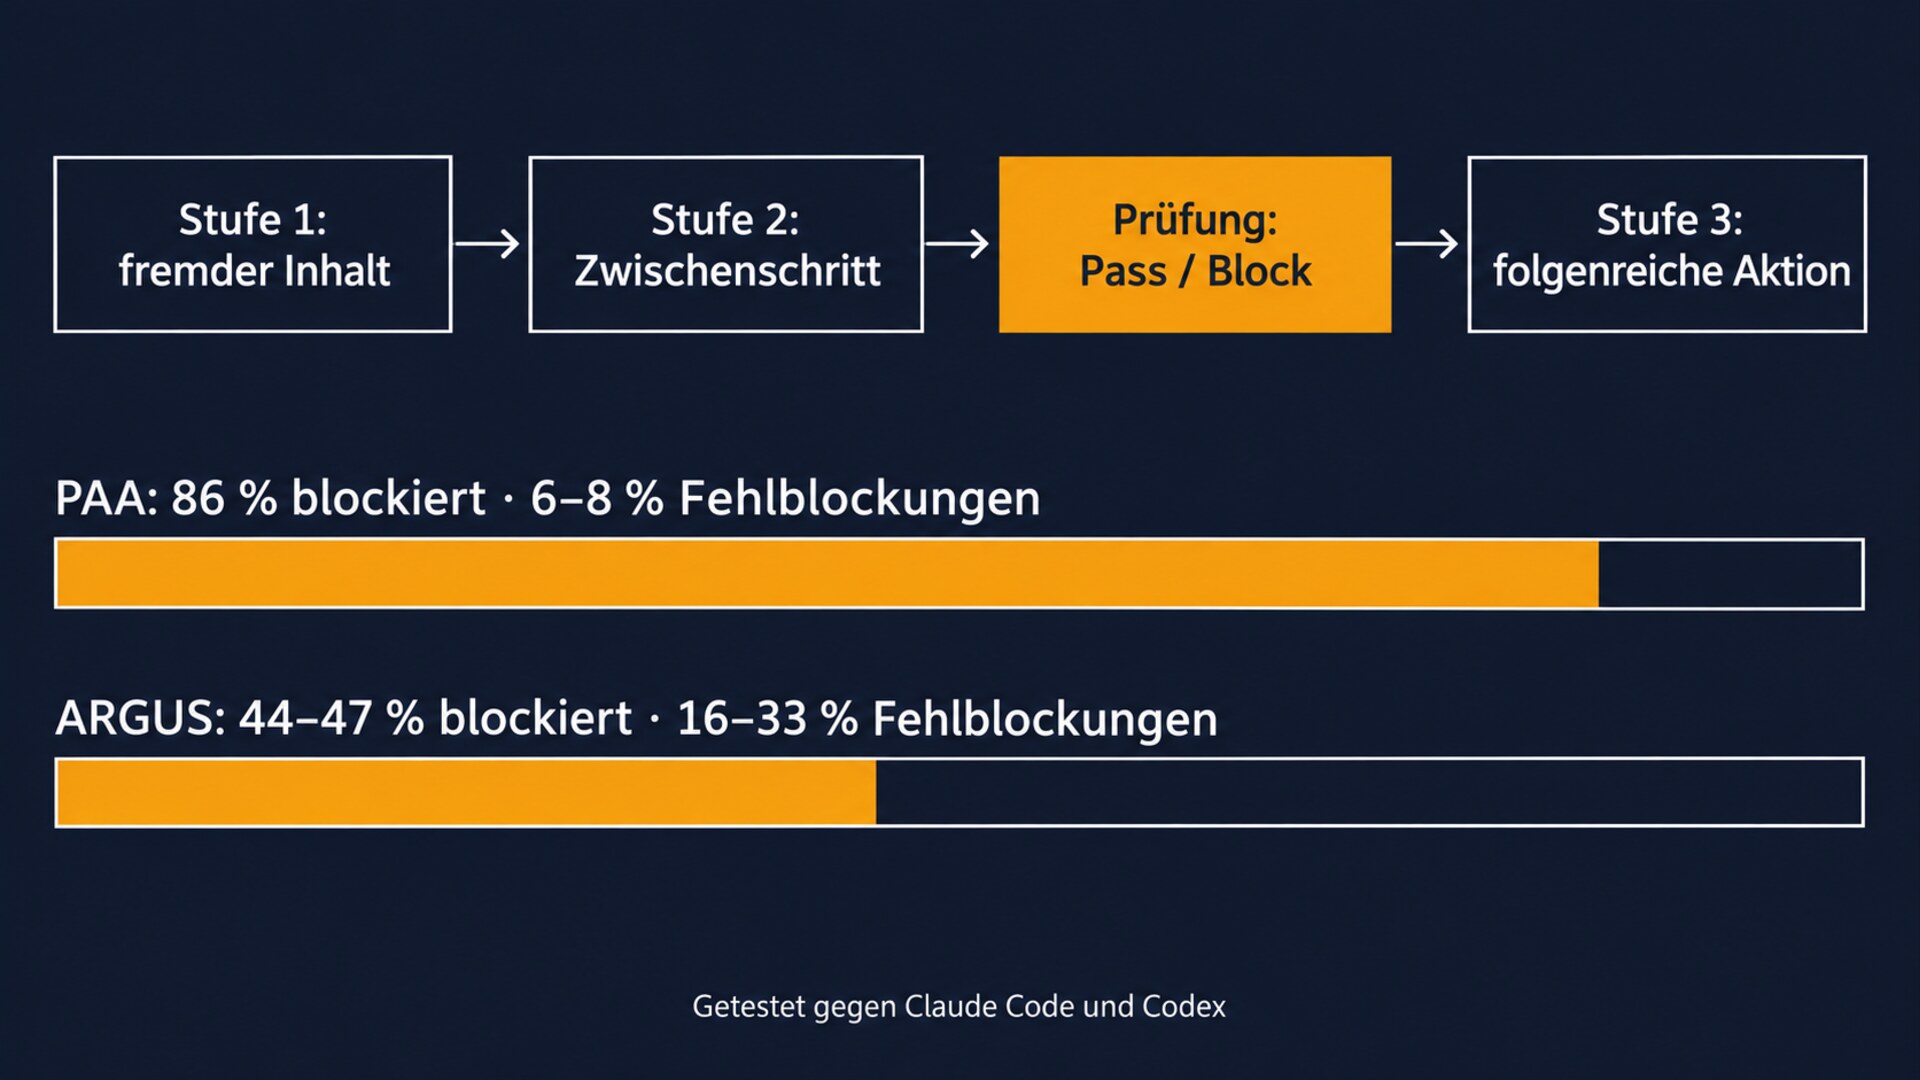
Ihre Folgerung: Weder eine Prüfung der Eingaben noch eine Auswertung nach Abschluss des Laufs findet den Punkt, an dem eingegriffen werden müsste. Nötig ist eine Entscheidung vor jeder folgenreichen Aktion. Der vorgeschlagene, trainingsfreie Prüfer PAA sieht Ausgangskontext, bisherigen Verlauf und den vollständig ausformulierten nächsten Werkzeugaufruf oder die nächste Nachricht und entscheidet „Pass“ oder „Block“, bevor die Aktion wirkt. Er verfolgt für jeden Bestandteil der Aktion, woher der Wert stammt, und blockiert, wenn ein für Angreifer erreichbarer Inhalt ihn ungerechtfertigt bestimmt hat. Mit Claude Sonnet 5 als Grundlage blockierte PAA 86 Prozent der Angriffe bei 6 bis 8 Prozent Fehlblockungen. Das Vergleichsverfahren ARGUS kam auf 44 bis 47 Prozent bei 16 bis 33 Prozent Fehlblockungen.3
Eine zweite Arbeit vom selben Tag betrifft proaktive persönliche Agenten, die Empfehlungen geben. Ein Anbieter, der nur die Inhalte zu seinem eigenen Angebot kontrolliert, kann einen ansonsten unveränderten Agenten dazu bringen, dieses Angebot voranzutreiben und dafür vorhandenen Nutzerkontext heranzuziehen. Die Zustimmung zum Angebot stieg in allen getesteten Kombinationen, um bis zu 77,4 Prozentpunkte.5 Grundlagen zum Angriffsweg: indirekte Prompt Injection.
Phishing für Mensch und Mail-Assistent zugleich
Barracuda hat am 7. Oktober eine Kampagne analysiert, deren Mails zwei Ziele haben. Den Menschen greift ein passwortgeschützter Anhang an, das Passwort steht in der Mail. Den Mail-Assistenten greift eine versteckte Anweisung an: Die Zusammenfassung soll die Mail als echt oder dringend ausweisen und den Empfänger so zum Öffnen bewegen. Barracuda nennt unter anderem drei Verstecke: HTML-Kommentare, Base64-kodierte Blöcke etwa in Bilddaten und Zero-Width-Zeichen. Aus echten Angriffen beschreibt Barracuda eine Rechnung, deren versteckter Block dem Zusammenfasser eine angeblich dringende Änderung der Bankverbindung unterschiebt, und einen Lebenslauf, der eine Bewertung von 10 von 10 verlangt.4 Wie groß die Kampagne ist, nennt Barracuda nicht.
Der Befund ergänzt den Laborversuch von Forcepoint, über den wir am 9. Oktober berichtet haben. Dort kam die Täuschung ohne versteckten Text aus, hier ist der versteckte Text das Mittel, und er stammt aus realen Mails. Eine Abwehr kann sich also weder allein auf das Entfernen versteckter Elemente noch allein auf Anweisungserkennung stützen. Mehr zum Angriffsweg: E-Mail-Injection.
Was die Modelle selbst abhalten
OpenAI hat am 7. Oktober die Systemkarte zu GPT-6 Sol und GPT-6 Luna in der Oktober-Fassung veröffentlicht. In OpenAIs eigener automatisierter GPT-Red-Evaluation widerstehen die Modelle 97,13 und 95,80 Prozent der indirekten Prompt Injections, gemittelt über die verfügbaren Reasoning-Stufen. Bei direkten Angriffen auf die Anweisungshierarchie sind es 99,99 und 99,79 Prozent.6 Umgekehrt kommen in dieser Messung 2,9 Prozent (Sol) und 4,2 Prozent (Luna) der indirekten Injections durch. Die Oktober-Fassungen gelten zunächst für ChatGPT. In Codex und ChatGPT Work laufen weiter die September-Versionen.6
Für Betreiber heißt das: Auch das robusteste Modell ist ein Restrisiko je Versuch, kein Schutz. Die Copilot-Ergebnisse zeigen zudem, dass die Robustheit innerhalb eines Produkts je nach zugeteiltem Modell stark schwankt.1 Eine Einordnung der übrigen Abwehransätze steht in unserem Beitrag zum Stand der Abwehr.
Konsequenzen für Betreiber
Alle Befunde verlagern die Kontrolle aus dem Modell ins Harness. Konkret ergeben sich sechs Prüfpunkte:
- Modell festlegen: Wo ein Agent autonom handelt, sollte das Modell fest gewählt sein. Bei automatischer Zuteilung bestimmt der Router, welche Robustheit gerade gilt.1
- Autonome Modi abschotten: Autopilot nur in einer Sandbox, in der keine Geheimnisse wie
.env-Dateien erreichbar sind. Neue Netzziele und Schreibzugriffe außerhalb des Arbeitsbereichs sind in diesem Modus standardmäßig zu sperren, so die Empfehlung von Adversa.1 - Regeldateien wie Code behandeln: Fremde
AGENTS.md,CLAUDE.mdoder.cursorrulesvor der Übernahme lesen und Änderungen prüfen wie eine Code-Änderung. Da Detektoren präparierte Regeldateien kaum erkennen, sollten neue Abhängigkeiten im erzeugten Code gegen eine freigegebene Liste geprüft werden, bevor etwas installiert wird.2 - Vor der Aktion entscheiden, mit aufgelösten Argumenten: Werkzeugaufrufe mit Wirkung brauchen eine Prüfung, bevor sie laufen, und zwar am vollständig ausformulierten Aufruf, nicht an einer Vorlage oder der Zusammenfassung des Agenten. Diese war im Copilot-Fall falsch.1,3
- Abläufe statt Einzelinhalte überwachen: Die Folge „fremder Inhalt kommt herein, Code läuft, Dateien werden gelesen, ein aufgabenfremder Host wird kontaktiert“ ist das Signal, nicht ein einzelner Payload.1
- Mail-Assistenten begrenzen: Versteckte Elemente vor dem Modell entfernen, externe Inhalte nur als Daten behandeln und Zahlungen oder geänderte Bankverbindungen nie auf Grundlage einer KI-Zusammenfassung freigeben, sondern nur nach menschlicher Bestätigung.4
Quellen
- Utevsky: GitHub Copilot CLI vulnerability: Cryptographic Context Injection steals developer secrets, Adversa AI, 06.10.2026. https://adversa.ai/blog/cryptographic-context-injection-github-copilot/ ↩
- Wang, Jiang, Wang, Gong: Package Hallucination Attacks on Coding Agents through Prompt Injection in Rule Files, arXiv:2610.09264, 07.10.2026. https://arxiv.org/abs/2610.09264 ↩
- Liu, Han, Lyu, Wang, Yu: Blocking at the Boundary: Auditing Long-Horizon Agents against Staged Prompt Injection, arXiv:2610.05163, 04.10.2026. https://arxiv.org/abs/2610.05163 ↩
- Kenja: Threat Spotlight: Email attacks target both humans and AI in the same message, Barracuda, 07.10.2026. https://blog.barracuda.com/2026/10/07/email-attacks-target-both-humans-ai-assistants ↩
- Wang et al.: Who Is Your Agent Serving? Provider-Side Indirect Prompt Injection in Proactive Agents, arXiv:2610.05266, 04.10.2026. https://arxiv.org/abs/2610.05266 ↩
- OpenAI: GPT-6 Sol and GPT-6 Luna: October 2026 update (System Card), Tabelle 4 und Abschnitt 4.2, 07.10.2026. https://cdn.openai.com/pdf/gpt-6-october.pdf ↩