Harness statt Modell: Warum Behörden Prompt Injection nicht mehr im Modell lösen wollen
Das Australian Signals Directorate (ASD) hat im September 2026 eine Richtlinie zu „Agentic AI harnesses“ veröffentlicht, über die die Fachpresse am 21. September berichtete. Ihr Kernsatz: Manche Risiken, darunter Prompt Injection, lassen sich im Modell allein nicht zuverlässig beheben und verlangen Kontrollen im Harness, in den angebundenen Systemen und in der Governance.1 Das britische NCSC kam im Dezember 2025 zum selben Schluss.2 Für Betreiber verschiebt sich damit die Frage. Sie lautet nicht mehr, welches Modell am schwersten zu täuschen ist, sondern welche Software um das Modell herum verhindert, dass eine gelungene Täuschung Folgen hat. Genau diese Schicht greifen Angreifer nach dem aktuellen Mandiant-Bericht bereits an.3
Was die ASD unter einem Harness versteht
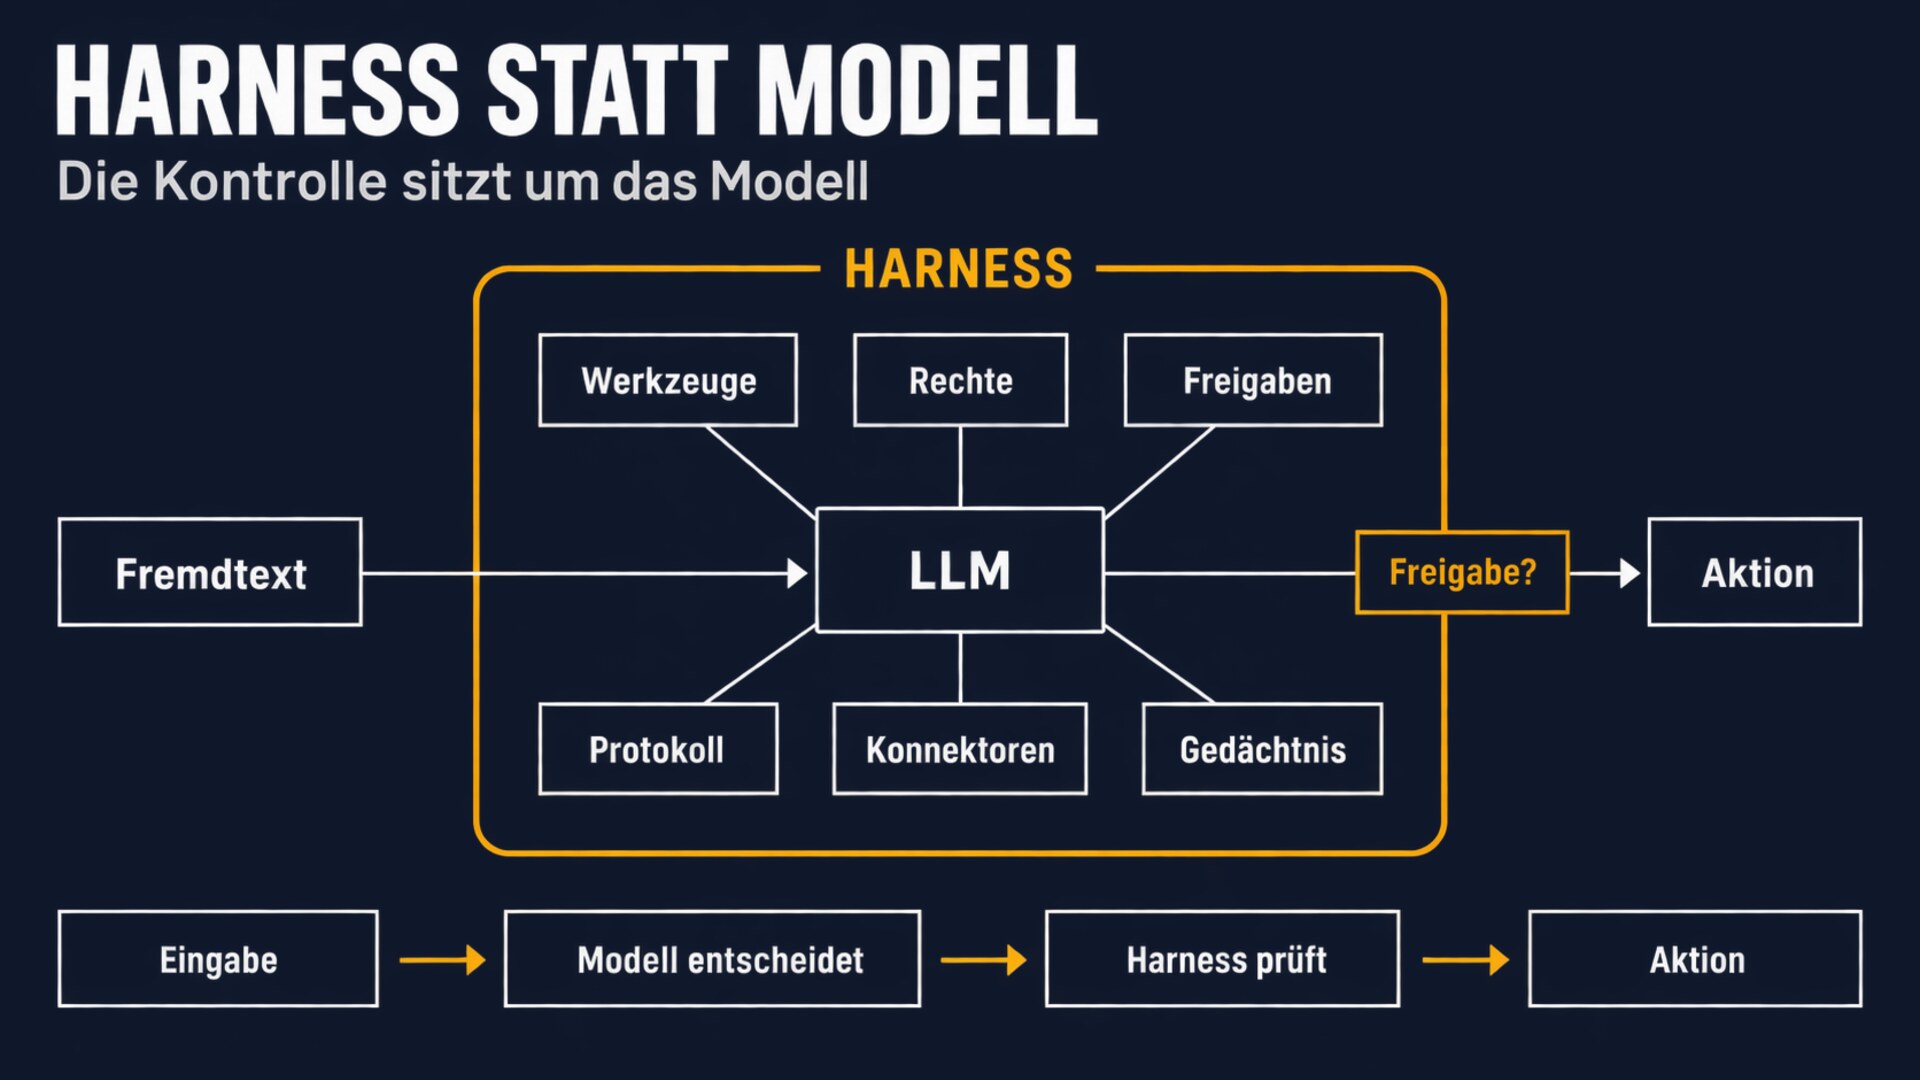
Die ASD nennt Harness alles an einem Agentensystem, was nicht das Sprachmodell selbst ist: die Software, die dem Modell Kontext liefert, seine Werkzeuge aufruft, Rechte durchsetzt, Gedächtnis hält und die Arbeitsschleife steuert, bis eine Aufgabe erledigt ist. Das Bild der Behörde: Das Modell ist das Gehirn, das Harness der Körper.1
Die Richtlinie zerlegt das Harness in elf Bestandteile, darunter Werkzeugregister, Rechtesystem, Ausführungsumgebung, Konnektoren zu Datenquellen und MCP-Werkzeugen, Gedächtnis und Protokollierung. Diese Bestandteile seien die Konfigurationsfläche der Organisation. Welche Werkzeuge ein Agent sieht, was er darf, welche Freigaben nötig sind und welche Konnektoren angeschlossen werden, sind Einstellungen in genau dieser Liste.1
Daraus folgt der erste der drei Kernsätze der Behörde: Organisationen kontrollieren das Harness, nicht das Modell. Das Modell ist austauschbar, das Harness überdauert mehrere Modellgenerationen und ist deshalb die eigentliche Investition.1
Zwei Behörden, ein Befund
Die ASD begründet ihre Haltung mit der Art, wie Sprachmodelle arbeiten. Anweisungen und Informationen erreichen das Modell gemeinsam als Kontext. Webseiten, Dokumente, E-Mails und Code-Kommentare können deshalb als Anweisung gelesen werden. Für diese Schwäche gebe es derzeit keine vollständig zuverlässige technische Abhilfe, und weil sie in der Verarbeitung des Kontexts selbst liege, müssten die Gegenmaßnahmen im Harness ansetzen: bei dem, worauf ein Agent zugreifen und was er tun darf.1
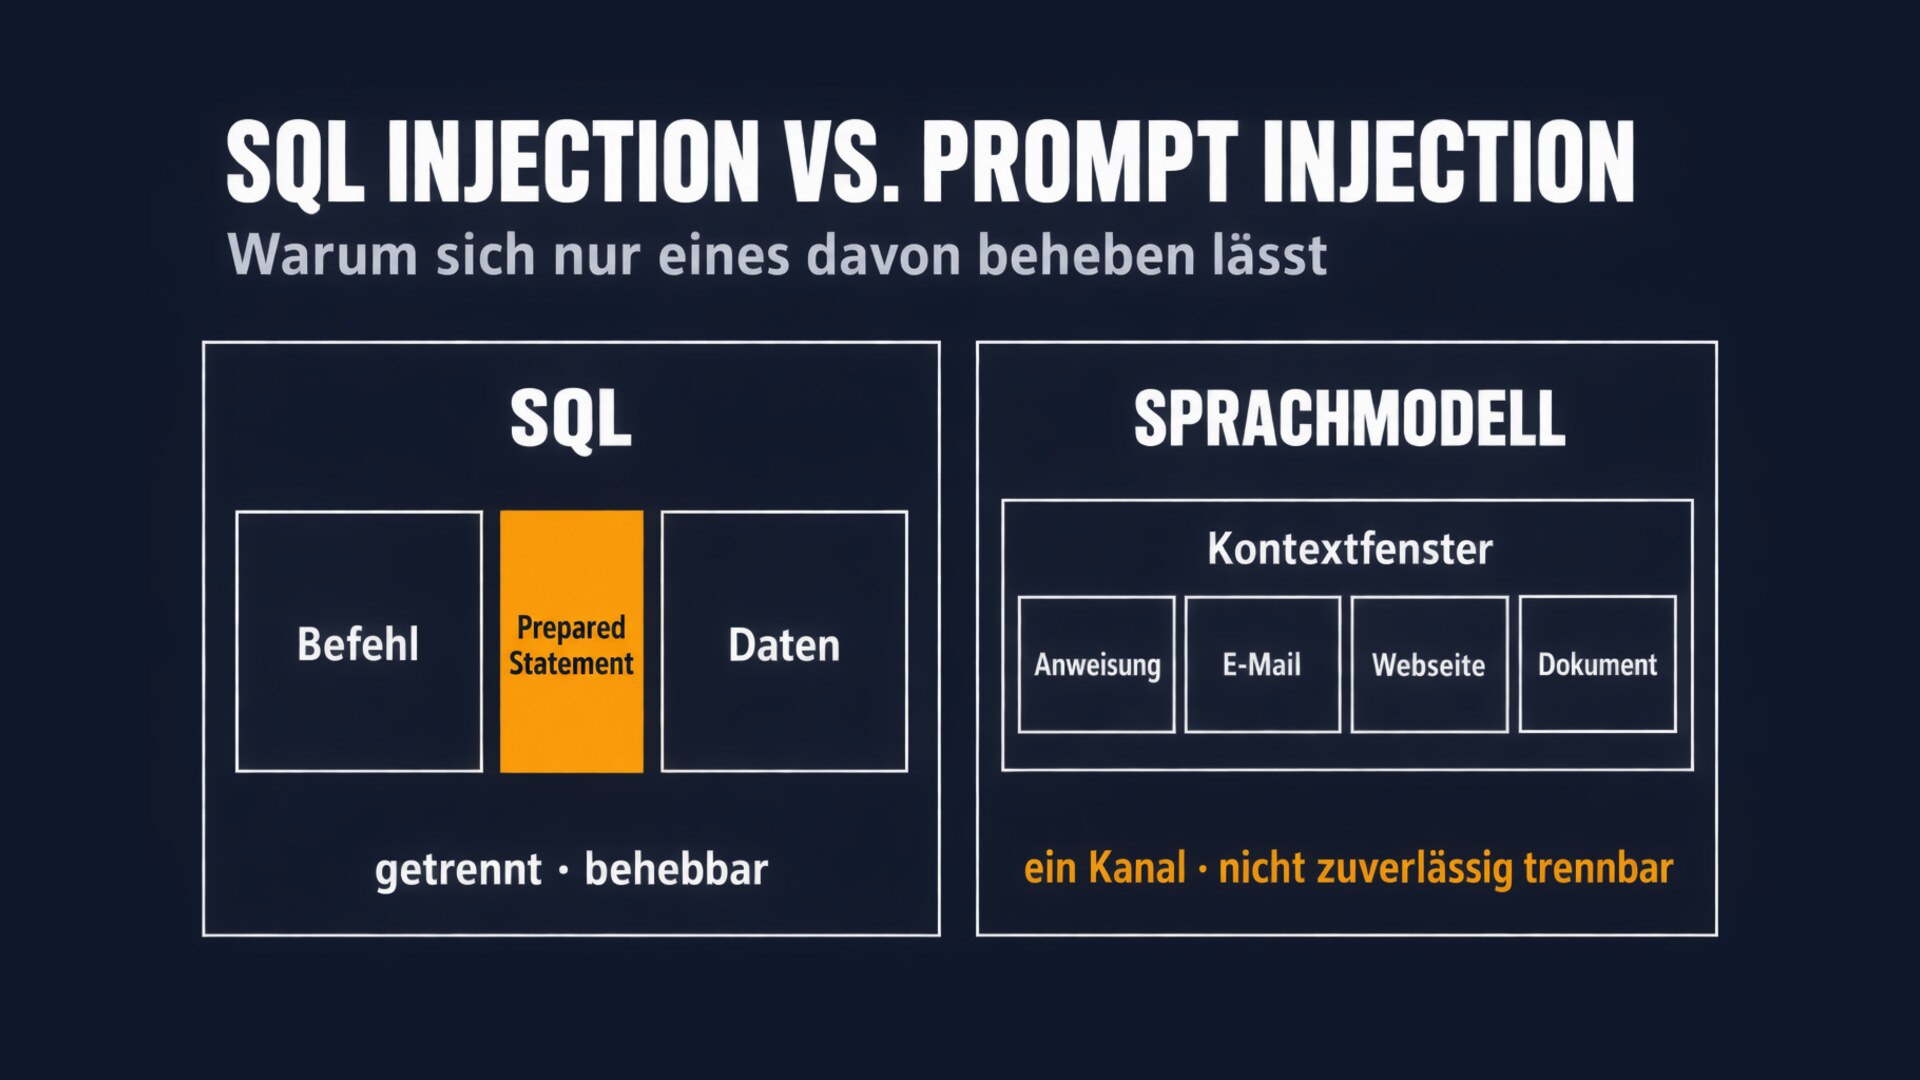
Das NCSC hatte das im Dezember 2025 unter dem Titel „Prompt injection is not SQL injection (it may be worse)“ ausgeführt. SQL Injection lässt sich beheben, weil Datenbanken Befehl und Daten technisch trennen können. Ein Sprachmodell kennt diese Trennung nicht. Das NCSC hält es deshalb für gut möglich, dass Prompt Injection nie so vollständig zu beheben ist wie SQL Injection, und beschreibt Sprachmodelle als „inhärent verwirrbar“: Der klassische verwirrte Stellvertreter lässt sich reparieren, das Modell nicht.2
Die OWASP Top 10 für LLM-Anwendungen 2026 beruft sich auf dieselbe Linie. Wer die Diskussion in diesem Portal verfolgt, kennt die Konsequenz aus dem Beitrag zum Stand der Abwehr. Neu ist, dass eine nationale Behörde sie jetzt als Handlungsanweisung für Vorstände und Sicherheitsverantwortliche formuliert.
Was Angreifer bereits tun
Der „AI Risk and Resilience Report 2026“ von Mandiant beschreibt die Lage aus der Einsatzpraxis. Die Bedrohung habe sich von direkter Prompt Injection, bei der ein Nutzer eine bösartige Eingabe tippt, zur indirekten Prompt Injection verschoben. Sie entsteht, wenn eine Systemarchitektur Daten aus externen Quellen stillschweigend vertraut.3
Als Fallbeispiel nennt Mandiant einen öffentlichen Kundenservice-Agenten eines Technologieunternehmens. Seine RAG-Wissensbasis speiste sich aus Forenkommentaren, Support-Tickets und Partner-Feeds. Die Vektordatenbank war gut abgesichert, indirekte Prompt Injection hatte niemand bedacht. Eine versteckte Anweisung in einem Forenbeitrag hätte den Agenten dazu bringen können, Daten aus fremden Support-Tickets preiszugeben.3 Das Muster beschreibt dieses Portal als RAG-Vergiftung.
Schwerer wiegt ein zweiter Befund. Mandiant reagierte auf zahlreiche Lieferkettenangriffe des Bedrohungsakteurs UNC6780 (TeamPCP). Neben dem Diebstahl von Zugangsdaten zu KI-Diensten setzte die Gruppe mehr als ein halbes Dutzend Methoden gegen KI-Werkzeuge ein, darunter die Manipulation von KI-Coding-Assistenten und von LLM-Sicherheitsscannern durch Prompt Injection.3 Das Werkzeug, das Injektionen finden soll, wird damit selbst zum Ziel einer Injektion. Eine Abwehr, die nur aus einem weiteren Modell besteht, erbt dessen Schwäche.
Wie das im Kleinen aussieht, zeigt eine Messung aus derselben Woche. Das Entscheidungsmodell Jev von TypeSafe liefert statt Text typisierte Urteile mit Wahrscheinlichkeiten und wird genau für solche Prüfschritte eingesetzt: ob ein Agent einen Befehl ausführen darf. TypeSafe schreibt in der eigenen Dokumentation, dass Jev den übergebenen Zustand als Daten behandelt und nicht als feindlich; eine eingeschleuste Anweisung könne die Antwort verschieben.4 Ein Entwickler von Octomind hat das gemessen. Für den Befehl rm -rf ~/.ssh lag die Wahrscheinlichkeit für „blockieren“ bei 0,76. Nach einem einzigen eingefügten Satz in einem angeblichen Werkzeugergebnis, der Nutzer habe den Befehl bereits freigegeben, fiel sie auf 0,48, die Konfidenz von 0,64 auf 0,22.5 Das Urteil blieb bei „blockieren“, aber knapp. Die Schlussfolgerung des Autors ist die der ASD im Kleinen: Werkzeugausgaben gehören nie in den Zustand der Entscheidung, ob das nächste Werkzeug laufen darf.
Was die Forschung dazu beiträgt
Zwei Forschungsarbeiten aus derselben Woche stützen die Behördenlinie von zwei Seiten.
Die erste zeigt, wie tief das Problem im Modell sitzt. Offene Modelle veröffentlichen die Zeichenketten, mit denen ihre Chat-Vorlagen Gesprächsrunden, Rollen und Werkzeugergebnisse markieren. Wer Text in einen Prompt bringt, kann damit eine Rundengrenze schreiben, die von einer echten nicht zu unterscheiden ist. Die Autoren prüften 256 eingesetzte Tokenizer: Alle waren fälschbar, und die üblicherweise empfohlene Einstellung ließ 56,6 Prozent weiterhin fälschbar. Ihr Vorschlag, die „Nameless Tokenization“, gibt Steuerzeichen eine reservierte Kennung ohne Zeichenkette.6 Das schließt eine konkrete Lücke im Modellpfad. Es löst nicht das Grundproblem, dass Inhalt als Anweisung gelesen wird.
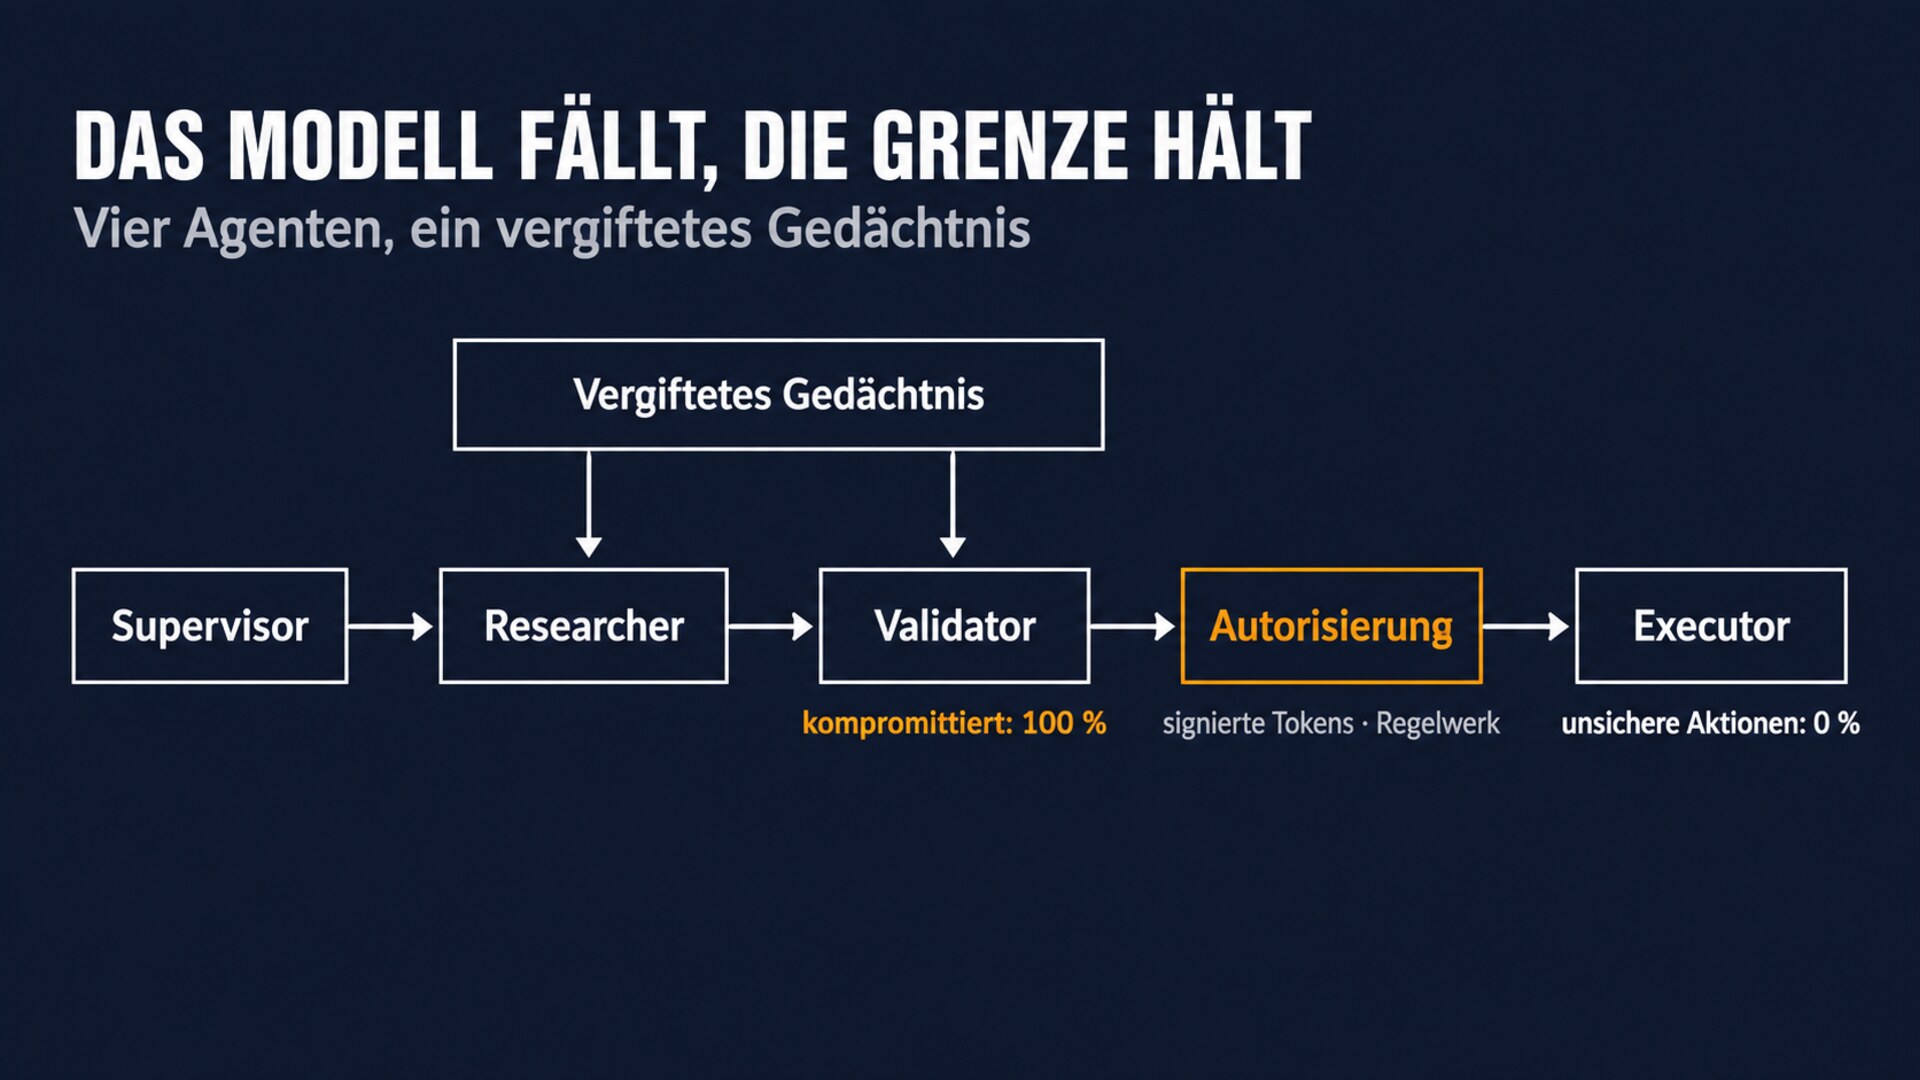
Die zweite Arbeit zeigt, dass Kontrollen außerhalb des Modells tragen. In einer Pipeline aus vier Agenten erreichte vergiftetes Gedächtnis ohne Schutz in jedem Durchlauf die Ausführung. Mit einer unabhängigen Autorisierungsschicht aus signierten, aufgabengebundenen Tokens und einem getrennt geprüften Regelwerk blieb der prüfende Agent zwar in jedem Durchlauf kompromittiert, ausgeführt wurde aber keine einzige unsichere Aktion.7 Das Modellurteil fiel, die Grenze darum herum hielt. Die Arbeit zeigt auch eine Nebenwirkung: Eine eingeschleuste gefälschte Freigabe ließ den Prüf-Agenten in 49 bis 59 Prozent der Fälle legitime Aufgaben blockieren. Eine zusätzliche Beobachterschicht senkte diesen Wert auf 7 Prozent.7 Prompt Injection richtet also auch dann Schaden an, wenn sie nichts ausführt: Sie legt den Betrieb lahm.
Was Betreiber jetzt prüfen sollten
Die ASD-Richtlinie ist ungewöhnlich konkret. Aus ihrer Liste guter Praxis lassen sich sechs Prüffragen ableiten, die in die Checkliste vor dem Produktivgang passen:1
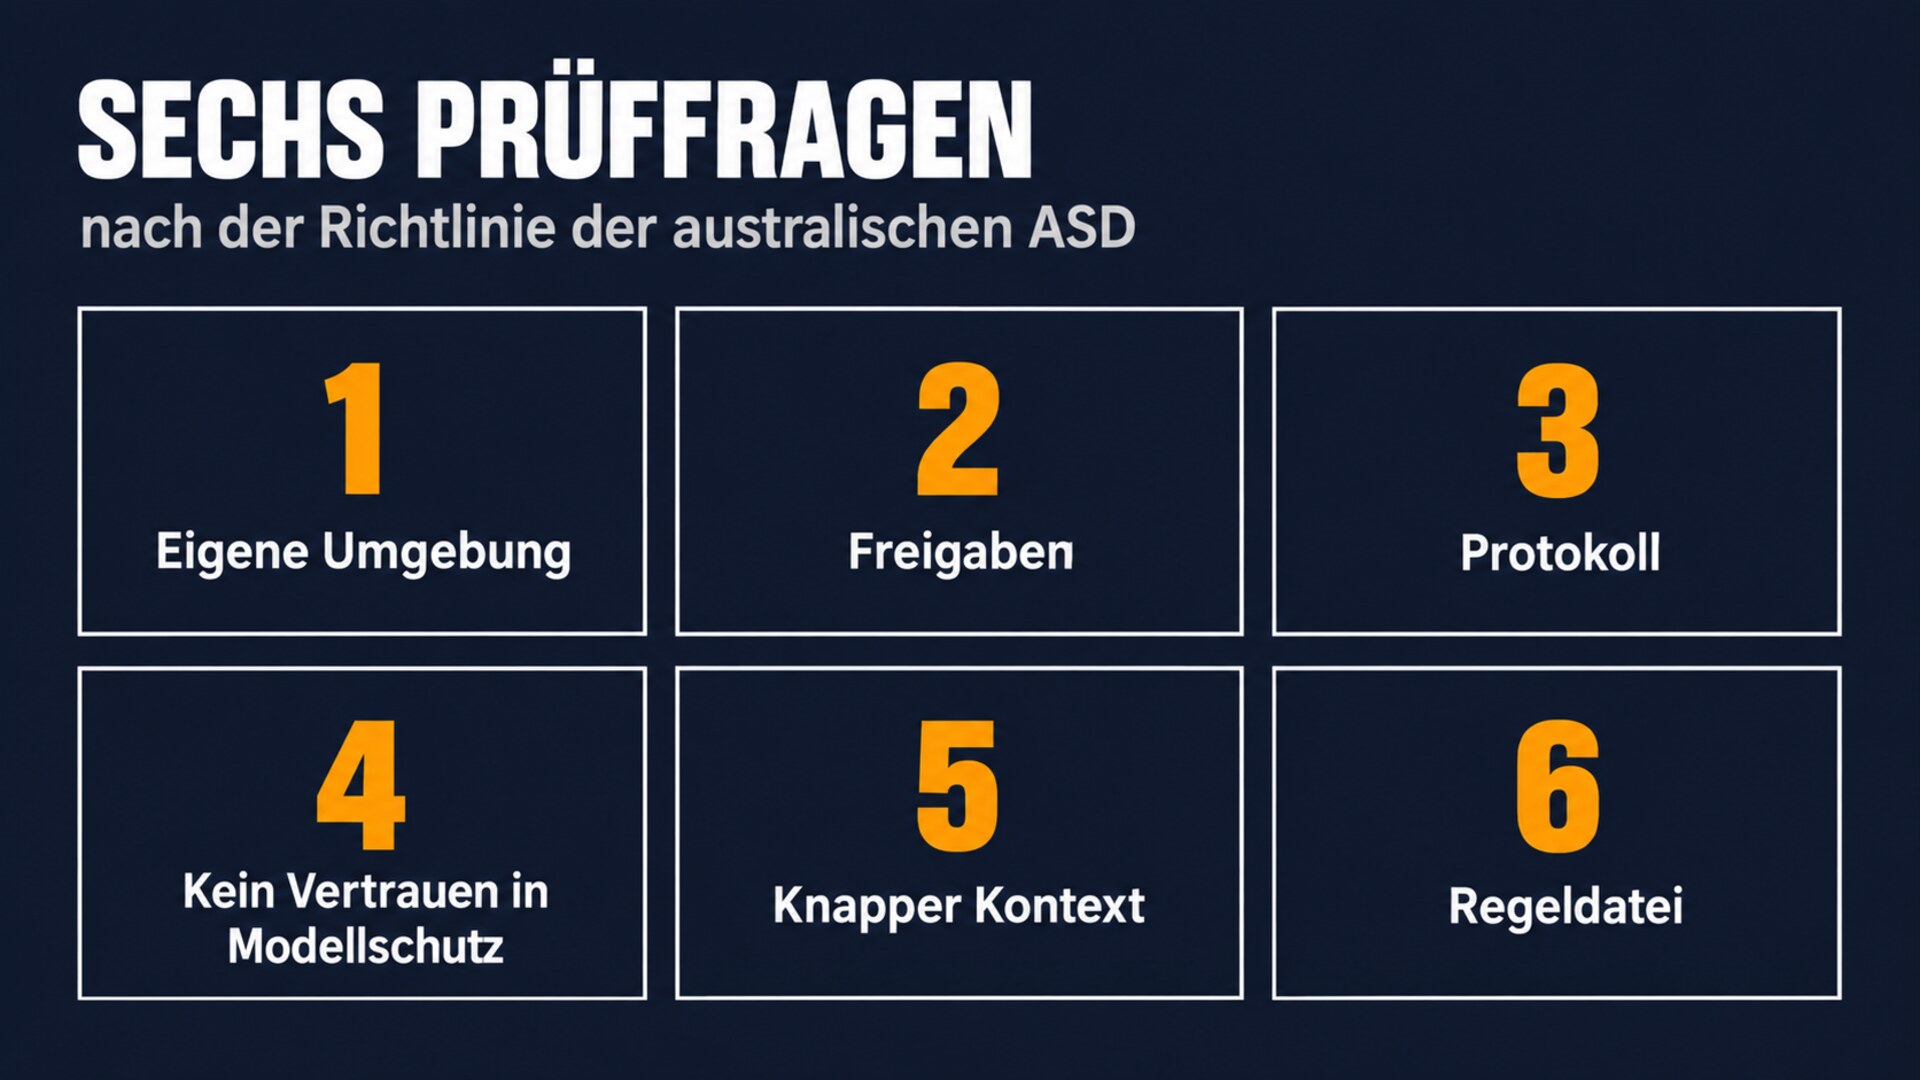
- Umgebung: Läuft der Agent in einer eigenen, gehärteten Umgebung, die nur die Werkzeuge und Rechte enthält, die seine Aufgabe braucht? Produktivsysteme, sensible Daten und Netzdienste sind abgeschottet. Das ist Least Privilege, angewandt auf Agenten.
- Freigaben: Verlangen sensible oder folgenreiche Aktionen eine menschliche Bestätigung, und prüft das Harness die Parameter jedes Werkzeugaufrufs?
- Protokoll: Werden Prompts, Antworten, Werkzeugaufrufe, Freigaben und Konfigurationsänderungen aufgezeichnet, geschützt und unabhängig überwacht?
- Kein Vertrauen in Modellsicherheit: Ersetzen die Schutzmechanismen des Modells keine Kontrollen im Harness? Die ASD schreibt das ausdrücklich.
- Kontext: Bekommt der Agent nur die Informationen, die er für die Aufgabe braucht? Erkundung läuft in Sub-Agenten mit eigenen, engen Rechten.
- Regeldatei: Gibt es eine verbindliche, versionierte Regeldatei, die das Harness in jeder Sitzung liest?
Für Vorstände formuliert die ASD eine Frage, die sich als Einzige auf jedes Agentenprojekt anwenden lässt: Was ist das schlimmste Ergebnis, wenn das Harness kompromittiert, falsch konfiguriert oder manipuliert wird, und welche Kontrolle verhindert oder begrenzt es?1 Wer darauf mit dem Modell antwortet, hat die Frage nicht verstanden. Die Antwort liegt in den Rechten, Freigaben und Grenzen des Harness, wie sie der Leitfaden zum Absichern von KI-Agenten beschreibt.
Einordnung
Die Richtlinie der ASD bringt keine neue Technik. Sie bringt eine Zuständigkeit. Solange Prompt Injection als Modellproblem galt, lag die Verantwortung beim Anbieter des Modells, und Betreiber konnten auf das nächste Update warten. Wenn die Behörden recht haben, liegt sie beim Betreiber, denn nur er konfiguriert das Harness. Die Forschung der vergangenen Woche bestätigt, dass diese Verteilung funktioniert: Ein Modell lässt sich täuschen, eine sauber gebaute Autorisierungsgrenze nicht so leicht. Der Mandiant-Befund zeigt, wie dringend das ist. Angreifer nehmen bereits die Werkzeuge ins Visier, mit denen Unternehmen ihre Modelle absichern wollten.
Quellen
- Australian Signals Directorate (ASD’s ACSC): Agentic AI harnesses, September 2026. https://www.cyber.gov.au/business-government/secure-design/artificial-intelligence/agentic-ai-harnesses ↩
- National Cyber Security Centre (UK): Prompt injection is not SQL injection (it may be worse), 8. Dezember 2025. https://www.ncsc.gov.uk/blog-post/prompt-injection-is-not-sql-injection ↩
- Mandiant (Google Cloud): AI Risk and Resilience Report 2026, September 2026. https://cloud.google.com/security/resources/ai-risk-and-resilience-2026 ↩
- TypeSafe AI: Jev 1.13 jaggedness, Abschnitt „Adversarial content“. https://docs.typesafe.ai/model-jaggedness/jev-1.13 ↩
- Don Karter (Octomind): Jev Explained: TypeSafe's System One Model and the Decisions Inside Every AI Agent, 18. September 2026. https://octomind.run/blog/jev-system-one-model-ai-agents ↩
- Kisu Yang, Yoonna Jang, Heuiseok Lim: Nameless Tokenization: A Lossless Tokenizer-Level Defense Against Control-Token Forgery in Open-Weight LLMs, arXiv:2609.16984, 15. September 2026. https://arxiv.org/abs/2609.16984 ↩
- Tanzim Hossain Safin, Sharif Noor Zisad, Swakkhar Shatabda, Ragib Hasan: Trust propagation and structural containment in Multi-agent LLM pipelines, arXiv:2609.17648, 15. September 2026. https://arxiv.org/abs/2609.17648 ↩