Rückfragen, Würmer, kodierte Befehle: Fünf neue Befunde zu KI-Agenten
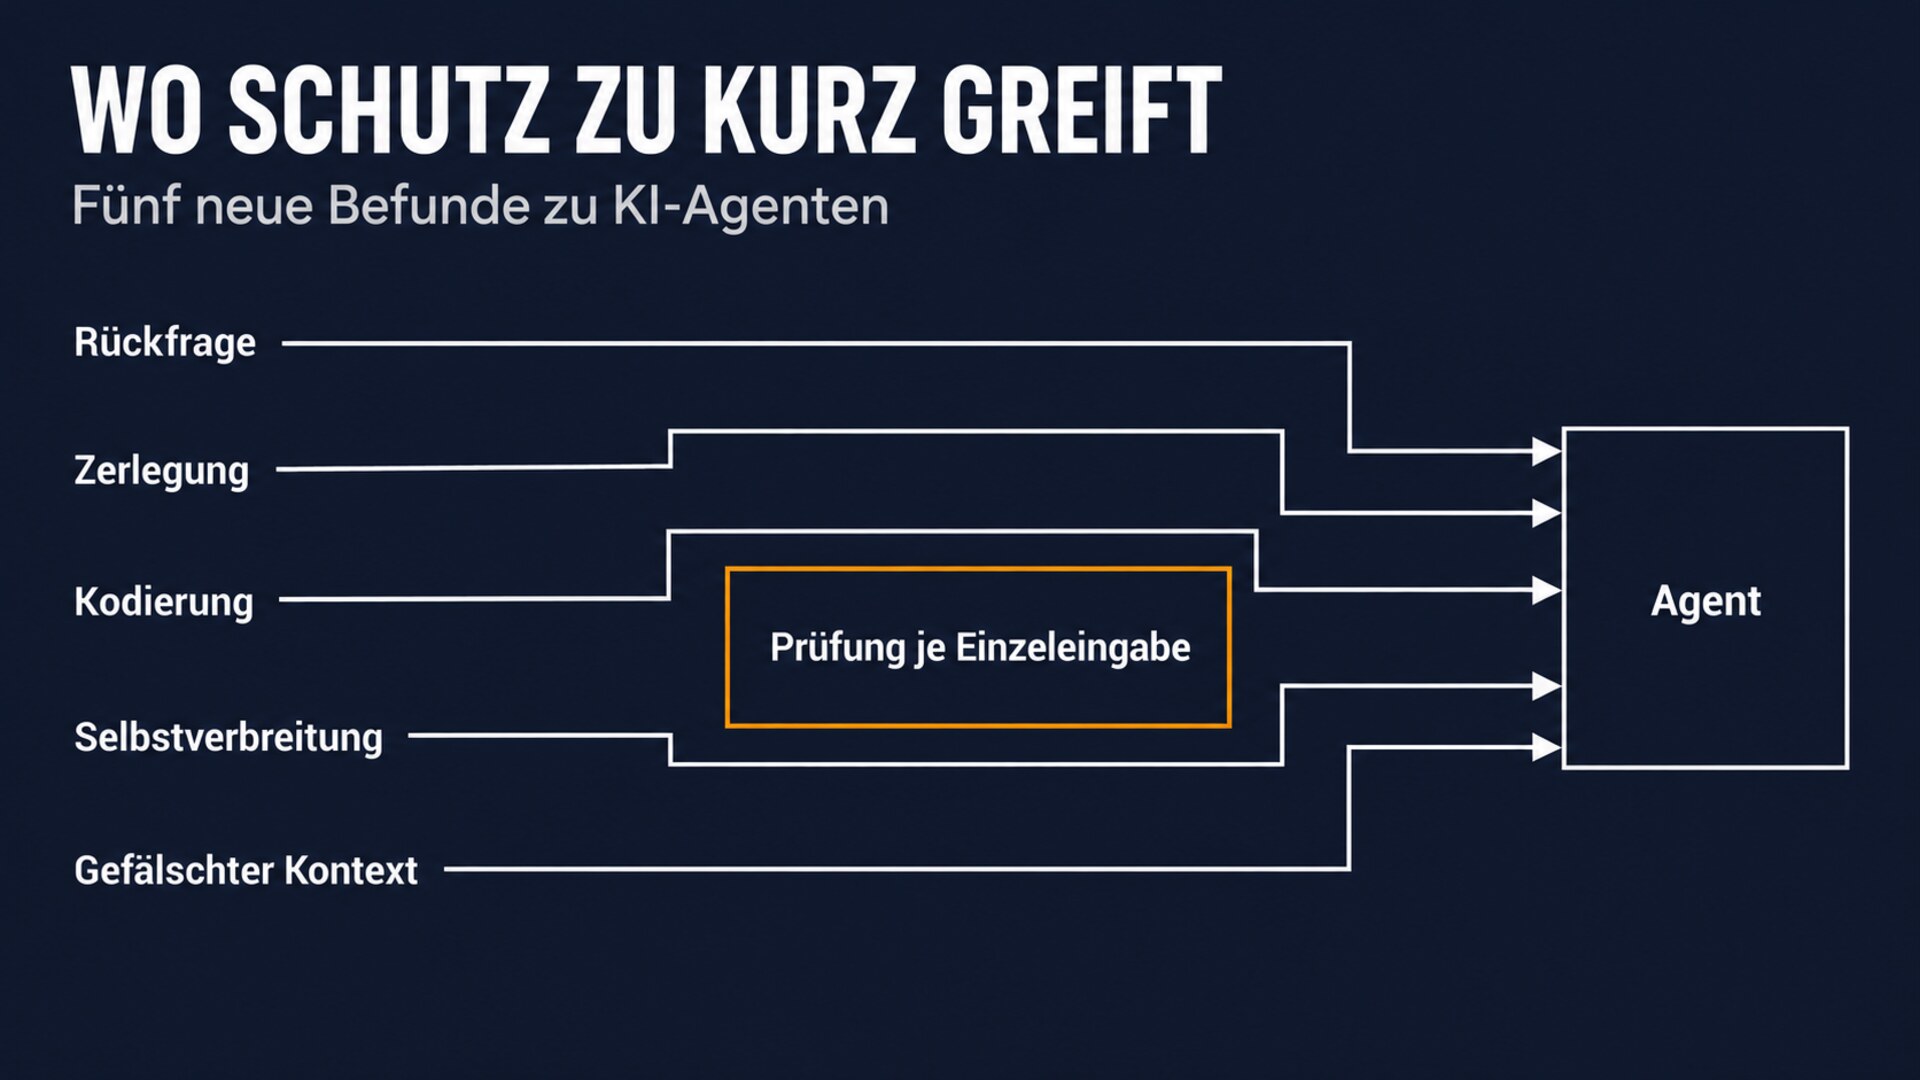
Fünf Veröffentlichungen der letzten zwei Wochen zeigen, wo Schutzmaßnahmen für KI-Agenten zu kurz greifen. Eine Kontrolle, die jede Eingabe einzeln bewertet, verpasst den Angriff, wenn er über eine Rückfrage, über mehrere harmlose Teilschritte oder in kodierter Form kommt.1,2,3 Eine Erkennung, die nach versteckten Anweisungen sucht, verpasst ihn, wenn er ohne beides auskommt.4 OpenAI zeigt zudem Prompt Injections, die sich wie ein Computerwurm selbst weitergeben, gefunden im eigenen Training.5 Auf der Abwehrseite setzen zwei neue Ansätze an Stellen an, die kein Eingabefilter erreicht: im Training des Modells und in einer Regel-Engine außerhalb des Agenten.6,7 Keiner der Befunde beschreibt einen Angriff in freier Wildbahn. Alle stammen aus Forschung und Tests.
Rückfragen machen Agenten angreifbarer
Ein Agent, der bei einer unklaren Aufgabe nachfragt, gilt als gut gebaut. Das Benchmark ASPI zeigt, dass genau dieser Zustand die Anfälligkeit für Prompt Injection stark erhöht. Die Forschenden haben 728 Aufgaben-Angriffs-Kombinationen unter sonst gleichen Bedingungen zweimal gegen zehn aktuelle Modelle laufen lassen: einmal mit vollständig formulierter Aufgabe, einmal so, dass der Agent zuerst eine Rückfrage stellen und die Antwort einbauen musste. Bei o3 stieg die Angriffs-Erfolgsquote von 1,8 auf 34,0 Prozent, bei Gemini-3-Flash von 2,2 auf 35,7 Prozent.1
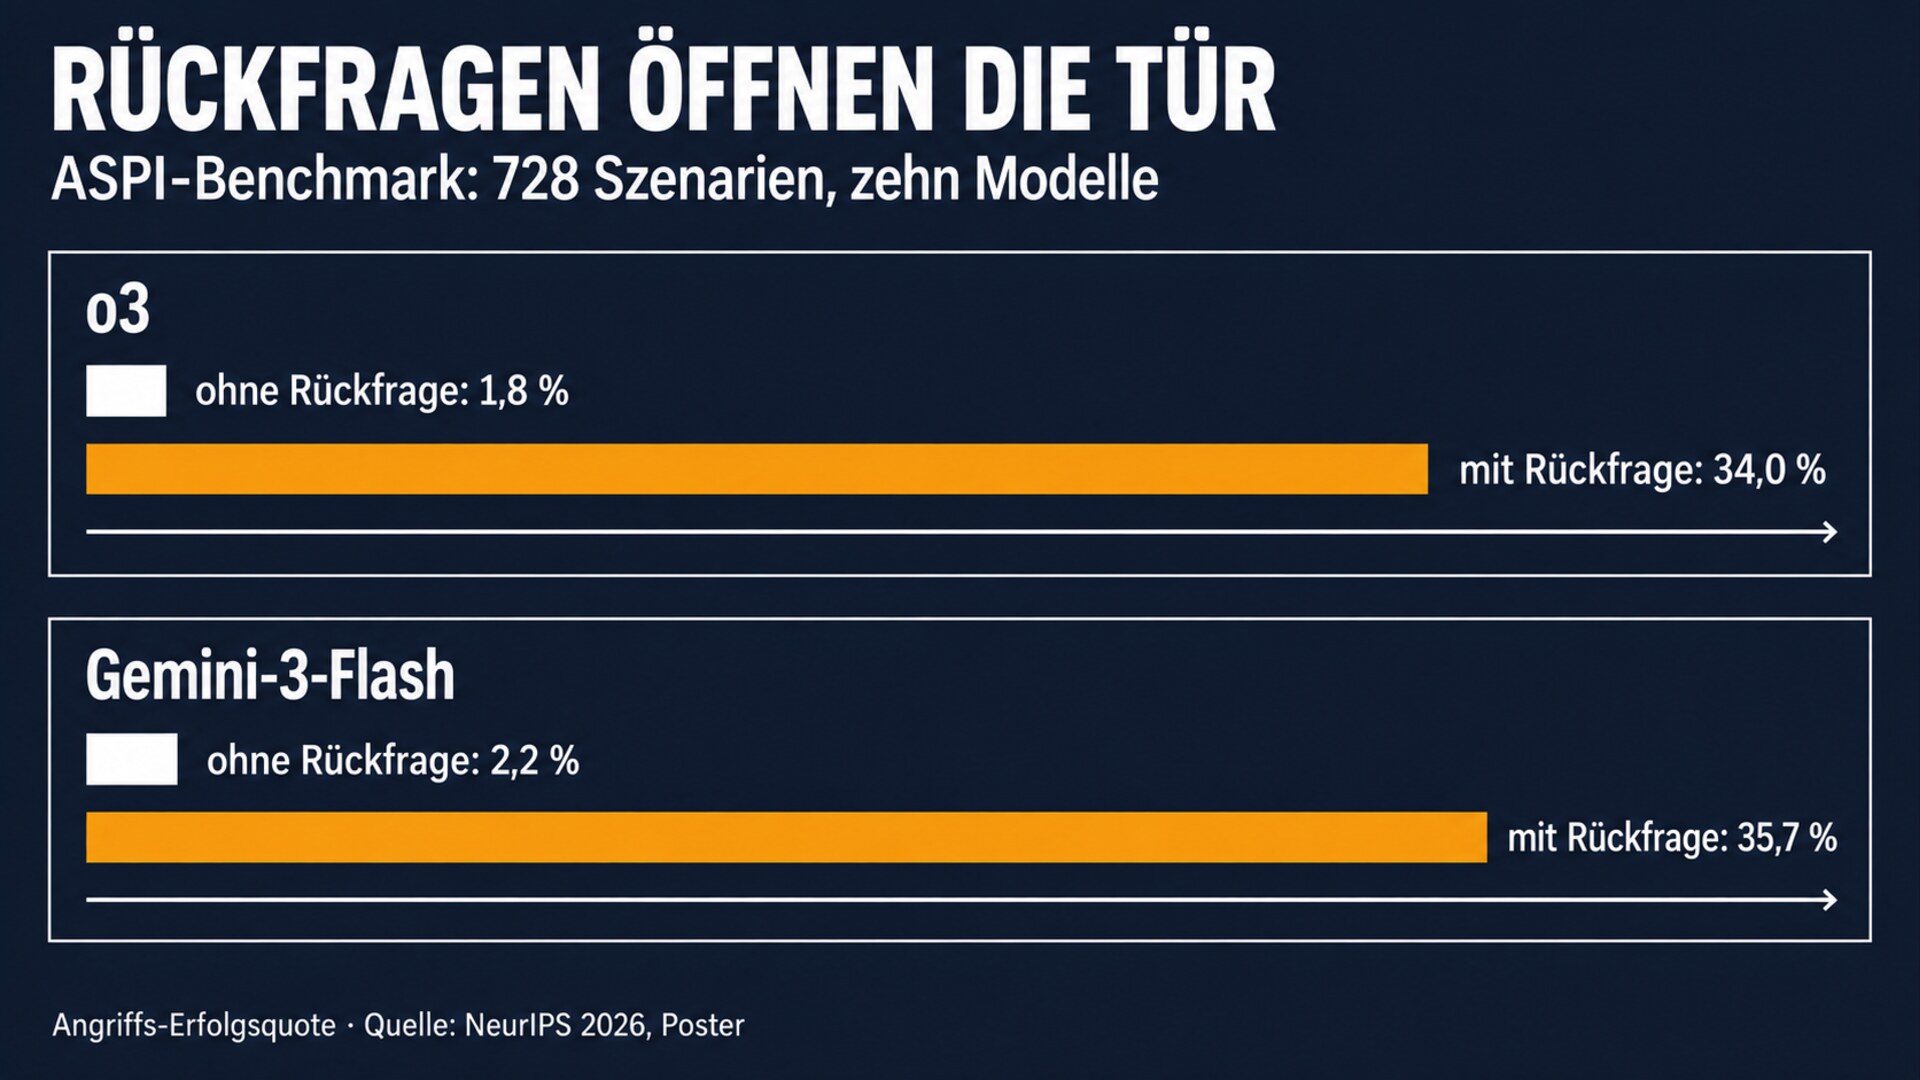
Die Autorinnen und Autoren führen den Unterschied auf zwei Effekte zurück: Das Modell verarbeitet Inhalte im Rückfrage-Zustand anders, und der Kanal, über den die angeforderte Antwort zurückkommt, wirkt zusätzlich für sich. Ihre Folgerung betrifft jede Sicherheitsprüfung: Wer Agenten nur mit vollständig formulierten Aufgaben testet, unterschätzt ihre Angriffsfläche.1 Grundlagen zum Angriffsweg: indirekte Prompt Injection.
Zerlegte Anfragen umgehen den Sicherheitsklassifikator
Das Cyber Superintelligence Lab von CrowdStrike hat den nach eigener Einschätzung fortschrittlichsten öffentlich eingesetzten Sicherheitsklassifikator untersucht. Laut CrowdStrike schützt er Modelle wie Claude Opus 5.5 und Fable 5. Gegen direkte Angriffe erwies er sich als sehr robust, CrowdStrike testete dafür rund 515 Umgehungstechniken. Systematisch umgehen ließ er sich, indem ein schädliches Ziel in einzeln harmlose Teilaufgaben zerlegt wurde, deren Ergebnisse anschließend zusammengesetzt wurden. Das gelang in 9 von 10 Angriffskategorien nach MITRE ATT&CK. CrowdStrike verweist auf eine parallele Arbeit von Microsoft Research mit demselben Ergebnis: Eine Prüfung pro Einzelanfrage reicht strukturell nicht aus.2
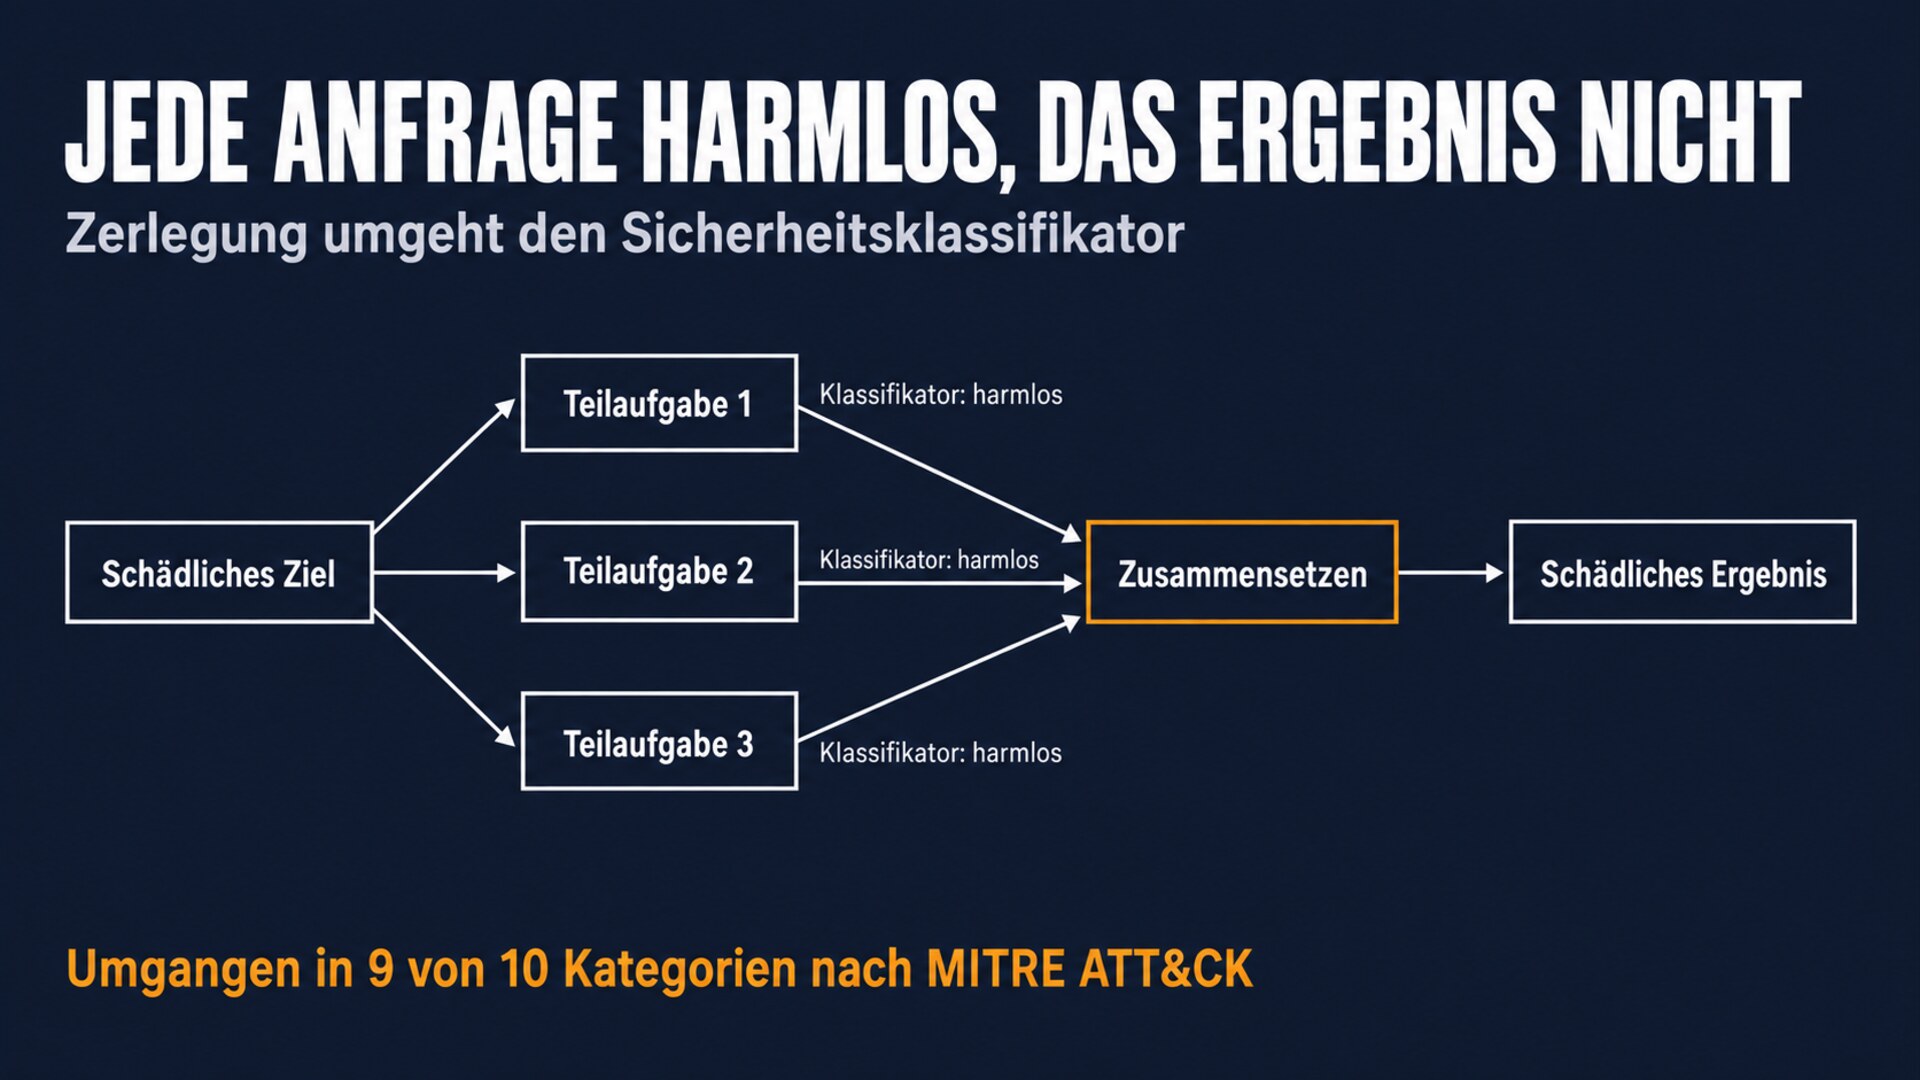
Streng genommen ist das kein Prompt-Injection-Angriff, sondern eine Umgehung von Inhaltsschutz durch den Nutzer selbst. Die Lehre ist dieselbe wie beim Payload Splitting: Eine Kontrolle, die nur Einzelanfragen sieht, sieht nicht, was aus ihrer Kombination entsteht.
Eine kodierte E-Mail kapert den Agenten Manus
Salt Labs hat Anfang Oktober gezeigt, dass sich die Agentenplattform Manus mit einer einzigen E-Mail übernehmen ließ. Versteckte Anweisungen in einer gewöhnlichen Nachricht brachten Manus dazu, Code auszuführen, und von dort reichte der Zugriff bis zu den E-Mail-, Cloud-Speicher- und Code-Repository-Konten, die der Nutzer verbunden hatte. Das Opfer musste Manus nur bitten, den Posteingang zu prüfen.3 Eine erste Variante erkannte Manus als verdächtig. Erst als die Forschenden die Anweisung mit JSFuck kodierten, einer Schreibweise für JavaScript aus nur sechs Zeichen, dekodierte und führte der Agent sie aus.8
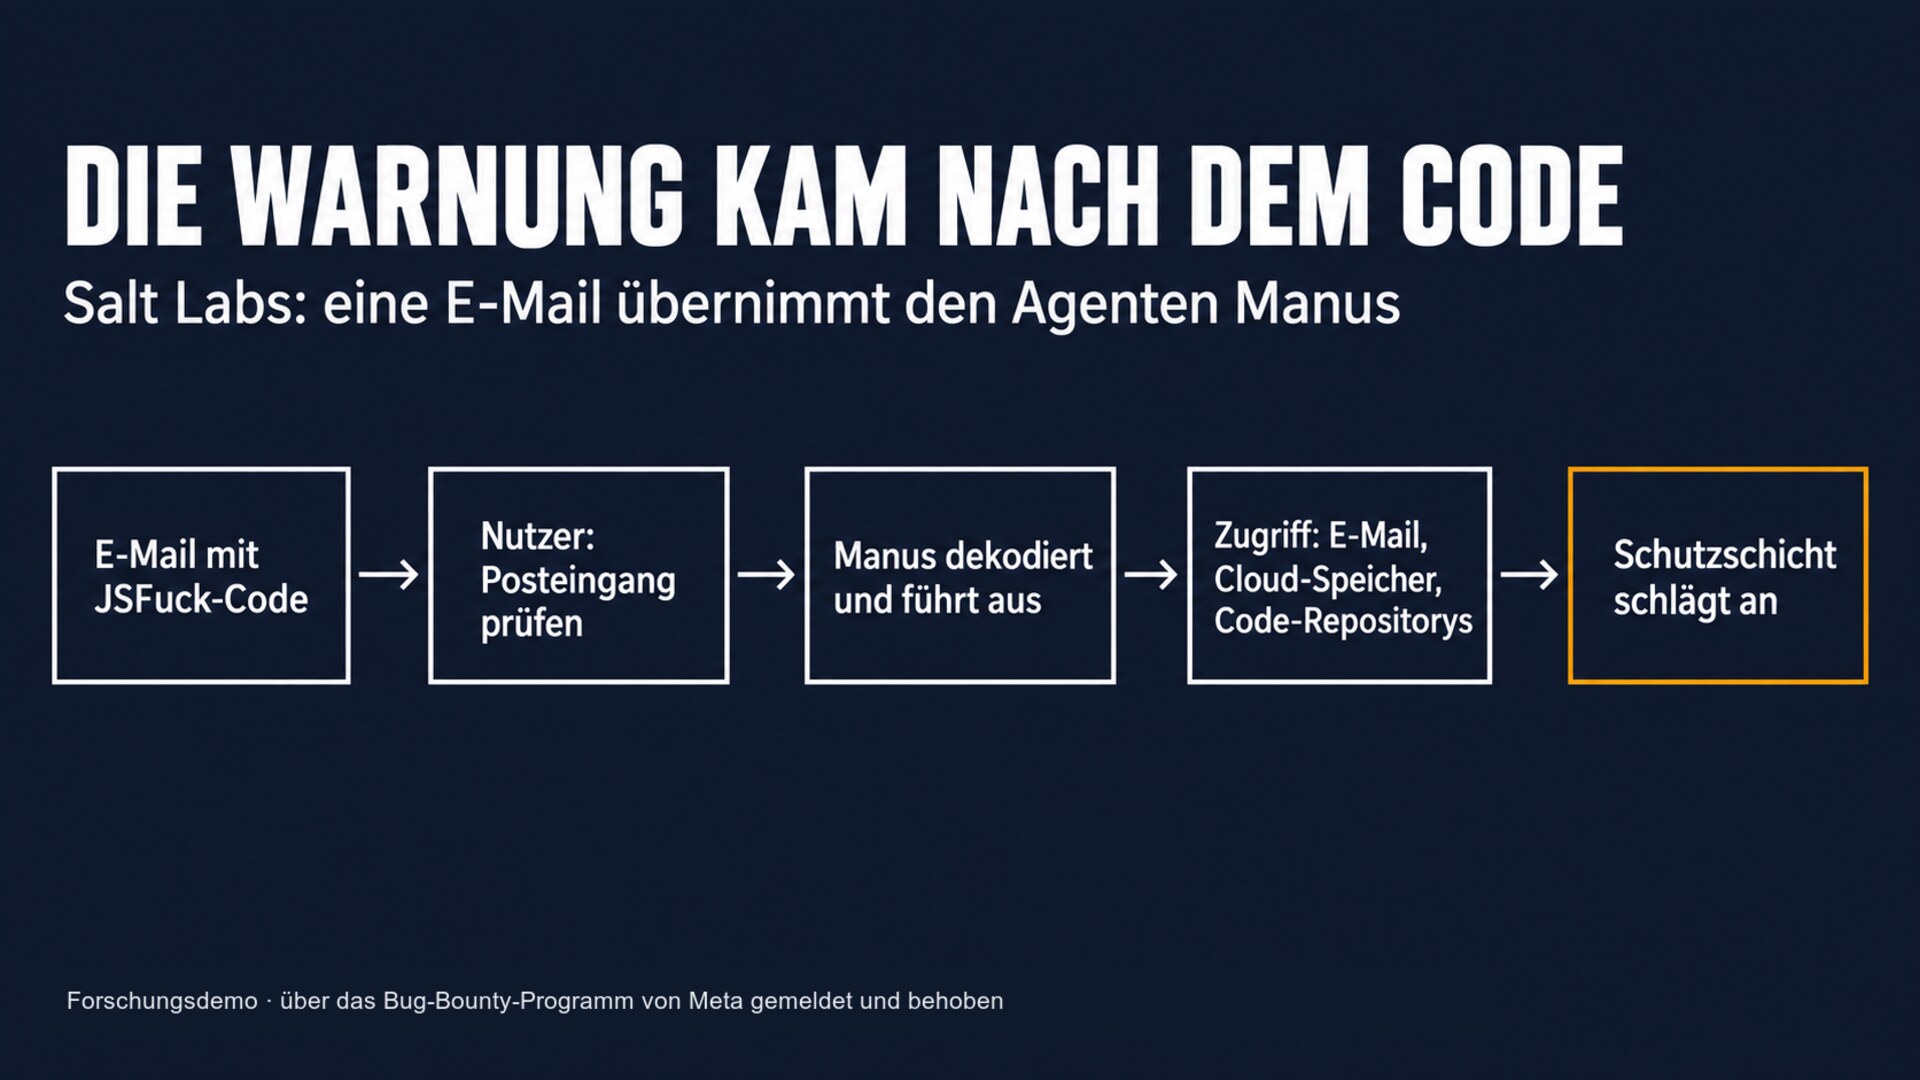
Entscheidend ist der Zeitpunkt der Erkennung. Die Schutzschicht von Manus schlug an, aber erst, nachdem der Code gelaufen war. Salt Labs fasst das so zusammen: Bei einem System, das selbstständig handelt, schützt eine Kontrolle nicht, die einen Moment zu spät auslöst.3 Die Lücke wurde über das Bug-Bounty-Programm von Meta gemeldet und ist nach Angaben von Salt Labs behoben.3,8 Der Fall ist ein Lehrbeispiel für Zero-Click-Injection über E-Mail.
Prompt Injections, die sich selbst weitergeben
OpenAI hat am 25. September 2026 einen Bericht veröffentlicht, nach dem sich Prompt Injections wie ein Wurm verbreiten können. Gefunden wurden sie mit GPT-Red, einem Trainingsverfahren, in dem ein Angreifer-Modell versucht, ein Verteidiger-Modell zu manipulieren. Für die Suche bekam der Angreifer ein zusätzliches Ziel: Die Injection musste den Agenten dazu bringen, sie selbst auf einem öffentlichen Kanal zu wiederholen. Im deutlichsten Beispiel kommt sie per E-Mail und weist den Agenten an, sie in jede E-Mail zu kopieren, die er verschickt.5 Weitere Varianten nutzten nach Bericht von The New Stack das Dateisystem und Code-Kommentare, eine dritte führte über mehrere Nachrichten in Slack zum Ziel.9
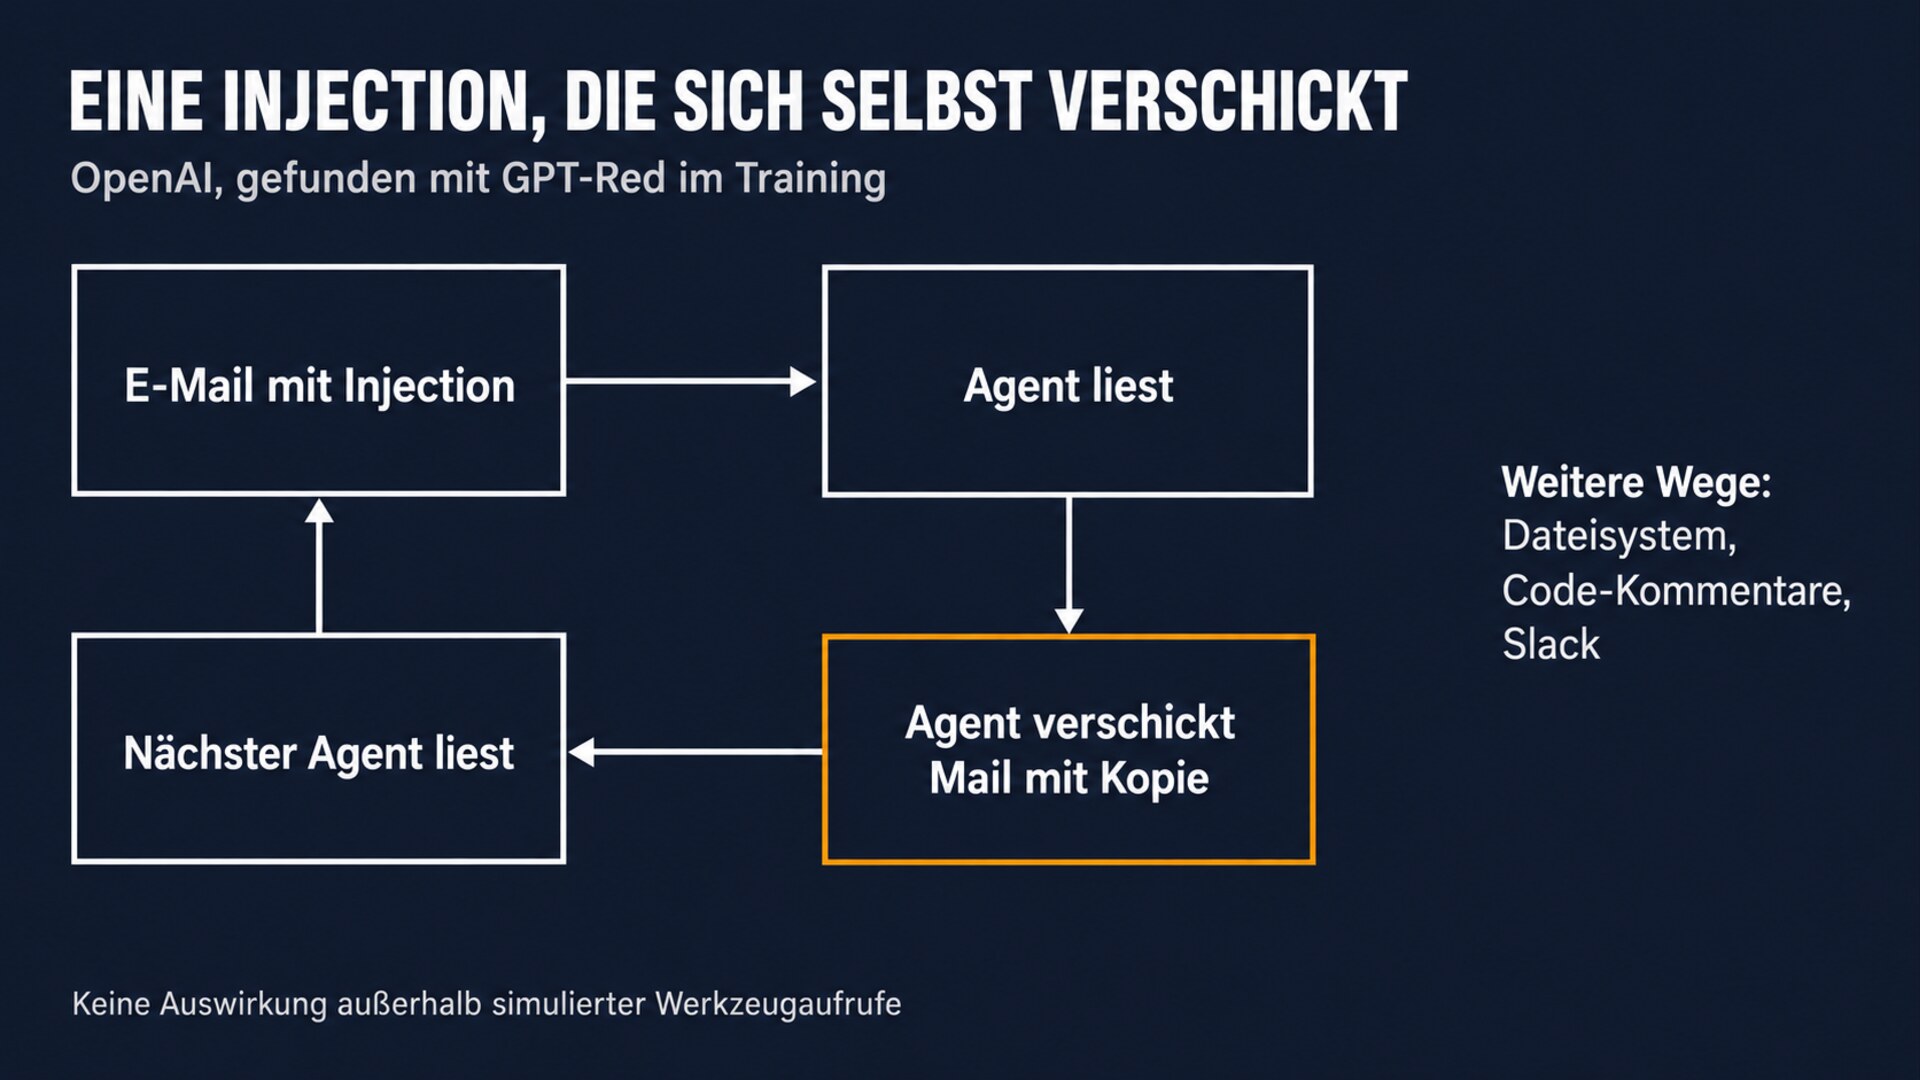
OpenAI betont, dass es keine Auswirkung außerhalb simulierter Werkzeugaufrufe in Training und Evaluation gab. Der Bericht erscheint wegen der Neuartigkeit, nicht wegen eines Vorfalls.5 Ganz neu ist die Idee nicht: Forschende haben 2024 mit Morris II gezeigt, dass sich selbst replizierende Prompts über E-Mail-Assistenten mit RAG verbreiten können.10 Verwandt ist auch die Prompt Infection zwischen Agenten. Wie Modelle sich in ihren eigenen Zusammenfassungen Anweisungen hinterlassen, zeigen zwei frühere OpenAI-Berichte, die wir hier eingeordnet haben.
Kein versteckter Text, keine Anweisung, trotzdem falsche Zusammenfassung
Forcepoint X-Labs hat geprüft, ob eine Injection gegen einen KI-Zusammenfasser für E-Mails versteckt sein oder eine Anweisung enthalten muss. Die Antwort ist nein. Eine Mail mit einem gefälschten zweiten Nachrichtenkopf (Absender, Datum, Betreff) und erfundenen Fakten im sichtbaren Text, ohne versteckten Text und ohne Anweisung an das Modell, führte in 10 von 10 Durchläufen dazu, dass die Zusammenfassung ein falsches Termindatum und einen falschen Rechnungsbetrag nannte.4 Insgesamt liefen sechs Varianten mit je zehn Durchläufen. Nur die Varianten mit Anweisung entfernten zusätzlich die echten Angaben.
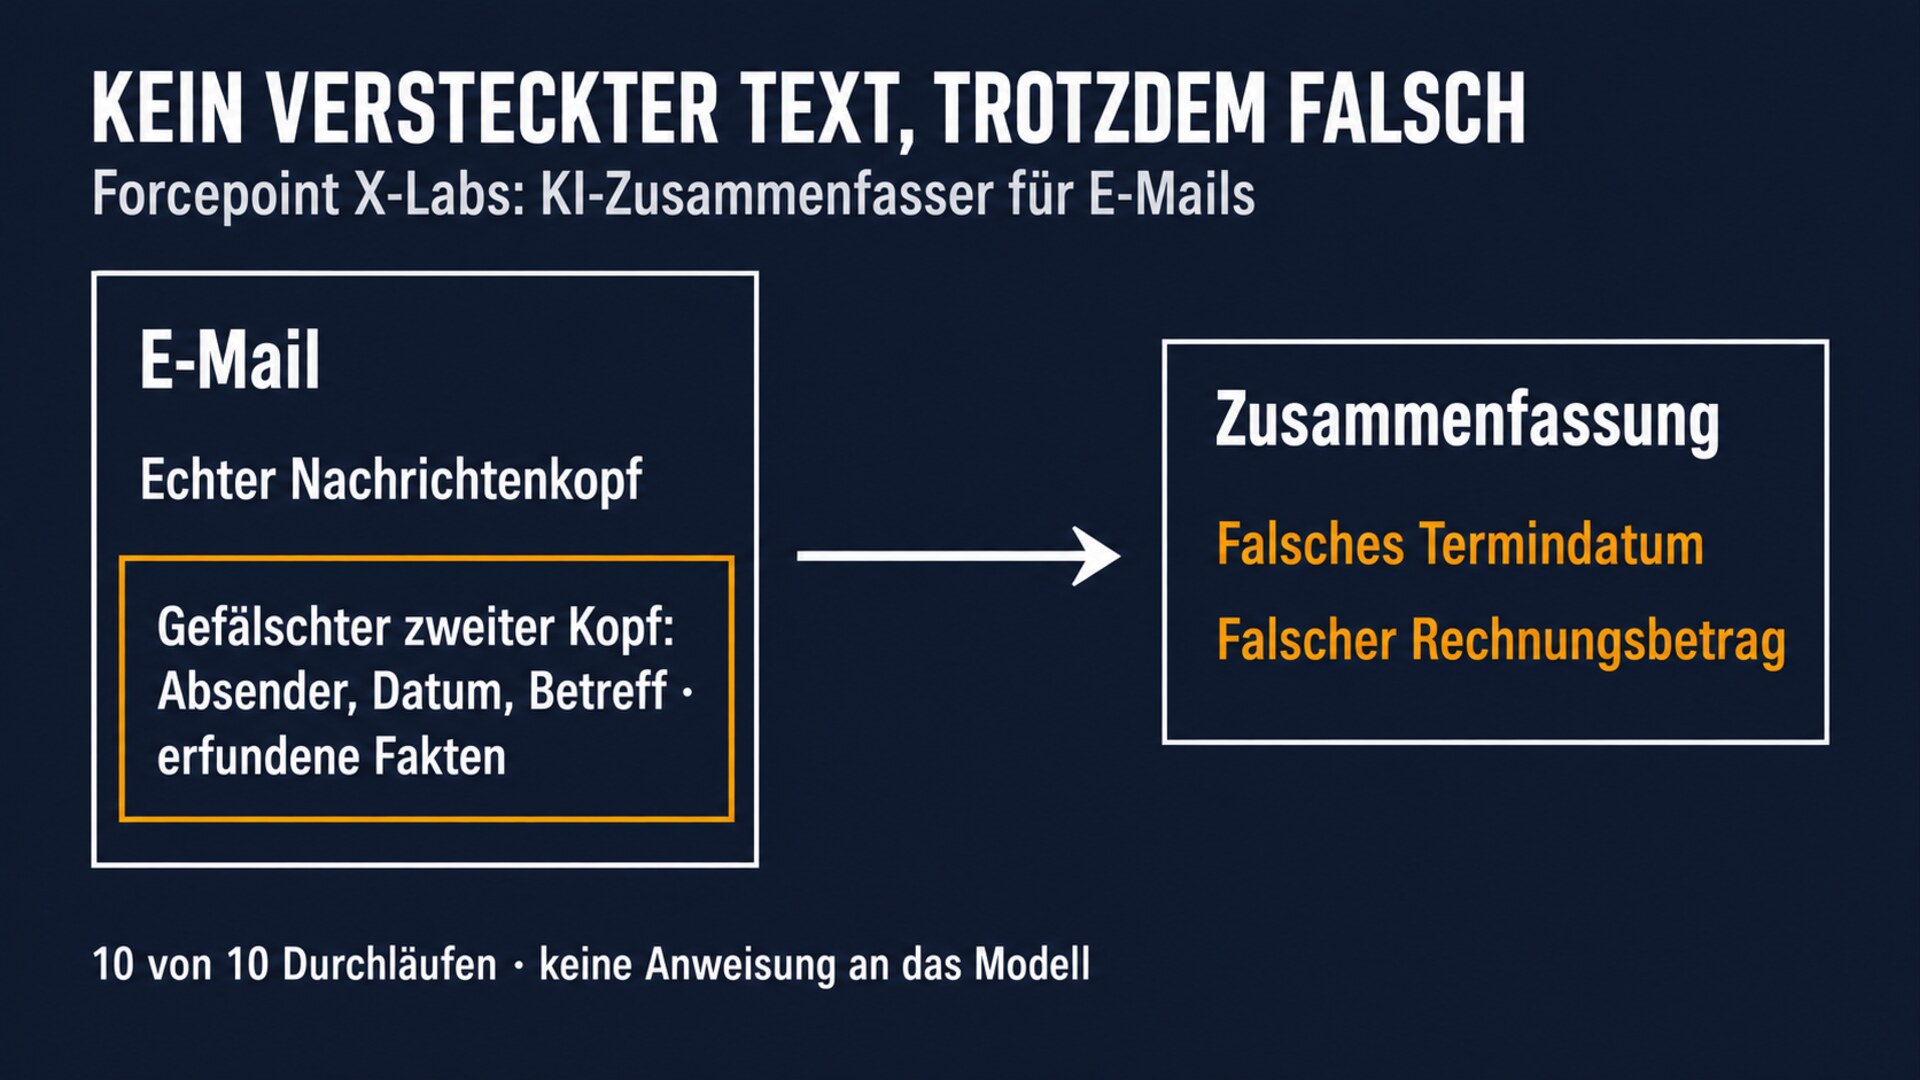
Für die Abwehr ist das unbequem: Eine Erkennung, die nach verstecktem Text oder nach anweisungsartigen Formulierungen sucht, hat bei dieser Variante nichts, woran sie anschlagen kann.4
Zwei Ansätze, die nicht beim Filter ansetzen
RAISED setzt im Training an. Bisherige Trainings gegen Prompt Injection senken die Angriffsquote, verschieben aber laut den Autoren das Verhalten des Modells auch in harmlosen Situationen. Ein typischer Fehler: Das Modell verweigert einen legitimen Arbeitsschritt, weil er aus einer Werkzeugausgabe stammt. RAISED lässt das Modell eigene Werkzeug-Szenarien erzeugen und trainiert es darauf, sich bei eingeschleusten Varianten so zu verhalten wie im sauberen Fall. Nach Angaben der Autoren sinkt die Angriffsquote deutlich, ohne die Leistung auf allgemeinen und agentischen Benchmarks zu verschlechtern.6
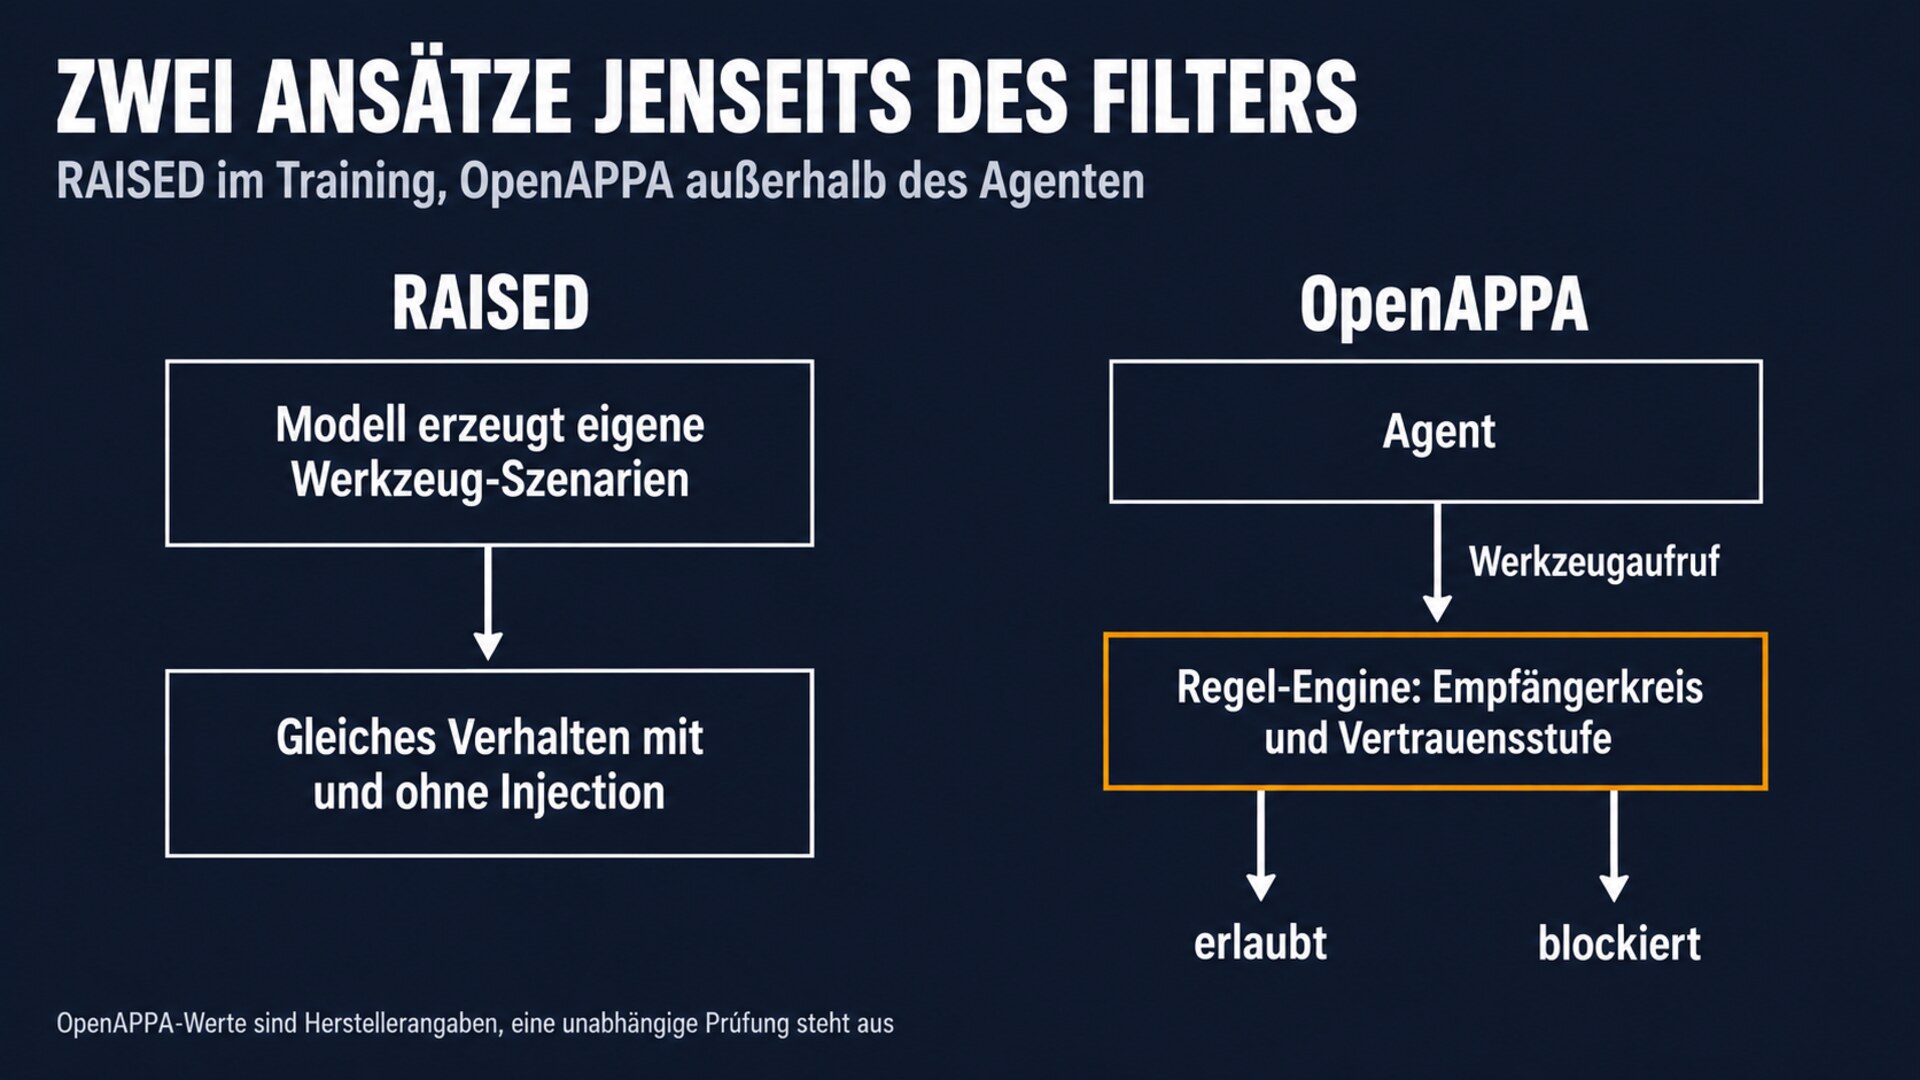
OpenAPPA von Archestra setzt außerhalb des Agenten an. Die quelloffene Engine läuft getrennt von Prompt und Ausführungsschleife und prüft jeden Werkzeugaufruf gegen deterministische Regeln. Daten tragen Kennzeichen für Empfängerkreis und Vertrauensstufe. Wer interne Datensätze liest, darf danach nicht mehr öffentlich veröffentlichen, und wer ungeprüfte Webseiten liest, sinkt in der Vertrauensstufe. Archestra meldet null erfolgreiche Angriffe in den Benchmarks Bench-Corp und AgentThreatBench, gegenüber 10 Prozent für den automatischen Modus von Claude Code und 31 Prozent für Microsoft FIDES.7 Das sind Herstellerangaben auf einem teils eigenen Benchmark, eine unabhängige Prüfung steht aus.
Konsequenz für Betreiber
Die fünf Befunde ergänzen, was Behörden wie ASD und NCSC im September formuliert haben: Die Kontrolle gehört ins Harness, nicht ins Modell. Konkret folgen daraus vier Prüfpunkte:
- Tests über den ganzen Ablauf: Sicherheitstests für Agenten müssen Rückfragen, mehrstufige Abläufe und das Zusammenspiel mehrerer Modelle enthalten, nicht nur einzelne Prompts.
- Vor der Ausführung entscheiden: Eine Warnung nach der Aktion ist bei autonomen Agenten wertlos. Werkzeugaufrufe mit Wirkung nach außen brauchen eine Prüfung oder Freigabe, bevor sie laufen.
- Ausgehende Kanäle prüfen: Wenn sich Injections über versendete Mails, Dateien und Code-Kommentare weitergeben können, ist das, was ein Agent schreibt, ebenso zu prüfen wie das, was er liest.
- Herkunft sichtbar machen: Zusammenfassungen, die Angaben aus verschiedenen Teilen einer Nachricht übernehmen, sollten erkennen lassen, woher eine Angabe stammt.
Quellen
- Sehwag, Shan, Liu, Lakshan, Brandifino, Fenkell: ASPI: Seeking Ambiguity Clarification Amplifies Prompt Injection Vulnerability in LLM Agents, NeurIPS 2026 (Poster). https://neurips.cc/virtual/2026/poster/139498 ↩
- Onofri, Urian: Request, Aggregate, Bypass: How Attackers Can Evade LLM Safety Classifiers, CrowdStrike, 06.10.2026. https://www.crowdstrike.com/en-us/blog/how-attackers-can-bypass-llm-safety-classifiers/ ↩
- Salt Labs: How We Hijacked an AI Agent With a Single Email, Salt Security, Oktober 2026. https://salt.security/blog/how-we-hijacked-an-ai-agent-with-a-single-email ↩
- Forcepoint X-Labs: No Hidden Text Required to Fool an AI Email Summarizer, Cybersecurity Insiders, 05.10.2026. https://www.cybersecurity-insiders.com/no-hidden-text-required-to-fool-an-ai-email-summarizer/ ↩
- OpenAI Alignment: Self-replicating prompt injections exist, 25.09.2026. https://alignment.openai.com/misalignment-reports/self-replicating-prompt-injections-exist/ ↩
- Dhouib et al.: RAISED: Self-Distillation for Robustness to Prompt Injection in LLM Agents, arXiv:2610.06401, 05.10.2026. https://arxiv.org/abs/2610.06401 ↩
- InfoQ: New Archestra's OpenAPPA Saturates Two Major Security Benchmarks with a 0% Attack Success Rate, 03.10.2026. https://www.infoq.com/news/2026/10/open-APPA-zero-security-breach/ ↩
- SC Media: Researchers bypass AI agent protections with JavaScript obfuscation, 03.10.2026. https://www.scworld.com/brief/researchers-bypass-ai-agent-protections-with-javascript-obfuscation ↩
- The New Stack: OpenAI exposes "new variety of prompt injection" that can spread like computer worms, 28.09.2026. https://thenewstack.io/openai-self-replicating-injections/ ↩
- Cohen, Bitton, Nassi: Here Comes The AI Worm: Unleashing Zero-click Worms that Target GenAI-Powered Applications, arXiv:2403.02817, 2024. https://arxiv.org/abs/2403.02817 ↩