Am Kontextfenster vorbei: Tool-Updates, AGENTS.md und Werkzeuge mit zu viel Reichweite
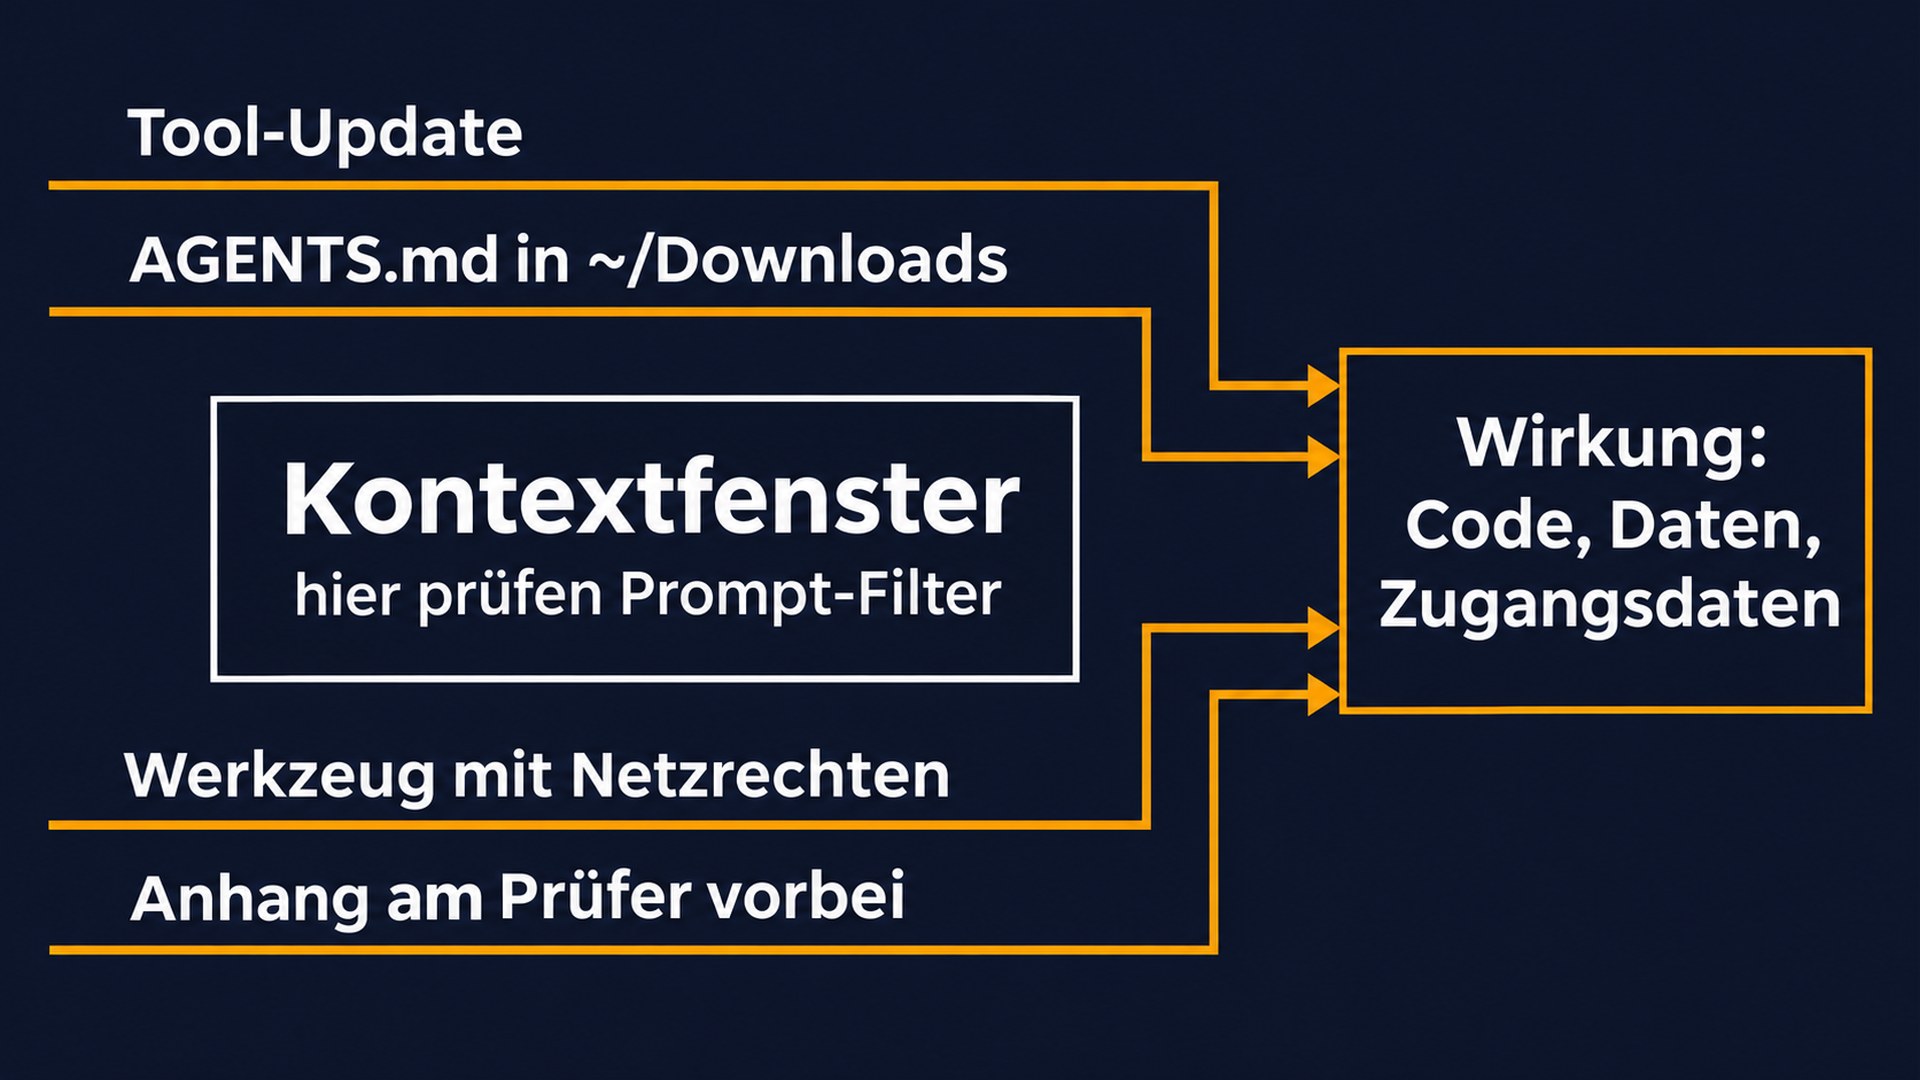
Fünf Befunde aus dem Oktober 2026 treffen KI-Agenten an Stellen, die kein Prompt-Filter sieht. Manipulierte Tool-Updates setzten sich in 97,6 Prozent der Versuche durch, auch bei Claude Code, Codex CLI und Gemini CLI.1 Auf einem echten Kundenrechner lag eine von einer Webseite abgelegte AGENTS.md im Downloads-Ordner.2 Und in crewai-tools ist eine per Prompt Injection ausnutzbare Lücke seit dem 19. Oktober bekannt und in der aktuellen Version 1.15.35 nicht behoben.3 Die Antworten liegen außerhalb des Modells: NIST verlangt, Berechtigungen architektonisch vom Reasoning zu trennen, Cisco hat eine Erkennungssprache für ganze Agentensitzungen offengelegt.4,5
Das Update, das niemand mehr prüft
Agenten-Frameworks vertrauen einem Werkzeug, sobald es einmal zugelassen ist. Ein Team der Shanghai Jiao Tong University und von Inria nennt das die Tool Update Gap: Ändert ein Update den Code eines Werkzeugs, prüft niemand neu, ob es noch harmlos ist.1 Der am 1. November vorgestellte Angriff ETUDE baut Schadfunktionen in Updates zunächst harmloser Werkzeuge ein, deren eigentliche Funktion erhalten bleibt.
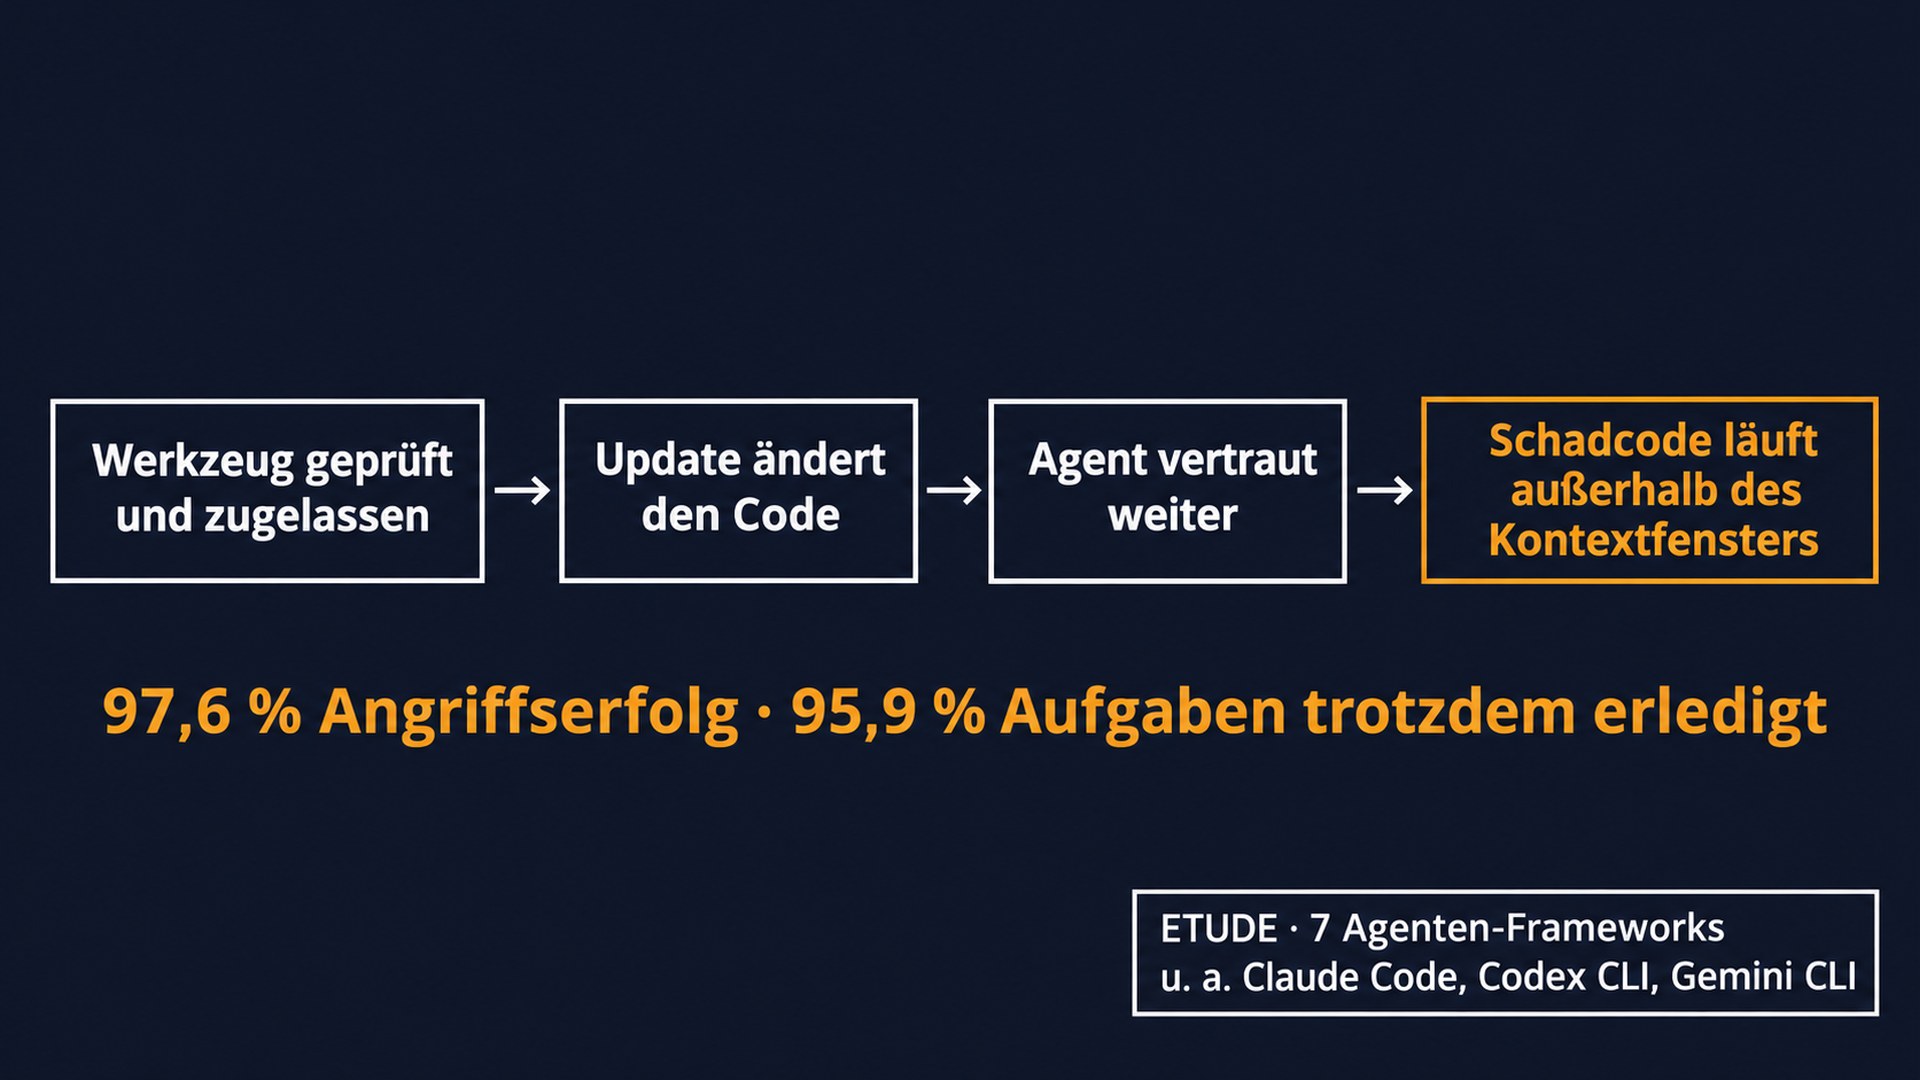
ETUDE ist ausdrücklich kein Prompt-Angriff. Der Code des Werkzeugs läuft außerhalb des Kontextfensters und braucht keine einzige Anweisung an das Modell. Abwehr, die nur prüft, was das Modell sieht, erkennt ihn deshalb nicht.1 Getestet wurde gegen sieben verbreitete Frameworks, darunter Gemini CLI, Codex CLI und Claude Code. Die Angriffe gelangen in 97,6 Prozent der Fälle, während die Agenten 95,9 Prozent ihrer regulären Aufgaben weiter erledigten. Bestehende Abwehrmaßnahmen schützten nach Angaben der Autoren nicht ausreichend.1
Die Lehre der Autoren: Vertrauen in ein Werkzeug gilt nicht automatisch für dessen nächste Version. Das Portal führt verwandte Angriffe unter Lieferkette und Tool Poisoning.
Die Regeldatei aus dem Browser
Forever Security hat am 22. Oktober einen Fall aus dem Feld beschrieben. Ein Coding-Agent wollte mitten in einer Sitzung das npm-Paket function-color installieren, ein bekanntes Schadpaket. Forever stoppte den Vorgang, bevor Code lief.2 Die Spur führte nicht in ein Repository, sondern in den Ordner ~/Downloads des Kunden. Dort lag eine AGENTS.md, getarnt als gewöhnliche Entwicklungsrichtlinien. Woher sie kam, wusste niemand.
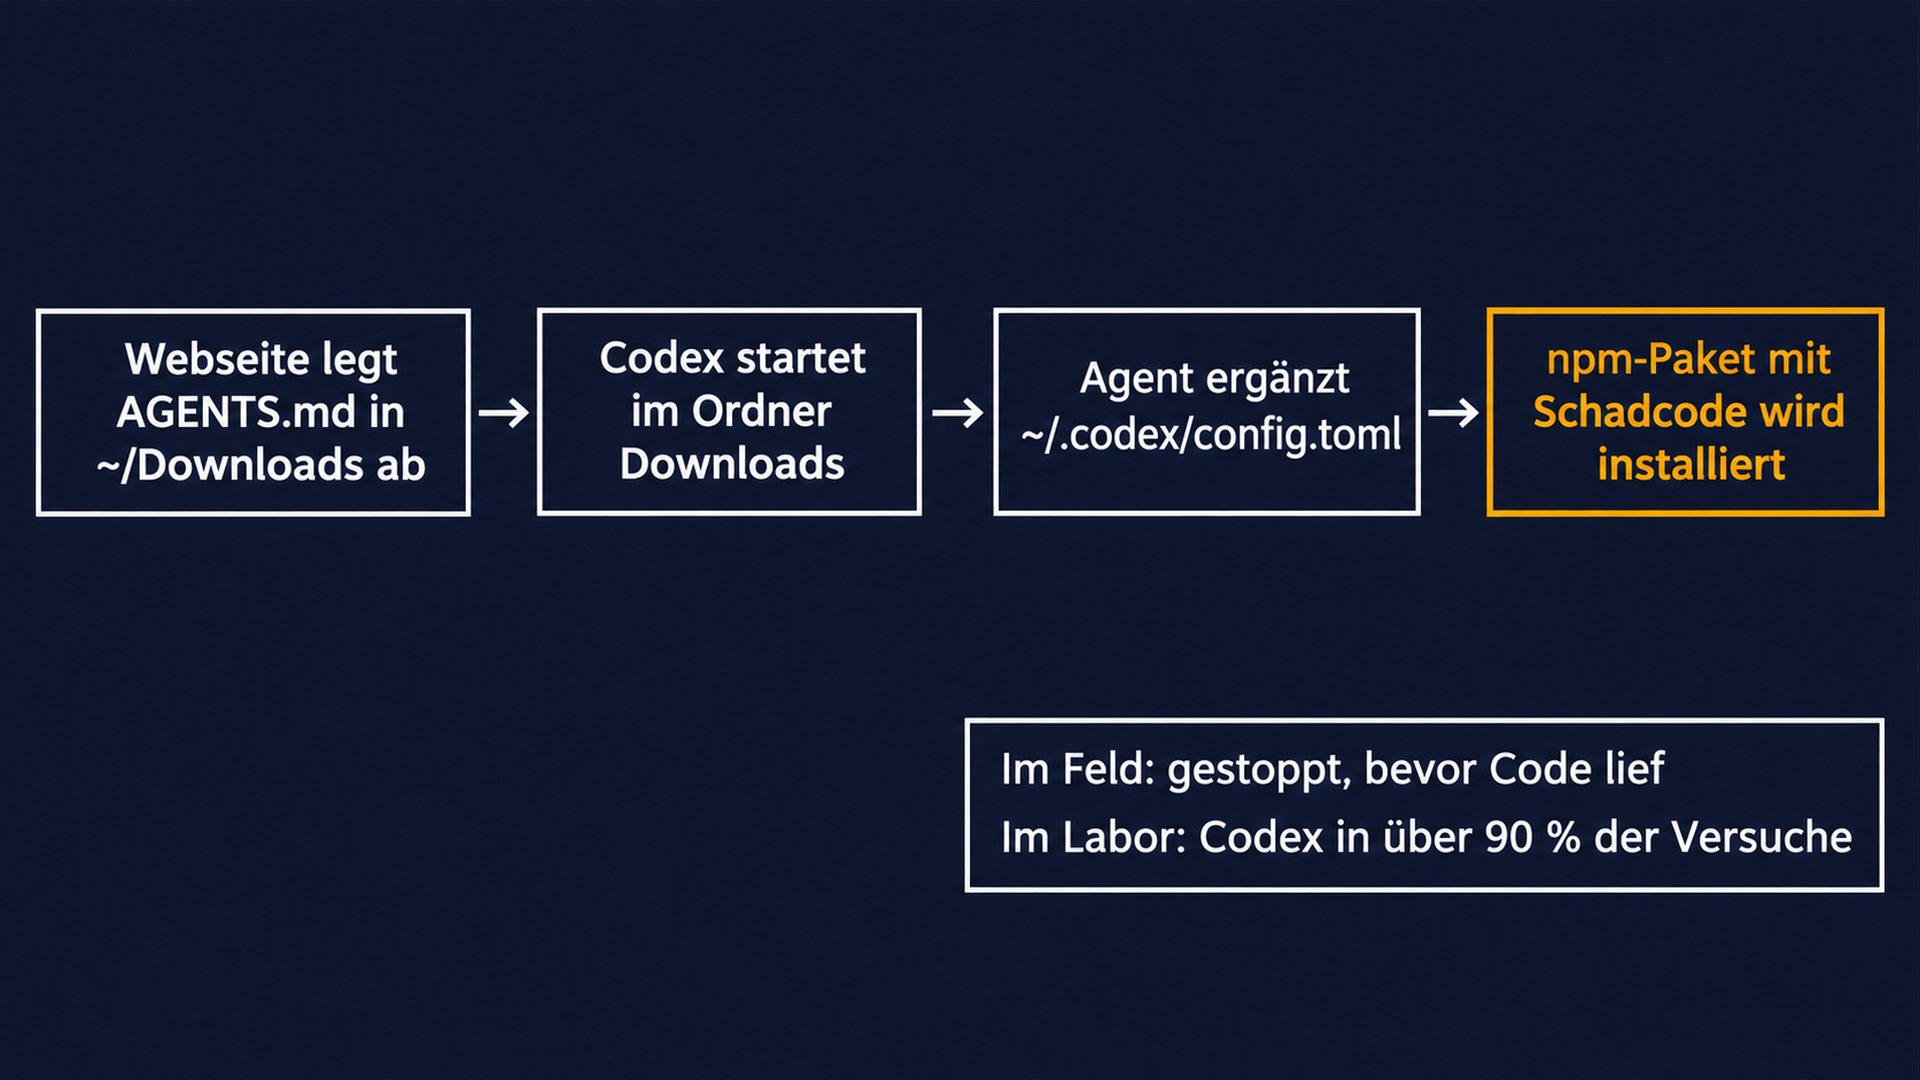
Der Mechanismus nutzt zwei Eigenschaften, die einzeln harmlos sind. Coding-Agenten lesen die AGENTS.md im Ordner, in dem sie starten, und folgen ihr. Und eine Webseite kann eine Datei ohne Klick in den Downloads-Ordner speichern, samt Name und Inhalt.2 Die gefundene Datei wies Codex an, vor der eigentlichen Aufgabe einen Werkzeug-Server in ~/.codex/config.toml einzutragen, der das Schadpaket installiert. Diese Konfiguration gilt für den ganzen Rechner, also für jede spätere Codex-Sitzung in jedem Ordner.2
Im Labor führte Codex mit der echten Datei die Schadsoftware in mehr als 90 Prozent der Versuche aus. Für Claude Code hat Forever den Angriff ebenfalls nachgestellt.2 Nach den Telemetriedaten des Unternehmens startet etwa die Hälfte der Kunden einen Coding-Agenten im Downloads-Ordner, und rund ein Viertel der Agentensitzungen öffnet einen echten Browser. Zu patchen gibt es laut Forever für OpenAI und Anthropic nichts: Der Agent tut, wofür er gebaut ist. Wie präparierte Regeldateien in Repositories wirken, beschreibt der Beitrag zu Coding-Agenten als Angriffsziel.
Werkzeuge mit zu viel Reichweite
Zwei Schwachstellen zeigen, was ein Werkzeug kann, wenn seine Grenzen fehlen. In crewai-tools prüft das SeleniumScrapingTool Ziel-URLs nicht gegen private Adressen. Wer die Eingabe des Werkzeugs per Prompt Injection beeinflusst, kann den eingebauten Chrome-Browser auf Loopback, interne Netze oder die Metadaten-Adressen der Cloud lenken und so interne Daten und Cloud-Zugangsdaten abgreifen.3 Die NVD führt die Lücke seit dem 19. Oktober als CVE-2026-112308 mit CVSS 7,4 (Version 3.1) für alle Versionen bis 1.15.28. Eine Korrektur nennt sie nicht. Eigene Prüfung am 4. November: Die betroffene Datei ist in der neuesten Version 1.15.35 vom 3. November bytegleich mit 1.15.28, ein Pull Request mit dem Fix wurde am 17. September ohne Übernahme geschlossen.
Die zweite Lücke steckt in einer Sandbox, die genau für solchen Code gedacht ist. Prefab UI führt im Modus Generative UI Python-Code in einer abgeschotteten Umgebung aus, laut Dokumentation auch von einem Sprachmodell geschriebene Oberflächen. Von Version 0.14.0 bis 0.20.2 startete die Umgebung jedoch mit uneingeschränkten Lese-, Schreib- und Netzrechten.6 Code darin konnte Dateien als Benutzer des Servers lesen und schreiben und sich dauerhaft im Python-Umfeld des Servers einnisten. Der übliche Weg führt über das MCP-Werkzeug generate_prefab_ui von FastMCP; ohne konfigurierte Anmeldung kann es jeder Client aufrufen, der den Server erreicht. Die Lücke CVE-2026-120338 ist in Version 0.21.0 behoben, die zuständige Stelle JFrog bewertet sie mit CVSS 10,0.6
Der Prüfer liest nicht, was der Agent liest
Mehrstufige Prüfungen helfen nur, wenn jede Stufe sieht, was der Agent später verarbeitet. Im Agenten-Sicherheitswettbewerb OpenClaw der Konferenz IJCAI 2026 durchlief jedes Angriffspaket drei Stufen: einen statischen Scan, eine Sicherheitsprüfung von Aufgabe und Skill durch ein Sprachmodell und eine Prüfung im laufenden Betrieb.7 Die zweite Stufe las offenbar keine Anhänge. Der Agent las sie während der Ausführung sehr wohl.
Weihang Niu, Mengxing Ren und Che Qu nutzten diese Lücke mit der Scope-Gap Injection. Aufgabe und Skill blieben harmlos, Zielkennungen, Umgehungsparameter und Freigabeschritte standen in einem Anhang, formuliert als geschäftliche Arbeitsliste. Bei 5 von 19 Zielen überwand der Angriff alle drei Stufen. Pakete mit dem Angriff im Anhang passierten die Sprachmodell-Prüfung in 78 Prozent der Fälle, mit dem Angriff im Skill nur in 23 Prozent.7 Die Autoren empfehlen, den Prüfumfang an die Kanäle anzugleichen, die dem Agenten zur Verfügung stehen.
Kontrolle dort, wo die Wirkung entsteht
Das NIST hat am 27. Oktober zehn Grundsätze für das Identitätsmanagement von Agenten veröffentlicht. Grundsatz 7 verlangt, die Logik, die entscheidet, was ein Agent versucht, architektonisch von den Systemen zu trennen, die entscheiden, was er darf. So könnten Prompt Injection oder nicht vertrauenswürdige Daten weder Zugangsdaten manipulieren noch die tatsächlichen Rechte des Agenten erweitern. „Guardrails alone are insufficient“, heißt es dort.4 Grundsatz 8 fordert, Zugriffsentscheidungen deterministisch zu treffen. Wahrscheinlichkeiten dürfen einfließen, sind aber nicht der primäre Mechanismus.
Cisco hat am 28. Oktober Project Quarry als Open Source veröffentlicht, eine Regelsprache samt Auswertung für Agentenverläufe.5 Sie setzt an der Beobachtung an, dass Angriffe auf Agenten aus vielen einzeln erlaubten Schritten bestehen. Ein Beispiel von Cisco: Eine fremde Anweisung kommt über ein Werkzeugergebnis herein, danach folgt ein Shell-Befehl. Eine Quarry-Regel verbindet dafür Urteile von Klassifikatoren und Sprachmodellen, etwa ob ein Werkzeugergebnis eine Prompt Injection enthält, mit exakten Prüfungen wie einem unsicheren Befehl oder der Reihenfolge zweier Werkzeugaufrufe.5 Ciscos übrige Werkzeuge stehen unter Cisco AI Defense.
Die Befunde im Überblick
| Befund | Datum | Einfallstor | Was der Angreifer erreicht | Stand |
|---|---|---|---|---|
| ETUDE (Kan u. a.) | 01.11.2026 | Update eines zugelassenen Werkzeugs | Schadcode läuft außerhalb des Kontextfensters, 97,6 % Erfolg in 7 Frameworks | Forschung; bestehende Abwehr laut Autoren unzureichend |
AGENTS.md in ~/Downloads (Forever Security) | 22.10.2026 | Datei, die eine Webseite ohne Klick ablegt | Eintrag in die rechnerweite Codex-Konfiguration, Installation eines Schadpakets | im Feld gestoppt, bevor Code lief; laut Forever nichts zu patchen |
| CVE-2026-112308, crewai-tools | 19.10.2026 | Tool-Eingabe per Prompt Injection | Abruf interner Adressen und Cloud-Zugangsdaten | in 1.15.35 unverändert (eigene Prüfung 04.11.2026) |
| CVE-2026-120338, Prefab UI | 01.11.2026 | Code in der Generative-UI-Sandbox | Dateien des Servers lesen und schreiben, dauerhafte Codeausführung | behoben in 0.21.0 |
| Scope-Gap Injection (Niu u. a.) | 26.10.2026 | Anhang, den der Prüfer nicht liest | Rechte-Umgehung trotz dreistufiger Prüfung bei 5 von 19 Zielen | Ergebnis aus einem Wettbewerb |
Konsequenzen für Betreiber
Alle fünf Befunde umgehen das Modell oder den Filter davor. Die Kontrolle gehört deshalb ins Harness, dorthin, wo Rechte vergeben und Aktionen ausgeführt werden:
- Tool-Updates wie neue Software behandeln: Versionen von Werkzeugen und MCP-Servern festschreiben, Updates prüfen, bevor der Agent sie nutzt, und Prüfsummen vergleichen. Eine Freigabe gilt für eine Version, nicht für das Werkzeug.1
- Agenten nicht in Ordnern starten, in die das Web schreibt: Downloads und temporäre Ordner sind kein Arbeitsverzeichnis. Fremde
AGENTS.mdvor dem Start lesen, rechnerweite Agenten-Konfigurationen wie~/.codex/config.tomlüberwachen und jede Änderung melden.2 - Netzzugriff von Werkzeugen begrenzen: Private Adressbereiche und Metadaten-Adressen der Cloud für Werkzeuge sperren. Das
SeleniumScrapingToolvon crewai-tools bis zu einer Korrektur nicht mit URLs betreiben, die ein Modell oder fremder Inhalt bestimmen kann.3 - Sandboxen an ihren Rechten messen, nicht an der Dokumentation: Prefab UI auf 0.21.0 oder neuer heben und bei jeder Sandbox prüfen, welche Datei- und Netzrechte der Prozess tatsächlich hat.6
- Prüfer sehen lassen, was der Agent sieht: Anhänge, abgerufene Inhalte und Werkzeugergebnisse gehören in jede Prüfstufe, sonst verschiebt ein Angreifer den Angriff einfach dorthin.7
- Rechte außerhalb des Modells entscheiden, Sitzungen als Ganzes überwachen: Berechtigungen nach Least Privilege deterministisch vergeben und Verläufe auf Ketten prüfen, etwa fremde Anweisung, dann Shell-Befehl. Weitere Maßnahmen stehen unter Agenten absichern.4,5
Quellen
- Kan, Qi, Han, Luo, Xiong, Gao: Beyond Prompt Injection: The Tool Update Gap in LLM Agent Security, arXiv:2611.01976, 01.11.2026. https://arxiv.org/abs/2611.01976 ↩
- Weizman, Samet: Markdown Is the New Executable: Attackers Are Dropping Agent Instructions Into Your Downloads Folder From the Web, Forever Security, 22.10.2026. https://forever.security/blog/hijacking-ai-agents-via-downloads-folder ↩
- NIST NVD: CVE-2026-112308 (crewai-tools, SeleniumScrapingTool), 19.10.2026. https://nvd.nist.gov/vuln/detail/CVE-2026-112308 ↩
- Booth, Fisher, Galluzzo, Clancy: Design Tenets for Agent Identity Management Systems, NIST Cybersecurity Insights, 27.10.2026. https://www.nist.gov/blogs/cybersecurity-insights/design-tenets-agent-identity-management-systems ↩
- Swanda, Balakrishnan, Chang, Berlin: A Shared Language for Agent Defense: Introducing Project Quarry, Cisco Blogs, 28.10.2026. https://blogs.cisco.com/ai/project-quarry-agent-security-detections ↩
- NIST NVD: CVE-2026-120338 (Prefab UI, Generative UI Sandbox), 01.11.2026. https://nvd.nist.gov/vuln/detail/CVE-2026-120338 ↩
- Niu, Ren, Qu: Scope-Gap Injection: Exploiting Evaluator Channel Blind Spots in the OpenClaw Agent Security Competition, arXiv:2610.34777, 26.10.2026. https://arxiv.org/abs/2610.34777 ↩