Am Prompt-Filter vorbei: Abrufwerkzeug als Kurier, offene LightLLM-Knoten, Abwehr im Modell
Drei Veröffentlichungen aus den letzten zwei Wochen betreffen Stellen, die ein Prompt-Filter nicht sieht. Die Arbeit „The Innocent Courier“ zeigt, wie Schadsoftware ohne eigenen Internetzugang ein Geheimnis über das legitime Web-Abrufwerkzeug eines Chatbots nach außen bringt, ohne dem Modell eine einzige Anweisung unterzuschieben. Die Erfolgsquote lag im Mittel bei 79,7 Prozent.1 Im Inferenzserver LightLLM erlaubt CVE-2026-103395 Codeausführung ohne Anmeldung, für die bis zum 10. Oktober kein Patch existiert.2,3 Auf der Abwehrseite setzt CounterSteer im Modell selbst an und senkt die Angriffsquote indirekter Prompt Injection deutlich, mit einer klar benannten Lücke.4 Keiner der Befunde beschreibt einen beobachteten Angriff in freier Wildbahn.
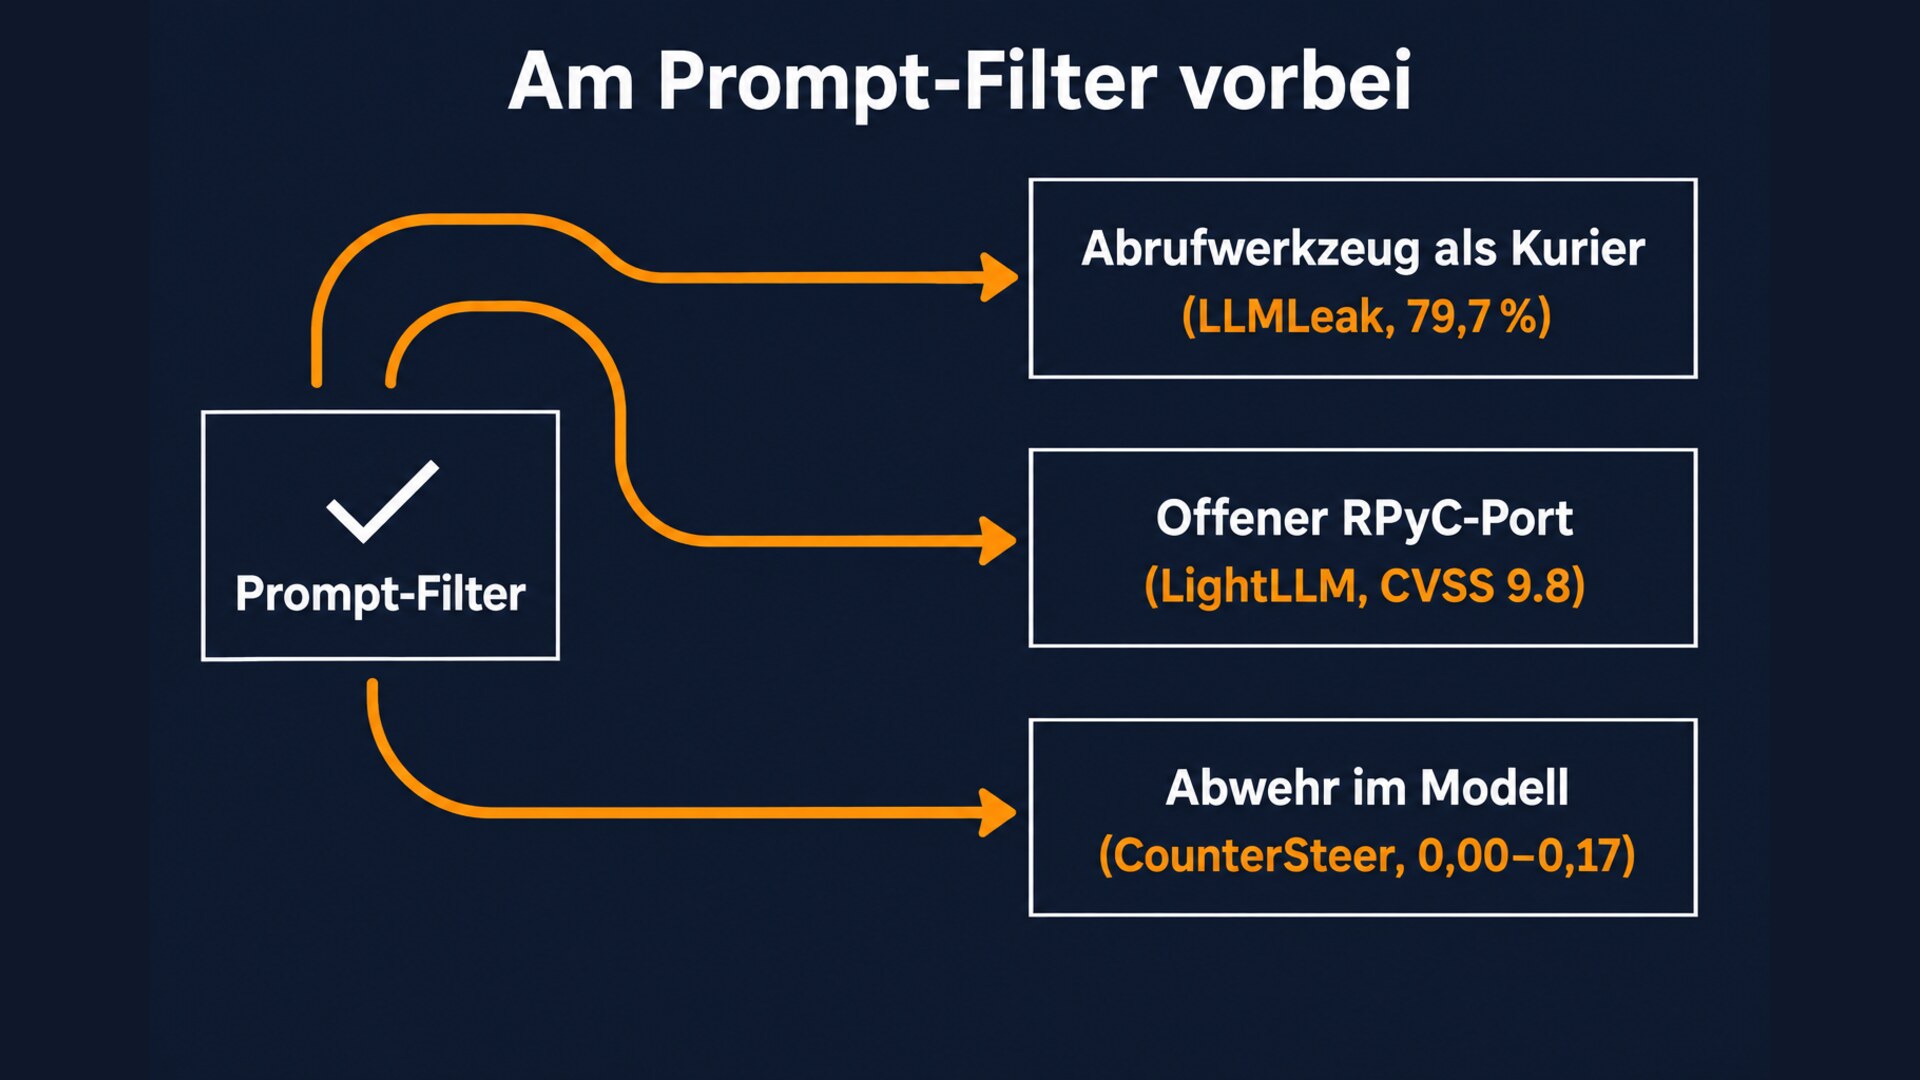
LLMLeak: Das Abrufwerkzeug als Exfiltrationskanal
Forschende der TU Darmstadt beschreiben mit LLMLeak einen verdeckten Kanal, der auf einer Voraussetzung beruht: Auf dem Rechner des Opfers läuft bereits Schadsoftware, etwa eine präparierte Bibliothek, die an ein Geheimnis wie einen API- oder SSH-Schlüssel kommt. Direkt senden kann sie es nicht, weil der Netzverkehr überwacht oder auf freigegebene Programme beschränkt ist.1
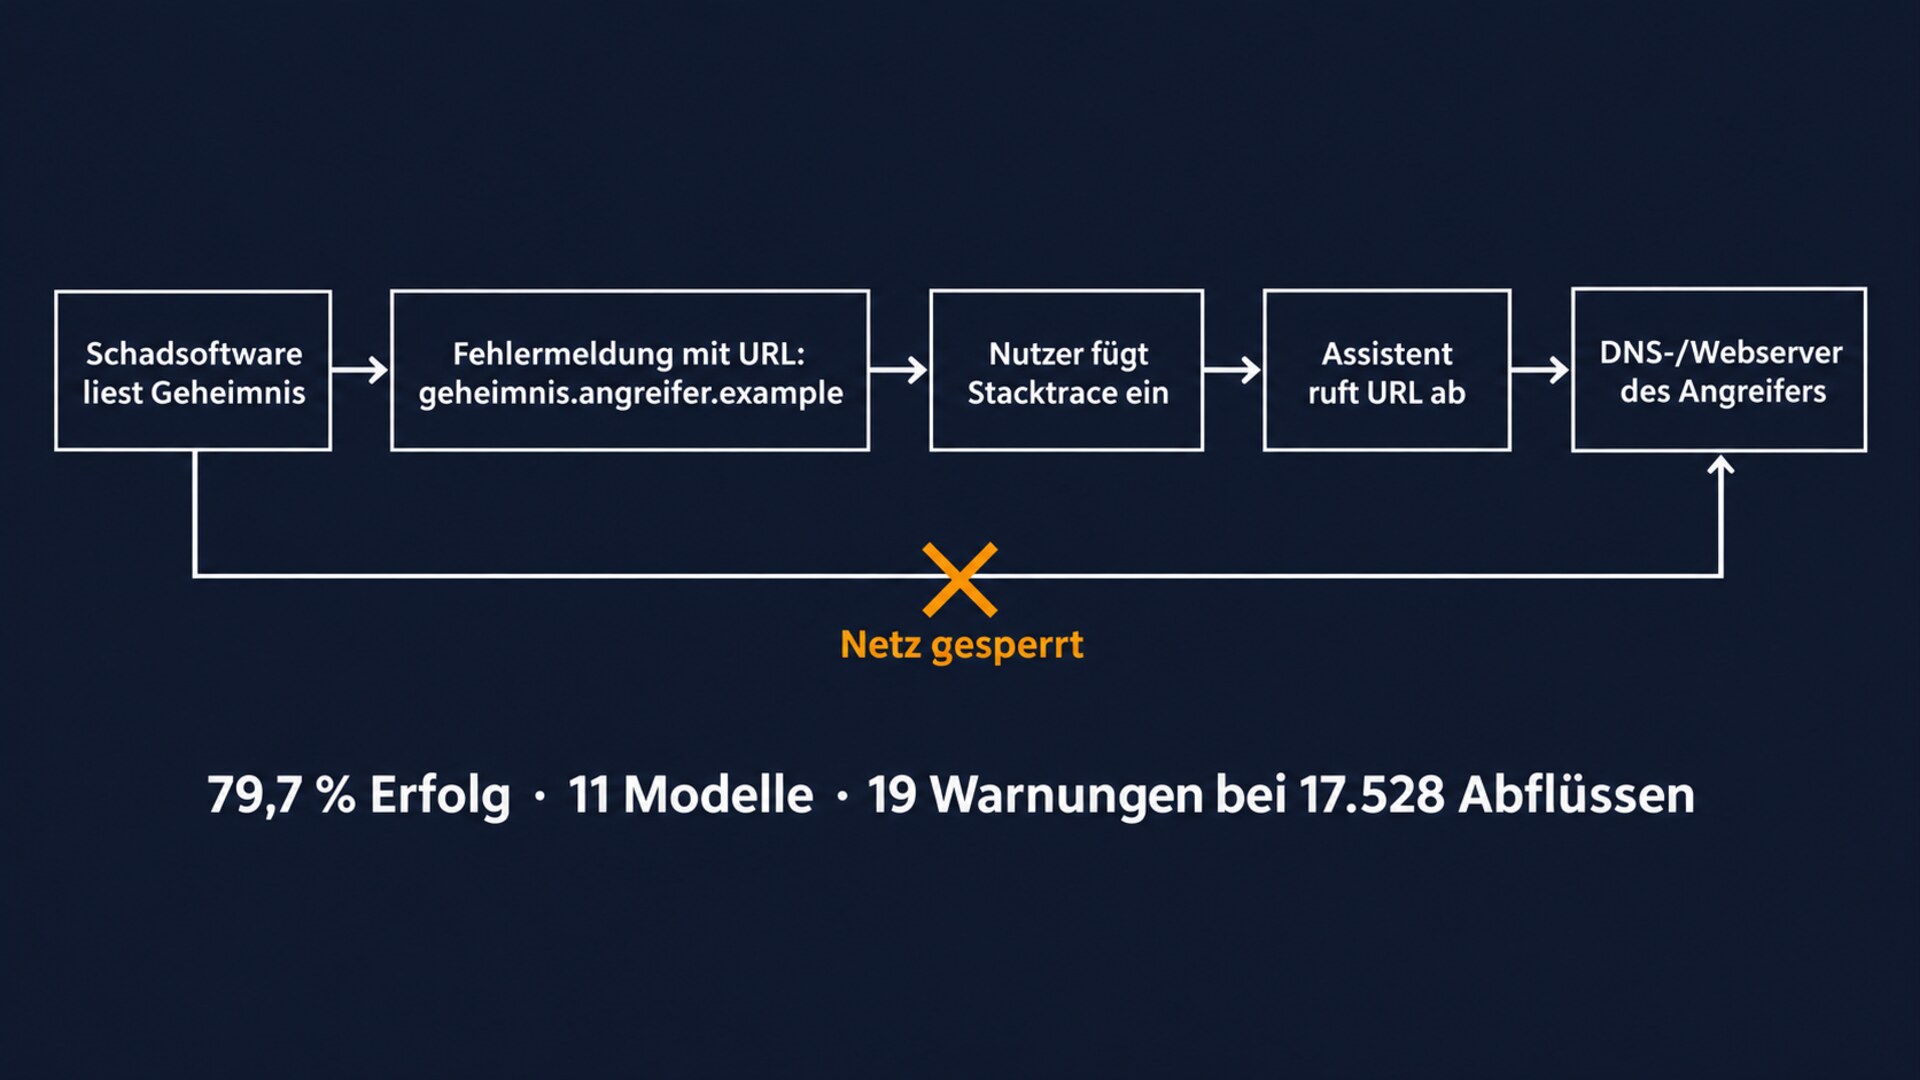
Der Weg nach außen führt über den Assistenten. Die Bibliothek löst einen echten Fehler aus, dessen Meldung eine URL enthält, angeblich mit Hinweisen zur Behebung oder zur Migration auf eine neuere Version. Das Geheimnis steckt in dieser URL, als Subdomain oder im Pfad. Kopiert der Nutzer den Stacktrace in einen Coding-Assistenten, oder liest ein Agent auf dem Rechner die Fehlermeldung selbst, ruft das Modell die Seite mit seinem Abrufwerkzeug auf. Schon die DNS-Auflösung oder die HTTP-Anfrage übermittelt das Geheimnis an den Server des Angreifers. Was der Server zurückliefert und was das Modell antwortet, spielt keine Rolle mehr.1
Die Fehlermeldung enthält keine Anweisung an das Modell. Die Autoren schließen eine solche Anweisung ausdrücklich aus, weil der Nutzer die Ausgabe vor dem Einfügen lesen könnte. Damit hat eine Abwehr gegen indirekte Prompt Injection nichts, woran sie ansetzen kann: Das Modell tut nur, wofür das Werkzeug gebaut ist.1
Getestet wurde an elf Modellen mit offenen Gewichten, mit je 2.000 Versuchen pro Modell über zehn Fehlermeldungen und beide Kanäle. Im Mittel kam das Geheimnis in 79,7 Prozent der Versuche beim Angreifer an. Nur drei der elf Modelle lagen unter 75 Prozent. Am niedrigsten lag Qwen3-Coder-30B mit 30,0 Prozent, weil es den Fehler eher lokal zu beheben versuchte, als die URL aufzurufen. Von 17.528 bestätigten Abflüssen war nur in 19 Fällen eine Warnung an den Nutzer zu sehen. Eine Fallstudie mit realen Chatbots ergänzt die Messung.1 Der Angriff ist eine Variante der Datenexfiltration über Links, nur ohne eingeschleuste Anweisung.
LightLLM: Codeausführung ohne Anmeldung, kein Patch
VulnCheck hat am 30. September 2026 CVE-2026-103395 veröffentlicht. Betroffen ist LightLLM bis Version 1.2.0 in Deployments mit --run_mode visual_only, also auf Knoten, die in multimodalen Setups die Bildvorverarbeitung übernehmen. Dort läuft ein RPyC-Dienst ohne Authentifizierung mit aktiviertem allow_pickle. Die Methode remote_infer_images deserialisiert die Argumente des Aufrufers. Wer den Port erreicht, kann ein Objekt mit präparierter __reduce__-Methode übergeben und Code mit den Rechten des Dienstkontos ausführen.2
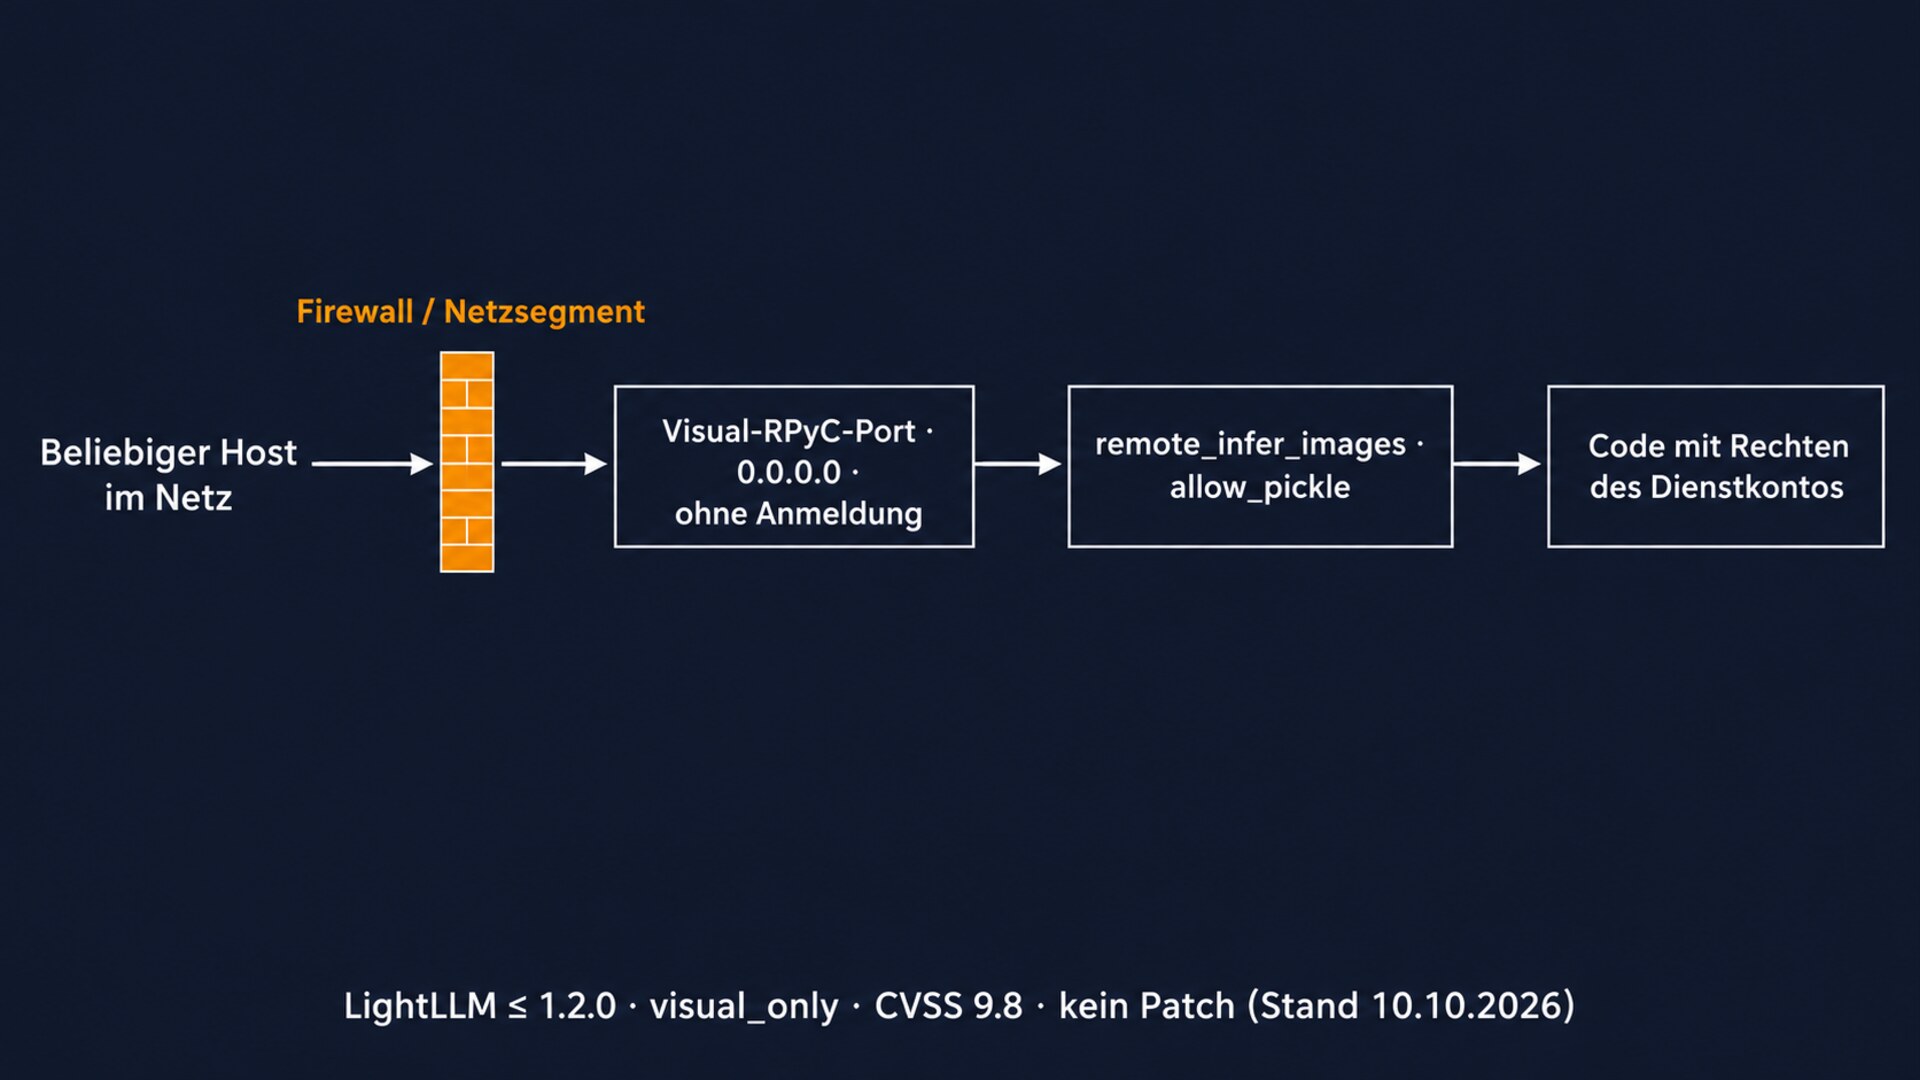
Laut Fehlerbericht bindet der Dienst an alle Schnittstellen (0.0.0.0). Der Melder hat die Codeausführung lokal und von einem zweiten Host aus nachvollzogen. In seiner Testumgebung gehörte das Dienstkonto den Gruppen sudo und docker an, was nach Einordnung von Threat Frontier für dieses Setup gilt und kein allgemeiner Befund ist.3,5 VulnCheck bewertet die Lücke mit CVSS 9.8 (v3.1) und 9.3 (v4.0), die NVD hat den Eintrag zurückgestellt und nicht bewertet.5
Am 10. Oktober ist das Issue weiterhin offen und ohne Kommentar, das letzte Release ist v1.2.0 vom 10. August 2026.3 Threat Frontier zählt für 2026 sechs unauthentifizierte Deserialisierungs-Lücken mit Codeausführung in LightLLM, alle in Version 1.2.0 oder früher.5 Das ist keine Prompt Injection. Es betrifft aber jeden, der Modelle selbst betreibt, und zeigt, dass die Infrastruktur unter dem Modell eine eigene Angriffsfläche ist. Ähnliches galt für die offenen LiteLLM-Gateways, die Wiz im September beschrieben hat. Unser CVE-Verzeichnis führt CVE-2026-103395 und die gleichartige Lücke CVE-2026-103040 im Profiler-Dienst.
CounterSteer: Abwehr im Modell mit messbarer Grenze
Mark Russinovich stellt mit CounterSteer eine Abwehr vor, die zur Inferenzzeit im Modell wirkt. Für jedes Modell wird aus Paaren von Durchläufen, die sich nur darin unterscheiden, ob eine eingebettete Anweisung befolgt wird, eine Richtung im Residualstrom bestimmt. Im Betrieb wird diese Richtung während des Prefills von jedem Token eines Werkzeugergebnisses abgezogen. Es gibt keine Erkennungsentscheidung, die ein Angreifer umgehen könnte, kein Feintuning, kein Hilfsmodell und keine zusätzlichen Token.4
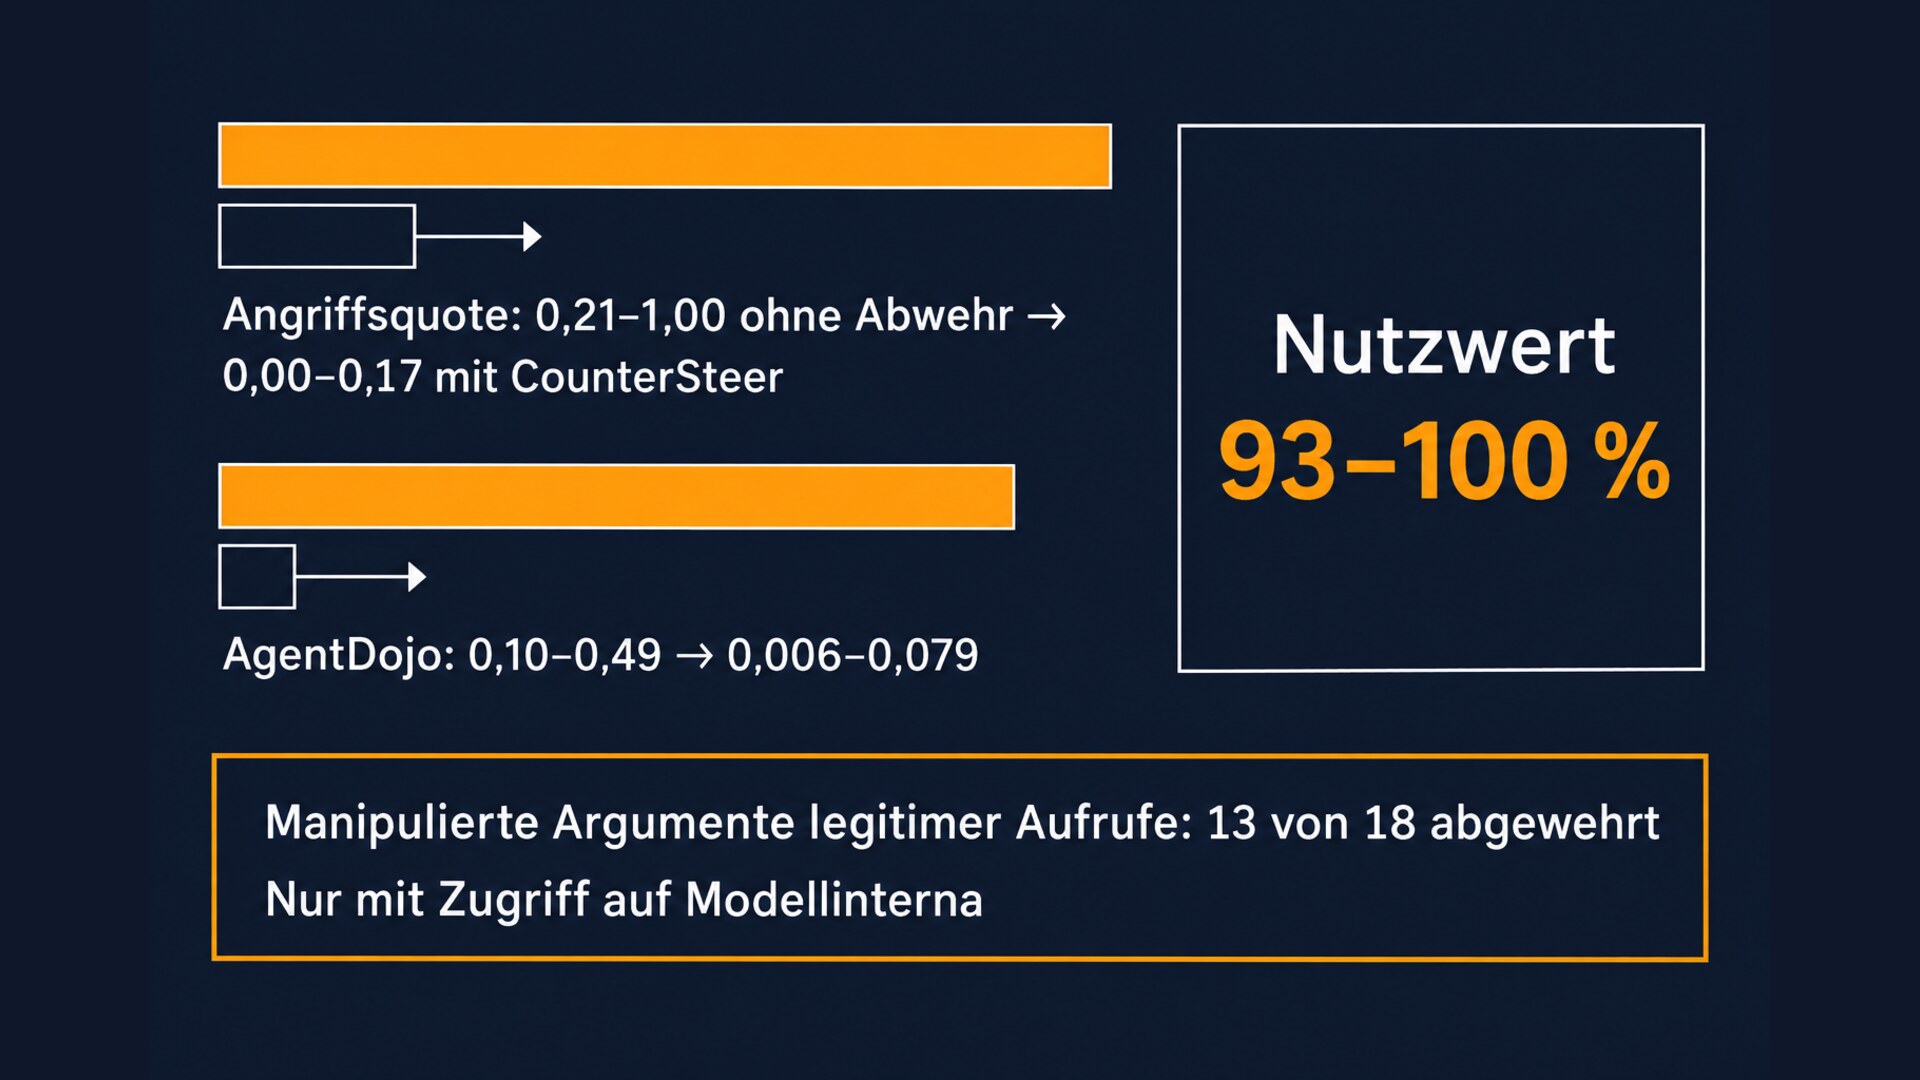
An fünf Modellen mit offenen Gewichten (8 bis 106 Milliarden Parameter, fünf Herstellerlinien) sank die Angriffsquote auf zurückgehaltenen Testdaten von 0,21–1,00 auf 0,00–0,17. Die Kompromittierungsrate in AgentDojo fiel von 0,10–0,49 auf 0,006–0,079. Der Nutzwert bei harmlosen Aufgaben blieb bei 93–100 Prozent, mit höheren aufgabenabhängigen Kosten, wenn das Modell über die veränderten Inhalte schlussfolgern muss. Keiner von 2.052 nachgespielten Angriffen menschlicher Red-Teams war erfolgreich.4
Wichtiger für die Praxis sind die Grenzen. Erstens braucht CounterSteer Zugriff auf die Modellinterna und die Grenzen der Werkzeugergebnisse im Kontext. Das geht nur bei selbst betriebenen Modellen, nicht bei Modellen, die über eine API eines Anbieters genutzt werden. Zweitens wehrt die Methode Parametermanipulation nur teilweise ab: Wählt der Angreifer die Argumente eines sonst legitimen Werkzeugaufrufs, hielt CounterSteer in 13 von 18 Fällen stand. Nach der Analyse des Autors lässt sich diese Entscheidung erst beim Ausgeben der Argumente aus den Aktivierungen ablesen, nicht an den untersuchten früheren Stellen, und die getestete Steuerung beseitigt sie nicht. Russinovich leitet daraus selbst die Forderung nach Kontrollen der Argument-Herkunft ab.4
Konsequenz für Betreiber
Die drei Befunde bestätigen, was ASD und NCSC im September formuliert haben: Die wirksamen Kontrollen liegen im Harness, nicht im Modell, und bei selbst betriebener Inferenz auch im Netz darunter. Daraus folgen vier Prüfpunkte:
- Ausgangsverkehr der Abrufwerkzeuge kontrollieren: LLMLeak braucht nur, dass ein Abrufwerkzeug beliebige Domains auflösen und aufrufen darf. Eine Allowlist für Ziele, die Protokollierung von DNS-Anfragen und aufgerufenen URLs und Aufmerksamkeit für ungewöhnlich lange Subdomains oder Pfade setzen dort an, wo der Abfluss tatsächlich passiert. Ein Eingabefilter sieht ihn nicht.
- Netzsperre nicht als Endpunkt behandeln: Wer Entwicklungsrechner vom Internet abschottet, der dort laufende Assistent aber frei abrufen darf, hat eine Hintertür in die eigene Sperre gebaut. Die Regeln für den Assistenten müssen so streng sein wie die für die Programme, die er unterstützt.
- LightLLM-Knoten im Modus
visual_onlyabschotten: Laut Threat Frontier gibt es keinen Startparameter, um den Dienst an localhost zu binden. Bis zu einem Fix bleiben eine Firewall-Regel, die den visuellen RPyC-Port nur für die LightLLM-Knoten öffnet, die ihn brauchen, ein abgetrenntes Netzsegment ohne eingehenden Weg aus dem Internet oder aus Nutzernetzen, ein Dienstkonto ohnesudo- unddocker-Rechte und die Überwachung unerwarteter Verbindungen und Kindprozesse.5 Der Melder nennt als richtige Korrektur,allow_picklezu entfernen, an localhost zu binden und Argumente gegen ein festes Schema zu prüfen.3 - Argumente von Werkzeugaufrufen gegen ihre Herkunft prüfen: Auch eine Abwehr im Modell lässt manipulierte Argumente legitimer Aufrufe teilweise durch. Empfänger, Beträge und Ziele sollten vor der Ausführung daraufhin geprüft werden, ob sie vom Nutzer stammen oder aus einem Werkzeugergebnis. Wer Modelle selbst betreibt, kann CounterSteer als zusätzliche Schicht erwägen, aber nicht als Ersatz für Rechtebeschränkung.
Quellen
- Pegoraro, Merx, Rieger, Sadeghi: The Innocent Courier: Covert Exfiltration Through Legitimate LLM Web Fetching, arXiv:2610.01768, 01.10.2026. https://arxiv.org/abs/2610.01768 ↩
- VulnCheck: LightLLM through 1.2.0 Unauthenticated Remote Code Execution via Visual-Only RPyC Service (CVE-2026-103395), 30.09.2026. https://www.vulncheck.com/advisories/lightllm-through-1.2.0-unauthenticated-remote-code-execution-via-visual-only-rpyc-service ↩
- ModelTC/LightLLM, Issue #1610: Unauthenticated RCE via pickle deserialization in the visual_only RPyC service, GitHub, 30.09.2026, abgerufen 10.10.2026. https://github.com/ModelTC/LightLLM/issues/1610 ↩
- Russinovich: CounterSteer: Suppressing Indirect Prompt Injection with Activation Steering, arXiv:2609.36570, 29.09.2026. https://arxiv.org/abs/2609.36570 ↩
- Kim: LightLLM Visual Nodes Expose Unauthenticated Pickle RCE (CVE-2026-103395), With No Fix Yet, Threat Frontier, 03.10.2026. https://threatfrontier.com/articles/lightllm-visual-rpyc-pickle-rce-cve-2026-103395 ↩