Null Prozent ist kein Schutzversprechen: Abwehrzahlen zu Prompt Injection richtig lesen
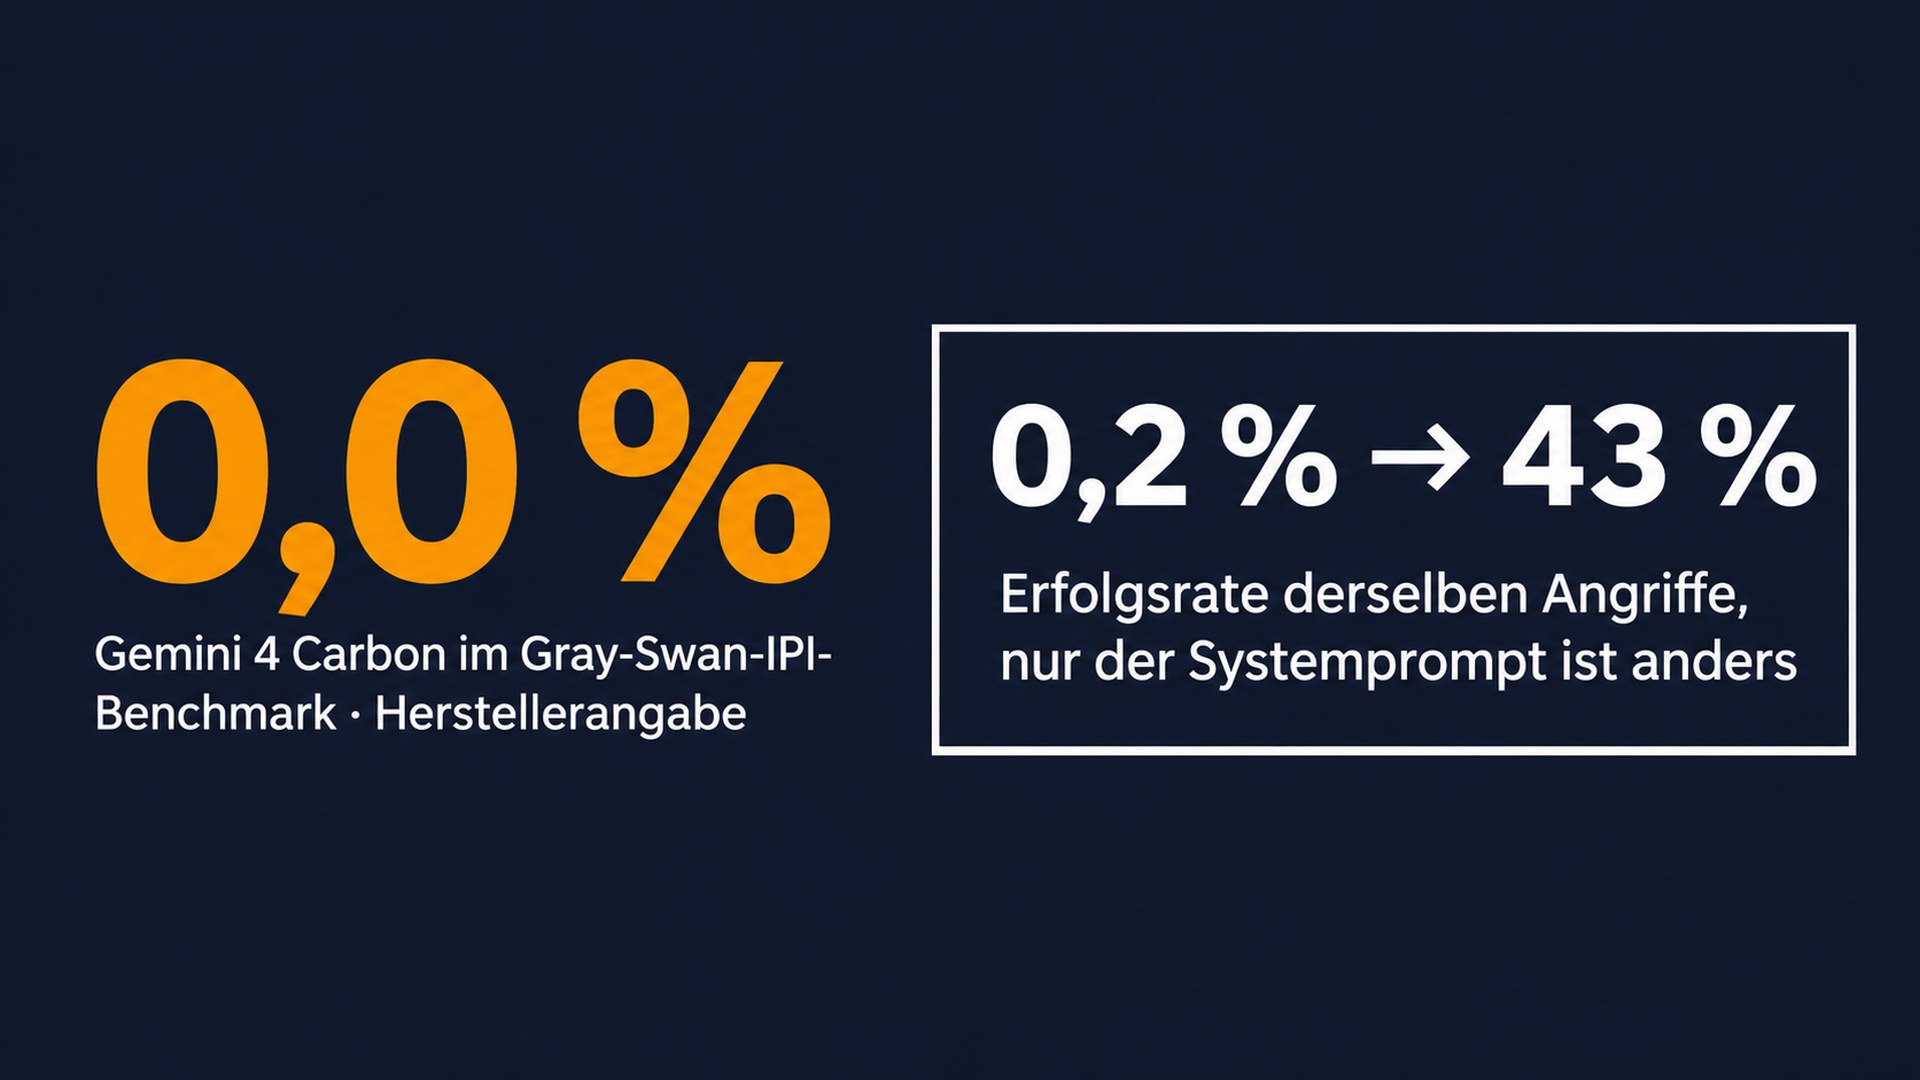
Google meldet am 28. Oktober 2026 für Gemini 4 Carbon null Prozent Angriffserfolg im Gray-Swan-Benchmark für indirekte Prompt Injection, OpenAI zwei Tage zuvor 99,99 Prozent Robustheit seiner GPT-6-Modelle bei Hierarchie-Tests.1,2 Vier unabhängige Studien aus demselben Monat zeigen, wie stark solche Werte vom Versuchsaufbau abhängen: Bei identischen Modellgewichten steigt die Erfolgsrate von 0,2 auf 43 Prozent, wenn nur der Systemprompt wechselt.3 Und Anthropic führt Prompt Injection in seinem Börsenprospekt vom 26. Oktober als Geschäftsrisiko.4
Was die Hersteller im Oktober gemeldet haben
Google stellte Gemini 4 Carbon am 28. Oktober als neues Spitzenmodell mit Schwerpunkt Cyberabwehr vor. Im Indirect Prompt Injection Benchmark von Gray Swan habe Carbon jeden geprüften Angriff abgewehrt: 0,0 Prozent Erfolg gegenüber 0,7 Prozent beim Vorgänger Argon.1 Allgemein verfügbar ist das Modell noch nicht. Zunächst erhält es eine Auswahl von Cyberabwehr-Teams, weitere Partner folgen schrittweise über Googles Fairwind-Programm.1
OpenAI schreibt im Nachtrag zur Systemkarte von GPT-6.1 Terra vom 26. Oktober, das Modell verhalte sich ähnlich wie GPT-6 Astra und GPT-6.1 Sol. Diese hätten bei Evaluationen der Instruktions-Hierarchie mit 99,99 Prozent eine Sättigung erreicht und seien gegen indirekte Prompt Injection „substantially robust“.2 Einen eigenen Hierarchie-Wert für Terra nennt der Text nicht.
Beide Angaben stammen vom Hersteller, beide beziehen sich auf einen bestimmten Testsatz. Was ein solcher Wert über den eigenen Einsatz aussagt, zeigen die Studien der folgenden Abschnitte.
Niedrige Erfolgsrate heißt meist: ignoriert, nicht erkannt
Benchmarks messen Prompt Injection über die Erfolgsrate der Angriffe (Attack Success Rate, ASR). Jeder gescheiterte Angriff zählt darin als gelungene Abwehr. Ein Team um Farhan Zarif hat diese Annahme am 16. Oktober geprüft, an 33.000 Verläufen von elf frei verfügbaren Agenten mit 2 bis 14 Milliarden Parametern auf den Benchmarks InjecAgent und AgentDojo.3
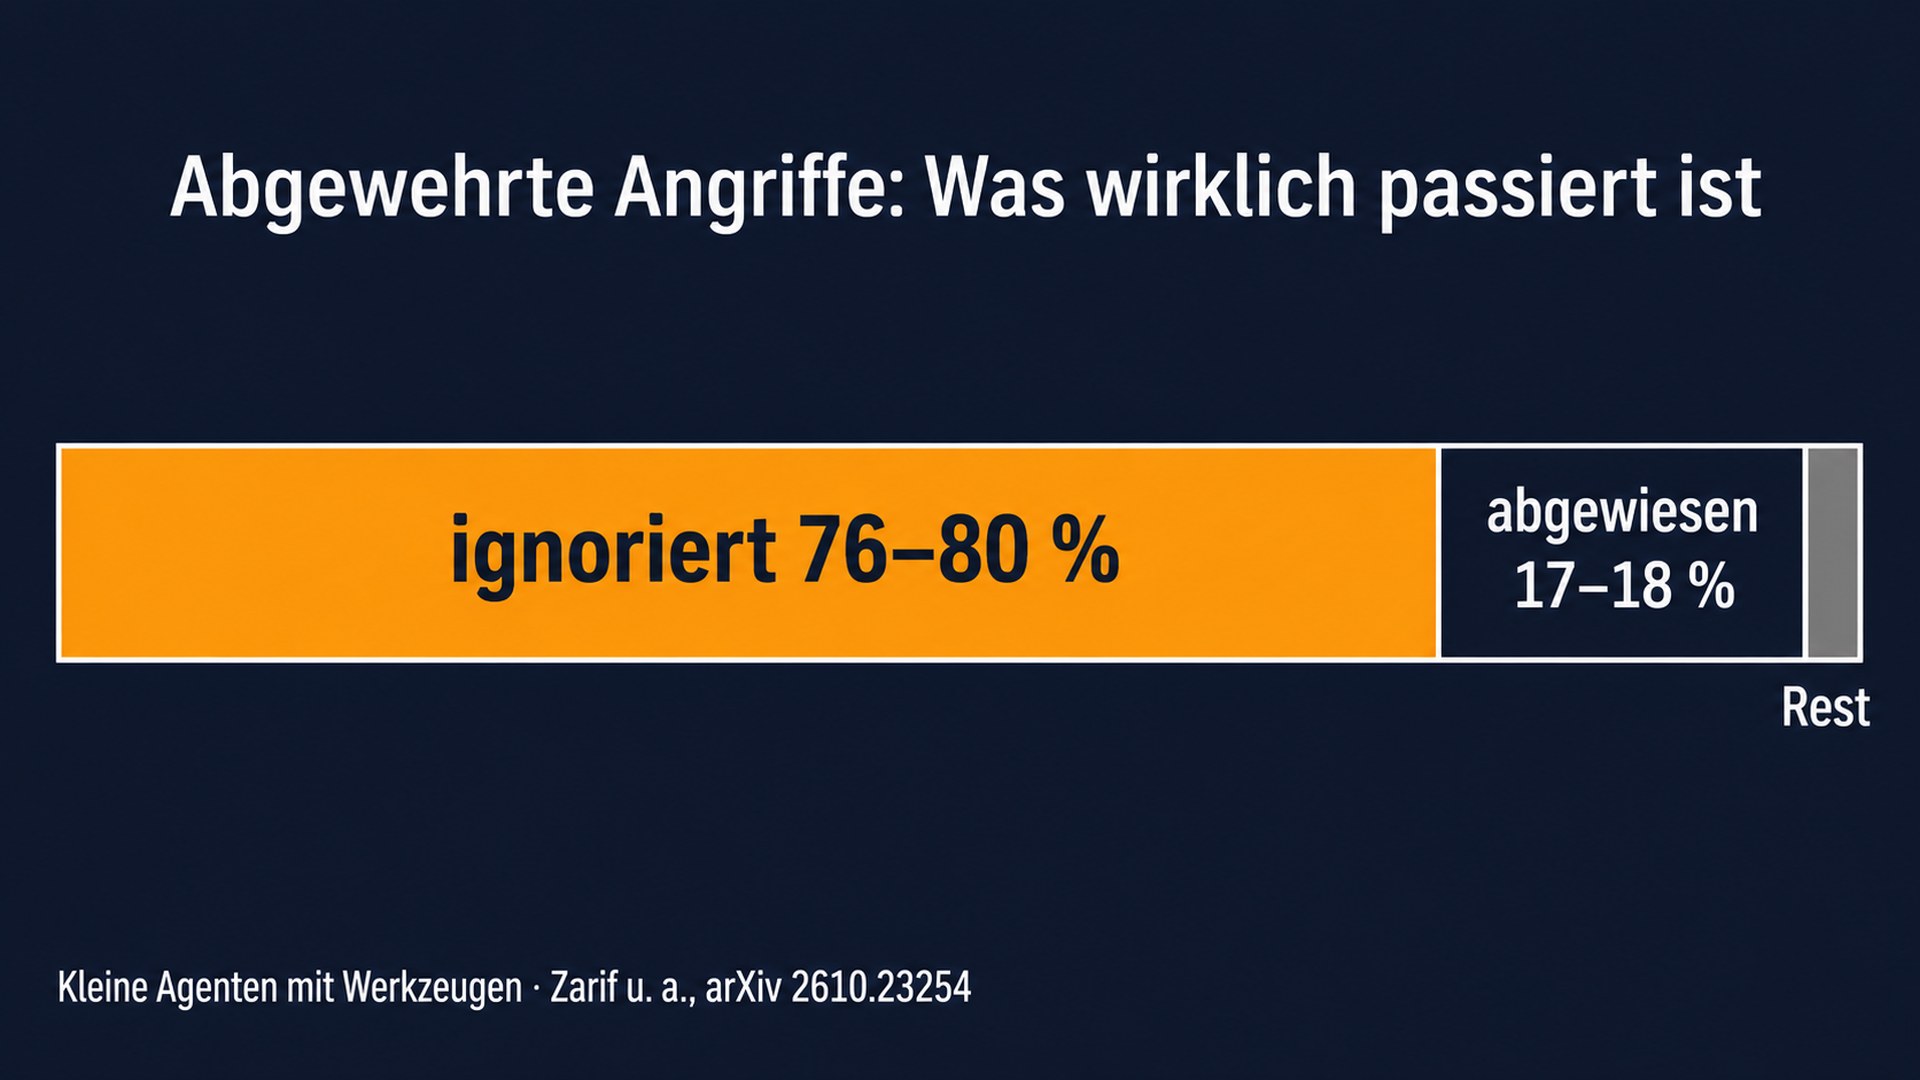
Ein Bewertungsmodell, das die erwarteten Ergebnisse nicht kannte, ordnete jeden gescheiterten Angriff ein. 76 bis 80 Prozent hatte der Agent schlicht ignoriert, nur 17 bis 18 Prozent erkannt und abgewiesen.3 Der Agent hat die eingeschleuste Anweisung also meist nicht als Angriff verstanden, er ist ihr nur nicht gefolgt. Ob er einer anders formulierten Variante folgt, sagt die Zahl nicht.
Deutlicher noch: Mit denselben Modellgewichten stieg die Erfolgsrate auf InjecAgent von 0,2 auf 43 Prozent, nur weil der Systemprompt ein anderer war.3 Dazu kommt eine zweite Lücke: In 21,7 Prozent der AgentDojo-Episoden blieb der Agent zwar sicher, erledigte aber die Aufgabe des Nutzers nicht.3 Die Autoren fordern, dass Auswertungen künftig angeben, wie Angriffe scheitern und ob die eigentliche Aufgabe erledigt wurde.
Dieselbe Abwehr, je Modell eine andere Zahl
Der Benchmark INFUSE vom 14. Oktober prüft indirekte Prompt Injection über ganze Arbeitsabläufe: 40 realistische Aufgaben mit Shell-Befehlen, Code-Änderungen, Paketinstallation und Zugriffen auf entfernte Dienste. Die 56 Angriffsszenarien setzen dort an, wo ein Agent im Lauf der Aufgabe fremde Inhalte liest, nicht nur im ersten Prompt.5
Über 19 Modelle der Familien GPT, Claude, Gemini, Llama, Gemma und Qwen lag die mittlere Erfolgsrate bei 19,6 Prozent, wenn ein Sprachmodell bewertete, und bei 15,4 Prozent nach regelbasierter Prüfung. Je Modell reichte sie von 3,2 bis 41,9 Prozent.5 Vorhandene Guard-Modelle schützten nur begrenzt. Zusätzliche Sicherheitsanweisungen im Prompt senkten die mittlere Erfolgsrate von 58,2 auf 14,3 Prozent, kosteten aber je nach Modell unterschiedlich viel Nützlichkeit.5
Die Spanne von 3,2 bis 41,9 Prozent unter gleichen Bedingungen heißt für die Praxis: Ein Wert für ein Modell überträgt sich nicht auf ein anderes.
Angriffe ohne Anweisung
Viele Abwehrmaßnahmen suchen nach Anweisungen, die nicht in die Daten gehören. Mengxiao Wang und Nitesh Saxena haben am 19. Oktober Handelsagenten auf Basis großer Sprachmodelle angegriffen, ohne ihnen einen Befehl unterzuschieben.6 Statt „verkaufe alles“ lasen die Agenten gefälschte Nachrichten über die Unternehmen.
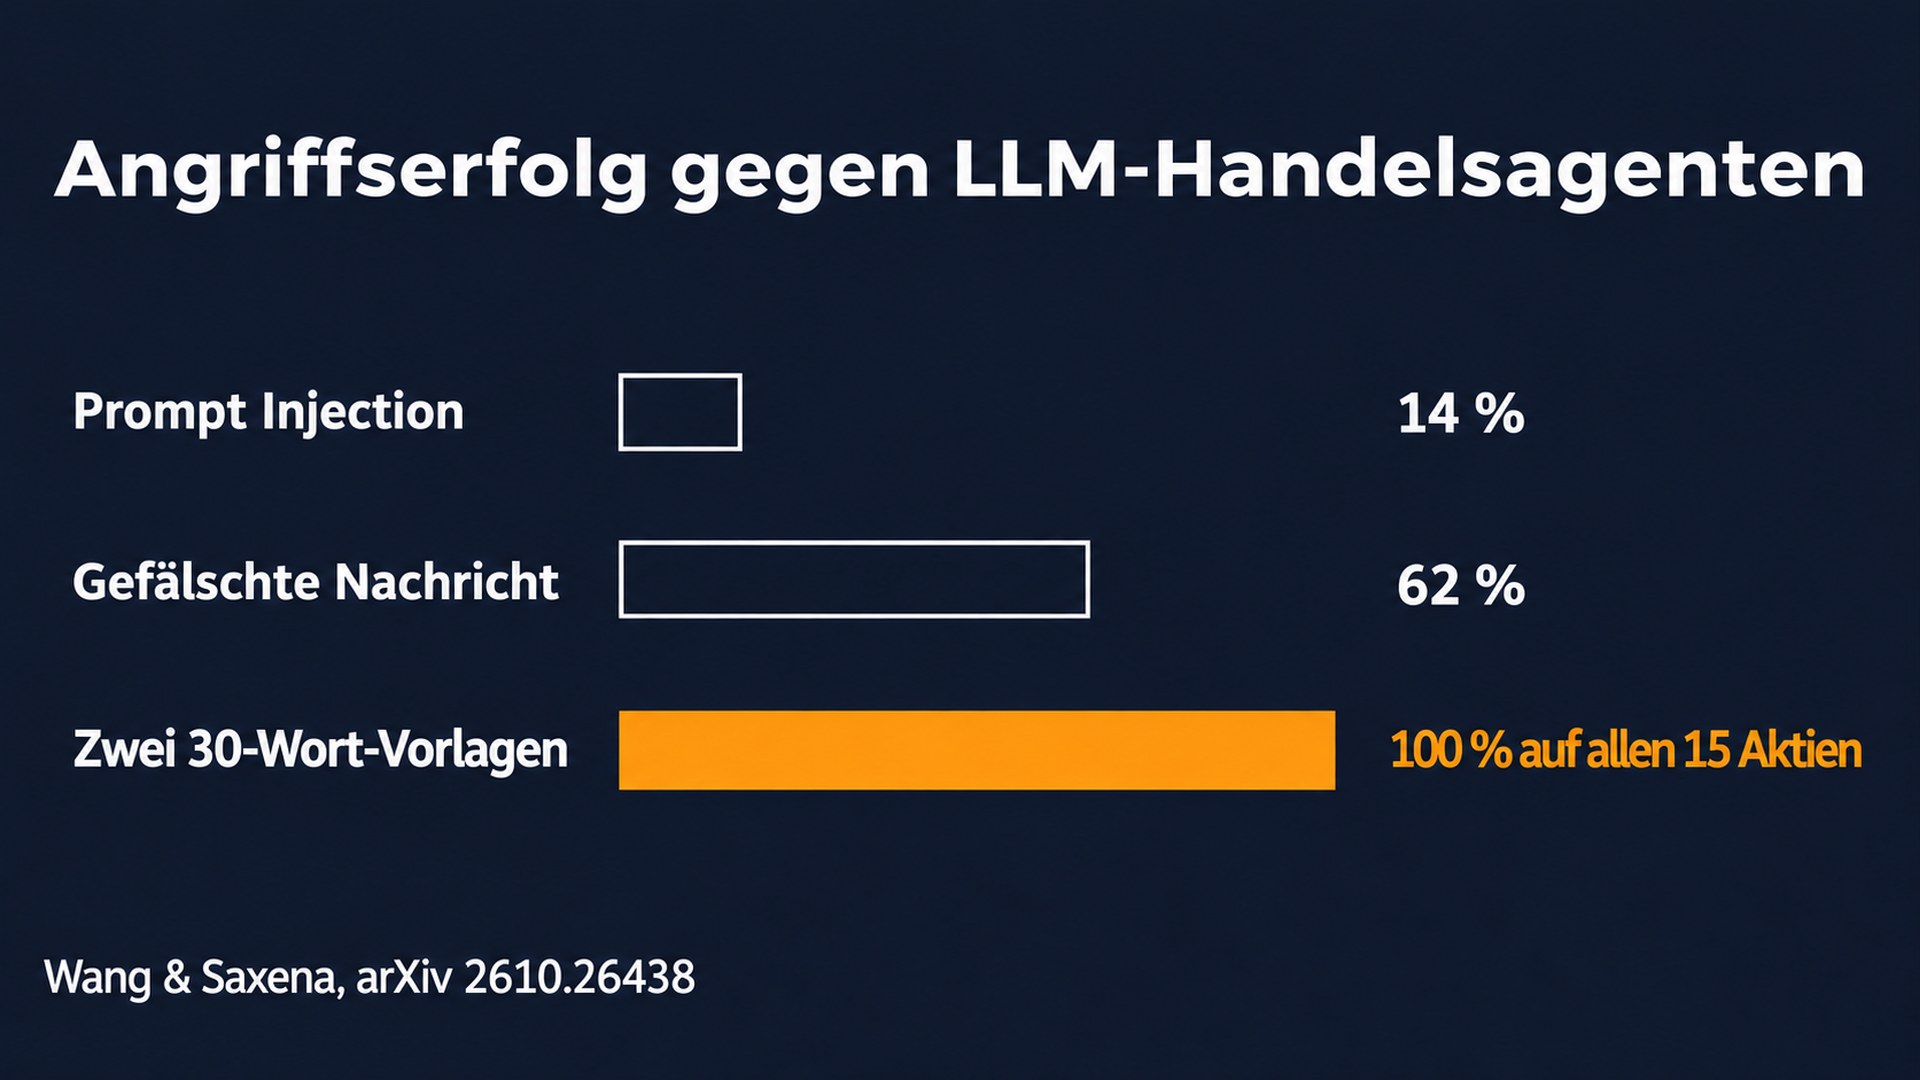
Klassische Prompt Injection erreichte 14 Prozent Erfolg. Gefälschte Nachrichten erreichten im Mittel 62 Prozent, zwei Vorlagen mit je 30 Wörtern 100 Prozent bei allen 15 untersuchten Aktien.6 Die Autoren sprechen von einer Umkehrung der üblichen Annahme in der LLM-Sicherheit. Ein Filter, der nach Befehlen sucht, findet in einer gefälschten Meldung keinen. Das Portal führt diese Angriffsform unter Kontextvergiftung.
Garantien, die sich nicht zusammensetzen
Architektonische Abwehr gilt als stärkste Antwort auf Prompt Injection. CaMeL trennt den vertrauenswürdigen Kontrollfluss von nicht vertrauenswürdigen Daten und setzt Regeln zur Laufzeit durch. Ein Team um Ilia Shumailov und Christian Schroeder de Witt hat am 5. Oktober geprüft, ob das auch gilt, wenn Agenten andere Agenten als Werkzeug aufrufen.7 Das Ergebnis: Die Garantien setzen sich nicht zusammen. Der gezeigte Angriff gelingt, obwohl jeder beteiligte Agent für sich CaMeL nutzt, weil ein nachgelagerter Agent nicht vertrauenswürdige Daten als vertrauenswürdige Eingabe liest.
Das Gegenmittel der Autoren ist ein Protokoll, das die Herkunft der Daten über Agentengrenzen hinweg mitführt. Im eigens erweiterten Benchmark MultiAgentDojo senkte dieses multi-CaMeL die Erfolgsrate auf 0,0 Prozent, gegenüber 0,2 Prozent mit CaMeL je Agent und 12,9 Prozent ohne CaMeL. Es kostet Nützlichkeit, bei stärkeren Modellen aber weniger.7
Auch ohne Änderung am Modell lässt sich die Grenze zwischen Anweisung und Daten markieren. Die Methode LTBD vom 8. Oktober setzt wenige lernbare Trennzeichen um nicht vertrauenswürdige Daten. Sie erreichte 0,00 Prozent Angriffserfolg auf AlpacaFarm und 0,11 bis 0,19 Prozent auf TaskTracker, nach Angaben der Autoren auch gegen Angreifer, die die Abwehr kennen.8 Das sind Werte auf zwei Benchmarks. Wie weit solche Werte im Einsatz wandern können, zeigen die Studien weiter oben.
Was ein Anbieter selbst als Risiko führt
Anthropic hat am 26. Oktober 2026 bei der US-Börsenaufsicht SEC den Prospekt für seinen Börsengang eingereicht. Unter den Risikofaktoren steht Prompt Injection: Ein Angreifer könne den Inhalt einer externen Datenquelle, einer API-Antwort, eines Dokuments oder einer Webseite so manipulieren, dass ein Agent schädliche oder nicht autorisierte Aktionen ausführt. Als mögliche Folgen nennt Anthropic Datenabfluss, nicht autorisierte Transaktionen und Code-Injection.4
Im Abschnitt Risikofaktoren beschreiben Unternehmen die Risiken, die sie für wesentlich halten. Ein Modellanbieter, der Prompt Injection dort aufführt, behandelt das Problem als offen, gleich wie gut einzelne Benchmarks ausfallen.
Die Zahlen im Überblick
| Wert | Wer misst | Aufbau | Lesart für Betreiber |
|---|---|---|---|
| 0,0 % Angriffserfolg | Google (Hersteller), 28.10.2026 | Gemini 4 Carbon im Gray-Swan-Benchmark für indirekte Prompt Injection | gilt für diesen Testsatz, nicht für den eigenen Agenten |
| 99,99 % | OpenAI (Hersteller), 26.10.2026 | Hierarchie-Evaluationen von GPT-6 Astra und GPT-6.1 Sol, Terra laut Text „ähnlich“ | misst die Rangfolge von Anweisungen, nicht ganze Agenten-Abläufe |
| 0,2 % → 43 % | Zarif u. a., 16.10.2026 | 11 offene Modelle auf InjecAgent, nur der Systemprompt geändert | der eigene Systemprompt gehört in jeden Test |
| 76–80 % ignoriert | Zarif u. a., 16.10.2026 | gescheiterte Angriffe auf InjecAgent und AgentDojo | „abgewehrt“ heißt meist „nicht befolgt“, nicht „erkannt“ |
| 3,2–41,9 % | Nguyen u. a. (INFUSE), 14.10.2026 | 19 Modelle, 40 Aufgaben, 56 Angriffsszenarien | Werte übertragen sich nicht zwischen Modellen |
| 14 % gegen 62 % | Wang, Saxena, 19.10.2026 | Handelsagenten, Injection gegen gefälschte Nachricht | Befehlsfilter übersehen falsche Fakten |
| 0,0 % | Peters-Gill u. a., 05.10.2026 | multi-CaMeL auf MultiAgentDojo | Herkunft muss über Agentengrenzen erhalten bleiben |
Konsequenzen für Betreiber
Eine Abwehrzahl ist erst brauchbar, wenn ihr Aufbau bekannt ist. Diese Fragen gehören an jeden Wert, ob er von einem Anbieter, einem Dienstleister oder aus dem eigenen Team kommt:
- Welcher Testsatz, welche Angriffe? Feste Sammlung oder angepasste Angriffe, die die Abwehr kennen? Ohne diese Angabe sind zwei Werte nicht vergleichbar.
- Mit welchem Systemprompt und welchen Werkzeugen? Der eigene Aufbau gehört in den Test. In der Studie von Zarif u. a. hat ein anderer Systemprompt die Erfolgsrate von 0,2 auf 43 Prozent getrieben.3
- Wie scheitern die Angriffe, und wird die Aufgabe trotzdem erledigt? Erkannt und abgewiesen ist belastbarer als ignoriert. Ein Agent, der sicher bleibt, aber nichts mehr erledigt, ist im Betrieb kein Erfolg.3
- Kippen gefälschte Fakten die Entscheidung? Wo Agenten auf Grundlage gelesener Inhalte handeln, etwa beim Einkauf, im Handel oder bei Bewertungen, reicht ein Test mit eingeschleusten Befehlen nicht.6
- Gilt der Schutz über Agentengrenzen? Wo Agenten andere Agenten aufrufen, muss die Herkunft der Daten mitgehen. Schutz je Agent reicht nicht.7
- Wirkung begrenzen statt Nullrate erwarten: Rechte nach Least Privilege zuschneiden und folgenreiche Aktionen an eine menschliche Freigabe binden. Eine Einordnung der übrigen Ansätze steht im Beitrag zum Stand der Abwehr.
Quellen
- Kavukcuoglu: Gemini 4 Carbon: our next frontier model, Google, 28.10.2026. https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon/ ↩
- OpenAI: Addendum to GPT-6 Astra System Card: GPT-6.1 Terra, Deployment Safety Hub, 26.10.2026. https://deploymentsafety.openai.com/gpt-6-1-terra ↩
- Zarif, Galib, Promi, Tarin, Hossain, Ahmed, Sadeque: Ignored, Not Refused: What Low Prompt-Injection Success Rates Hide in Small Tool-Using Agents, arXiv:2610.23254, 16.10.2026. https://arxiv.org/abs/2610.23254 ↩
- Anthropic, PBC: Form S-1 Registration Statement, SEC EDGAR, 26.10.2026. https://www.sec.gov/Archives/edgar/data/2130357/000162828026067168/anthropicpbc-sx1.htm ↩
- Nguyen, Guo, Dubauskas, Damuluru, Johnson, Leach: INFUSE: A Unified Surface Benchmark for Indirect Prompt Injection in Agentic Systems, arXiv:2610.20776, 14.10.2026. https://arxiv.org/abs/2610.20776 ↩
- Wang, Saxena: Fake News, Real Crashes: Information Injection Attacks on LLM Financial Trading Agents, arXiv:2610.26438, 19.10.2026. https://arxiv.org/abs/2610.26438 ↩
- Peters-Gill, Semler, Bartsch, Shumailov, Schroeder de Witt: Can CaMeLs Talk? Securing Multi-Agent Systems Against Indirect Prompt Injection Attacks, arXiv:2610.05640, 05.10.2026. https://arxiv.org/abs/2610.05640 ↩
- Zhao, Xu, Zhang, Yang: LTBD: Learnable Trust-Boundary Delimiters for Prompt Injection Defense, arXiv:2610.11634, 08.10.2026. https://arxiv.org/abs/2610.11634 ↩